位置编码决定左右?Qwen与InternVL视觉模型的反事实实验
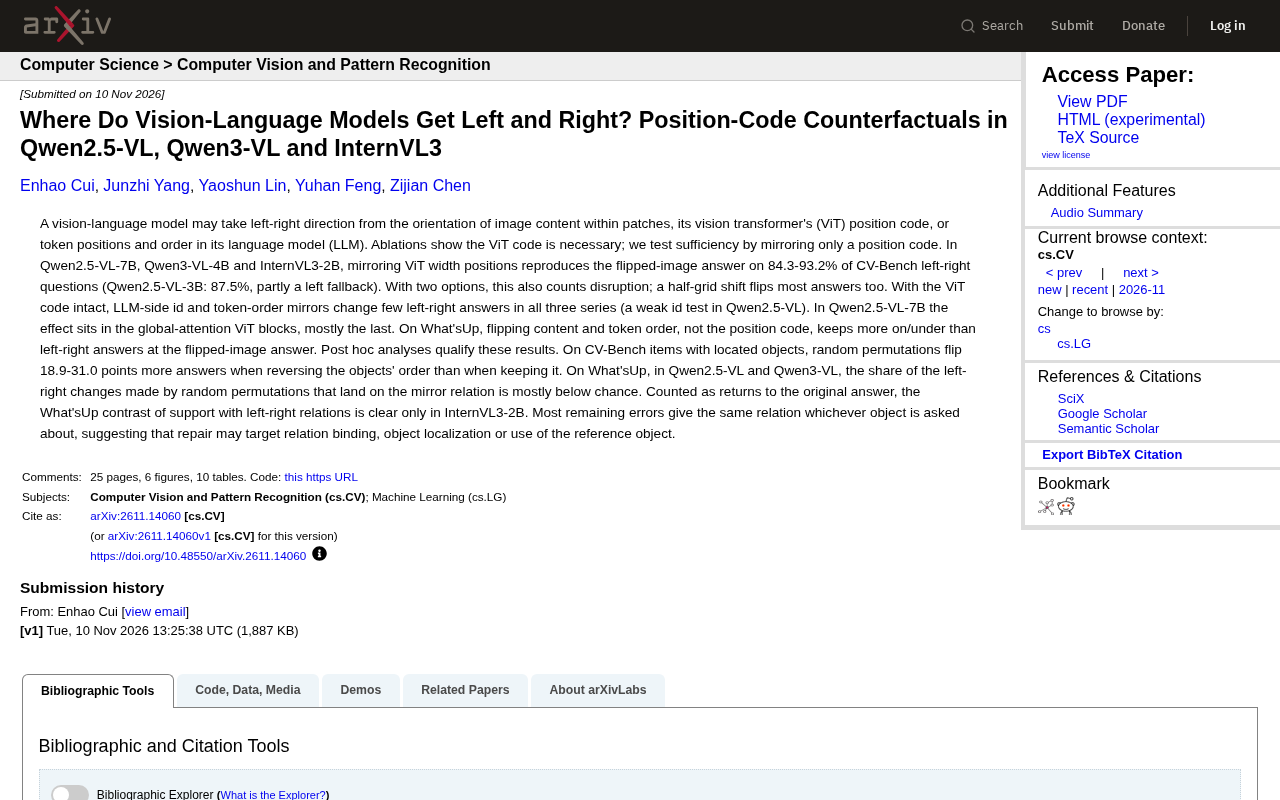
反事实实验表明,视觉语言模型的左右判断主要依赖ViT位置编码,而非语言模型词序。
该研究通过镜像ViT宽度位置码的反事实实验,检验视觉语言模型左右方向判断的机制来源。在Qwen2.5-VL、Qwen3-VL和InternVL3上,镜像位置码可复现84.3%–93.2%的翻转图像答案,而LLM端的id镜像和token顺序镜像几乎无效,效应集中在ViT最后一个全局注意力块。但在What'sUp数据集上,上下和支撑关系更依赖内容朝向与词序,表明不同空间关系走不同信息通路。剩余错误多表现为关系绑定失败,提示修复策略需按关系类型区分。
视觉语言模型如何判断“左边”和“右边”?一项针对Qwen2.5-VL、Qwen3-VL和InternVL3的反事实实验给出了出人意料的答案:左右方向很可能主要来自视觉Transformer(ViT)的位置编码,而非语言模型端的词序或ID逻辑。
三条可能路径:内容朝向、ViT位置码与LLM词序
研究者在开篇提出了视觉语言模型判断左右方向的三条候选机制:图像内容在图像块(patch)中的朝向、ViT的位置编码,以及语言模型(LLM)中的token位置与顺序。消融实验已经表明ViT位置编码是必要条件,但“必要”不等于“充分”。为此,作者设计了一个更精细的检验:只对位置编码做镜像操作,看能否单独翻转模型的左右答案。
如果镜像位置码就足以复现“翻转图像后的答案”,说明位置编码在这条判断链路上起到了支配作用。这个设计把“必要条件”推进到“充分性”的验证,也是理解多模态模型空间推理内部机制的关键一步。
视觉Transformer(ViT)与位置编码
ViT将图像切分为固定大小的图块(patch),每个图块经线性投影后得到一个特征向量,但自注意力本身对顺序不敏感,因此必须额外注入位置信息。常见做法是学习式绝对位置编码(如原始ViT)或二维插值的正弦位置编码(如Qwen2.5-VL所用),后者在宽度和高度两个方向上分别生成编码并相加。这些位置码在每一层ViT块中与内容特征融合,使模型能够区分“左图块”与“右图块”。镜像宽度方向的位置码,等价于告诉模型“图像左右翻转了”,但像素内容并未改变,从而可以单独检验位置码对左右判断的因果作用。
镜像ViT宽度位置,绝大多数左右答案被翻转
实验在Qwen2.5-VL-7B、Qwen3-VL-4B和InternVL3-2B上进行。镜像ViT的宽度方向位置后,模型在CV-Bench左右题上复现翻转图像答案的比例达到84.3%–93.2%;Qwen2.5-VL-3B为87.5%,但部分属于“左”方向的回退现象。
由于题目只有两个选项,这一比例同时也可以理解为答案被扰动的比例。研究者还发现,将位置网格做半格偏移,同样会翻转大部分答案。这说明ViT位置码对左右判断的影响不是边缘性的,而是直接决定性的。
LLM侧镜像几乎无效
与ViT侧形成鲜明对比的是,在ViT位置码保持不变的情况下,对LLM端的id镜像和token顺序镜像,在三个模型系列中只改变了极少数左右答案。Qwen2.5-VL中的id测试本身较弱,即便如此也未观察到明显效应。这一不对称结果进一步把左右判断的“责任”指向视觉侧的位置编码。
效应集中在全局注意力ViT块,主要是最后一层
在Qwen2.5-VL-7B上,研究者定位了效应的来源:它集中在ViT的全局注意力块中,且主要落在最后一个块。这一发现对模型修复有直接启示——如果需要干预左右判断,目标层应当定位于这一区域,而不是语言模型端的token处理。
全局注意力与局部注意力
在Qwen2.5-VL等现代ViT架构中,注意力常被划分为全局块和局部块:全局块允许所有图块两两交互,捕捉长程依赖;局部块则限制在窗口内,侧重细粒度特征。左右关系的判断需要比较图像两侧的内容,因此天然依赖全局注意力。研究者发现效应集中在最后一个全局块,说明该层可能承担了将位置信息整合为空间关系表征的关键角色。这也解释了为何仅镜像位置码就能大幅翻转答案——最后一层的位置信号直接参与了左右决策的输出。
What'sUp上的不同图景:内容与词序更关键
在What'sUp数据集上,结论出现了分化。翻转内容与token顺序、而不翻转位置码,比翻转位置码能保留更多“on/under”答案,并且更接近翻转图像后的答案。这意味着不同空间关系依赖的机制并不一致:左右更依赖ViT位置码,而上下、支撑关系对内容朝向和词序更敏感。
这一对比提醒我们,不能把“空间推理”当作单一能力来看待。不同关系类型可能走不同的信息通路,模型修复策略也需要按关系类别区分。
What'sUp数据集与空间关系类型
What'sUp是一个专注于空间关系理解的视觉问答基准,包含“左/右”“上/下”“支撑/被支撑”等多种关系类型,题目通常涉及两个物体之间的相对位置。与CV-Bench中简单的左右二选一不同,What'sUp的关系判断更依赖对物体朝向和参考系的理解。例如“杯子在桌子上面”需要识别支撑关系,而“杯子在桌子左边”则更依赖水平位置对比。这种任务设计的差异,使得不同关系类型对位置码、内容朝向和词序的敏感度不同,从而在实验中出现结论分化。
事后分析给出的限定条件
作者对上述结果做了多项事后分析,并如实呈现了其中的复杂性。在CV-Bench中带有定位对象的题目上,随机排列在反转对象顺序时,比保持顺序时多翻转18.9–31.0个百分点的答案。在What'sUp上,Qwen2.5-VL和Qwen3-VL中,随机排列造成的左右变化落在镜像关系上的比例大多低于随机水平。若以“回到原始答案”计算,What'sUp上支撑关系与左右关系的对比只在InternVL3-2B中清晰可见。
剩余错误中,多数情况下无论问及哪个对象都给出相同关系,这提示修复方向可能应指向关系绑定、对象定位或参考对象的使用,而非单纯的位置编码调整。
对模型修复与评测的启示
这项工作的价值不只在于定位了一个机制,更在于给出了可操作的诊断框架。多源交叉的消融与反事实测试表明,ViT位置码是左右判断的主要载体,但这一结论受数据集和关系类型限定。对于开发者而言,针对空间推理的失败案例,先区分是左右类还是上下类问题,再决定是调整视觉位置编码还是改进对象绑定,可能比笼统地“加数据”更有效。评测侧同样需要警惕:单一数据集的结论不宜直接外推到所有空间关系。
相关推荐

Pi Agent凭什么爆火?极简内核+可扩展的AI编程新思路
Pi Agent 为何在 AI 编程工具赛道脱颖而出?本文解析其极简内核、按需扩展的设计哲学,对比 Cloud Code、Codex 等主流工具的功能膨胀困境,探讨开发者自主控制 agent 的价值与轻量路线的取舍。

Claude Code用量总提前耗尽?7个技巧让额度撑更久
Claude Code额度总提前耗尽?本文整理七个实用技巧:切换到新任务时使用 slash clear、按任务选择Sonnet或Opus、调低effort等级、精简CLAUDE.md、关闭不用的MCP服务器、plan mode先规划、用slash usage定位消耗源头,帮助你延长用量额度的使用时间。

Cursor多智能体协作:浏览器扩展里看AI设计网站
YouTube短视频展示了多光标AI智能体在浏览器中协作设计网站的画面,其载体为浏览器扩展而非独立平台。本文梳理该演示的关键细节、信息缺口及其反映的多智能体协作趋势。