文生图模型训练提速3.6倍:技术路径与意义解析
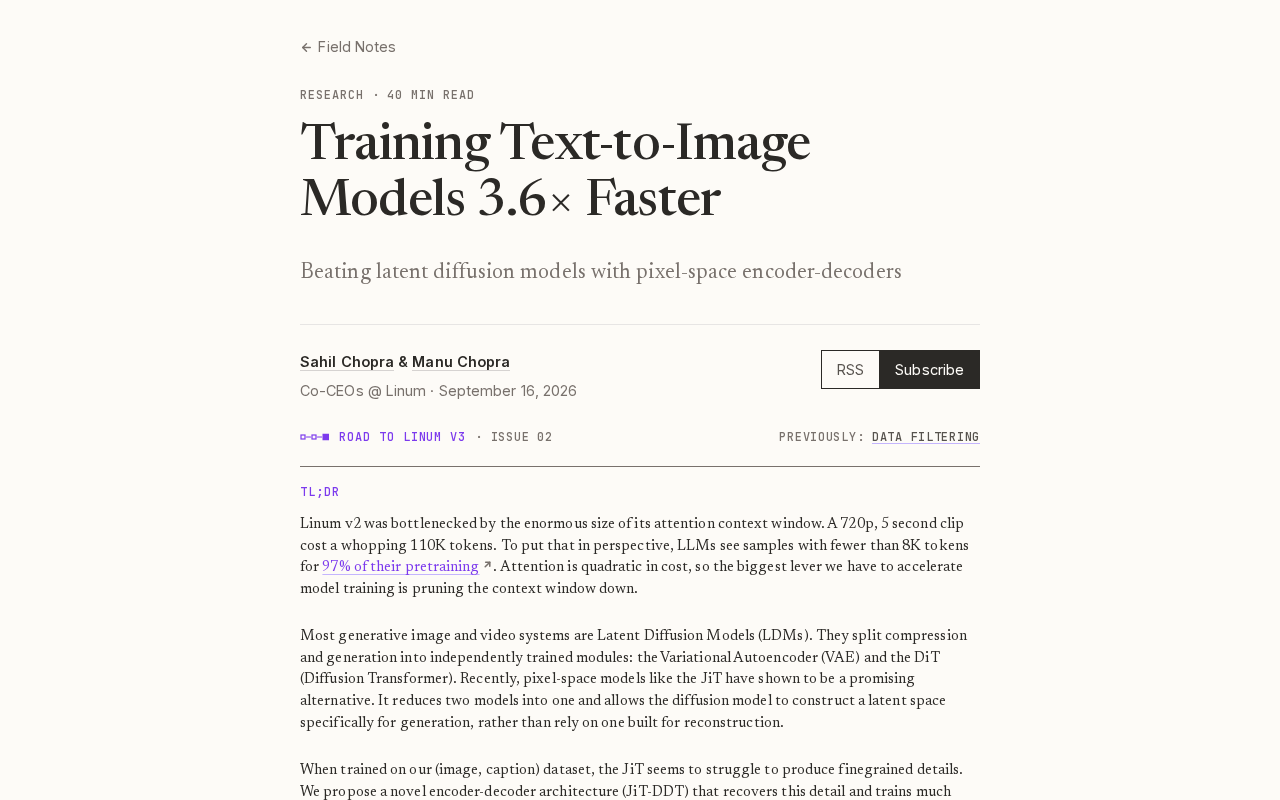
一则技术分享声称将文生图模型训练速度提升3.6倍,但缺乏验证,文章梳理了常见加速路径并呼吁审慎看待。
文章围绕一则在Hacker News上流传的技术分享展开,该分享声称将文本到图像生成模型的训练速度提升至原来的3.6倍。作者首先量化了这一加速比的实际意义——对应训练时间和算力成本压缩至约三分之一,并能显著加快研发迭代节奏。随后,文章系统梳理了实现此类加速的三类主流技术路径:扩散过程与训练目标优化(如一致性模型、改进噪声调度)、计算效率优化(如FlashAttention、混合精度训练)以及数据管线与分布式训练优化。在肯定训练效率提升的行业价值之余,文章特别指出该信息社区关注度低、缺乏基准测试和复现文档,提醒读者保持审慎,等待更完整的技术细节和独立验证后再作判断。
引言:文生图训练的成本困境
文本到图像(Text-to-Image)生成模型近年来成为AI领域最受关注的方向之一,从Stable Diffusion到各类扩散模型,其视觉生成能力不断突破。然而,这类模型的训练成本一直居高不下——动辄需要数百甚至上千张GPU、消耗大量算力和时间。对于研究机构和中小团队而言,高昂的训练门槛始终是一道难以逾越的障碍。
一则在Hacker News上出现的技术分享提出了一个引人注目的说法:将文生图模型的训练速度提升至原来的3.6倍。如果这一效率提升能够在真实场景中稳定复现,它对整个行业的意义不容小觑。
3.6倍加速意味着什么
训练速度提升3.6倍,直接对应的是时间与成本的大幅压缩。假设一个模型原本需要36天完成训练,加速后仅需约10天即可完成;原本需要花费的算力预算,也可能相应下降到接近三分之一的水平。
对于依赖快速迭代的团队来说,这种加速的价值不仅在于省钱,更在于研发节奏的加快。更快的训练循环意味着可以在相同时间内尝试更多的架构调整、超参数组合和数据配比,从而更高效地探索模型性能边界。
需要说明的是,此类效率提升通常来自多方面的工程与算法优化,例如更高效的数据加载管线、混合精度训练、优化的注意力计算、更合理的采样策略,或是对扩散过程本身的重新设计。具体到该分享,原始信息量有限,尚无法确认其加速的核心技术来源。
加速背后的常见技术路径
虽然这条Hacker News帖子本身内容简短,但结合当前文生图训练优化的主流方向,可以推测几种可能实现大幅加速的技术路径:
训练目标与扩散过程优化
扩散模型的训练往往涉及大量的去噪步骤。通过改进噪声调度、采用更高效的损失函数,或引入一致性模型(Consistency Models)等新范式,可以在减少训练步骤的同时保持生成质量。
一致性模型(Consistency Models)是OpenAI于2023年提出的一类新型生成范式,旨在克服传统扩散模型推理慢的缺陷。传统扩散模型需要经过数十乃至数百步去噪迭代才能生成图像,而一致性模型通过在训练时直接学习"任意噪声步骤到原始数据"的映射,使得模型理论上可以一步完成生成。在训练侧,这一设计同样可以减少需要模拟的去噪轨迹长度,从而降低单次训练迭代的计算量。此外,噪声调度(Noise Schedule)的设计对训练效率影响显著——更激进的调度策略可以让模型在更少的步骤内覆盖足够多样的噪声水平,减少冗余计算。Flow Matching等替代训练目标也展示出比传统DDPM更快的收敛速度,是近期训练加速研究的热点方向。
计算效率优化
包括使用FlashAttention等高效注意力实现、混合精度(FP16/BF16)训练、梯度检查点技术,以及针对GPU的算子融合。这些工程手段能够显著提升硬件利用率,减少无效计算。
FlashAttention是由斯坦福大学研究者提出的一种IO感知的注意力计算算法,其核心思想是通过分块(Tiling)计算和减少HBM(高带宽显存)读写次数来加速标准Transformer注意力机制。在扩散模型的U-Net或DiT(Diffusion Transformer)架构中,注意力层的计算往往是显存和时间的主要消耗来源,FlashAttention可在不改变数学等价性的前提下带来2-4倍的注意力层加速。梯度检查点(Gradient Checkpointing)则是一种以时间换空间的技术:训练时不保存所有中间激活值,而在反向传播时按需重算,显著降低显存占用,从而允许使用更大的批量(Batch Size),进而提升GPU利用率和整体吞吐量。两者结合使用,是目前大规模扩散模型训练的工程标配。
数据管线与分布式训练
在大规模训练中,数据加载和通信开销常常成为瓶颈。优化数据预处理、缓存机制以及多机多卡的通信策略,往往能带来可观的整体吞吐提升。
对行业的潜在影响
如果高效训练方法能够被广泛采用,最直接的受益者将是资源有限的研究者和创业团队。训练门槛的降低,有助于推动更多样化的模型探索,而不再是少数拥有海量算力的巨头独占赛道。
从更宏观的角度看,训练效率的提升也符合AI行业对可持续发展的关注。降低算力消耗不仅意味着成本下降,也意味着更小的能源足迹,这在大模型规模持续扩张的当下尤为重要。
理性看待:需要更多验证
值得提醒的是,这条分享目前的社区关注度较低(仅有个位数的点赞和评论),且缺乏详细的技术文档、基准测试和复现说明。任何关于训练加速的声明,都应建立在严谨的对照实验之上——包括加速前后的生成质量对比、在标准数据集上的量化指标,以及在不同硬件配置下的稳定性。
在AI领域,效率类声明层出不穷,但真正能够经受住社区复现检验、并被广泛采纳的方法才具有长久价值。对于这类信息,保持关注的同时也需保持审慎,等待更完整的技术细节公开后再做定论。
结语
文生图模型训练提速3.6倍的说法,指向了一个AI社区持续追求的核心目标:用更少的资源做更多的事。无论最终这一具体方法能否站得住脚,训练效率优化都将是未来生成式AI发展的关键战场之一。对于关注该领域的从业者而言,持续跟踪此类技术进展,理解其背后的原理与适用边界,才是获取真正价值的方式。
相关推荐
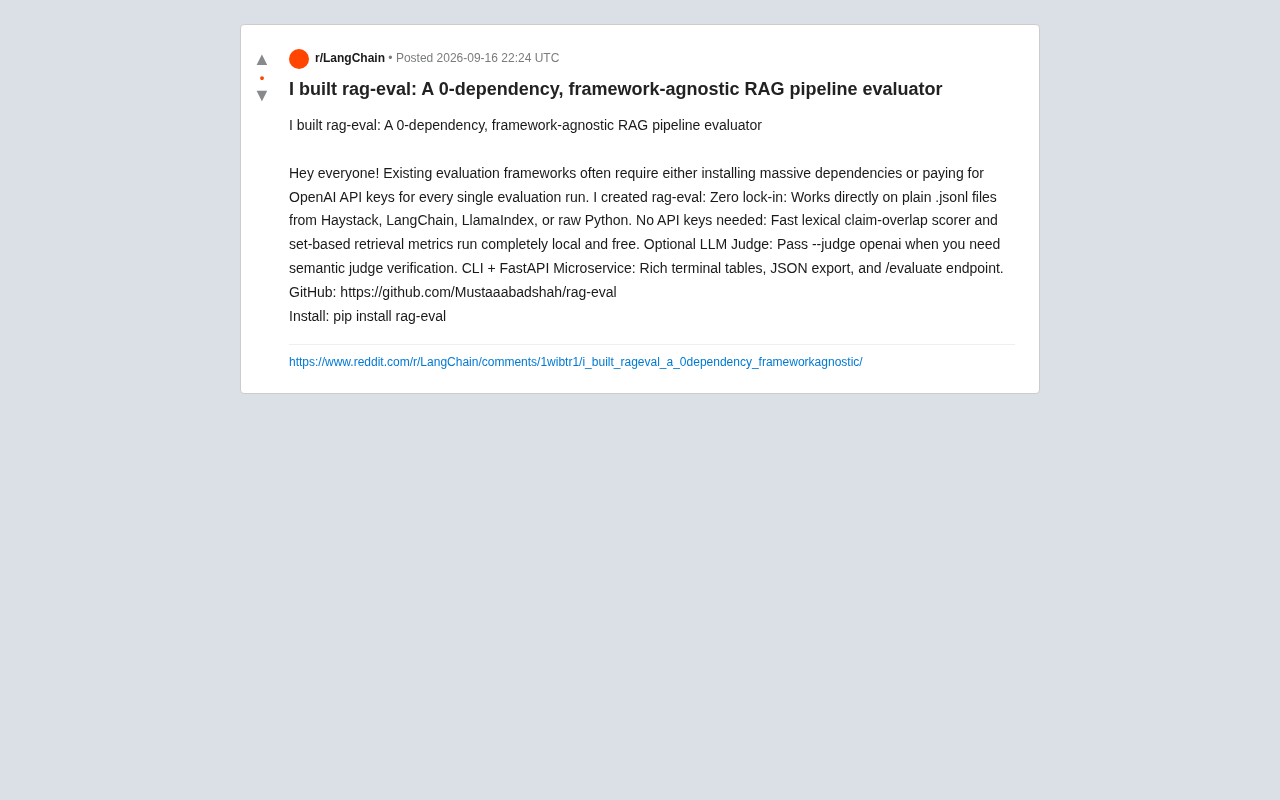
rag-eval:零依赖、无需API密钥的RAG评测工具
rag-eval 是一款零依赖、框架无关的开源RAG管线评测工具,支持本地免费的词法与检索指标,无需API密钥,并可选启用LLM Judge做语义验证,兼容Haystack、LangChain、LlamaIndex。
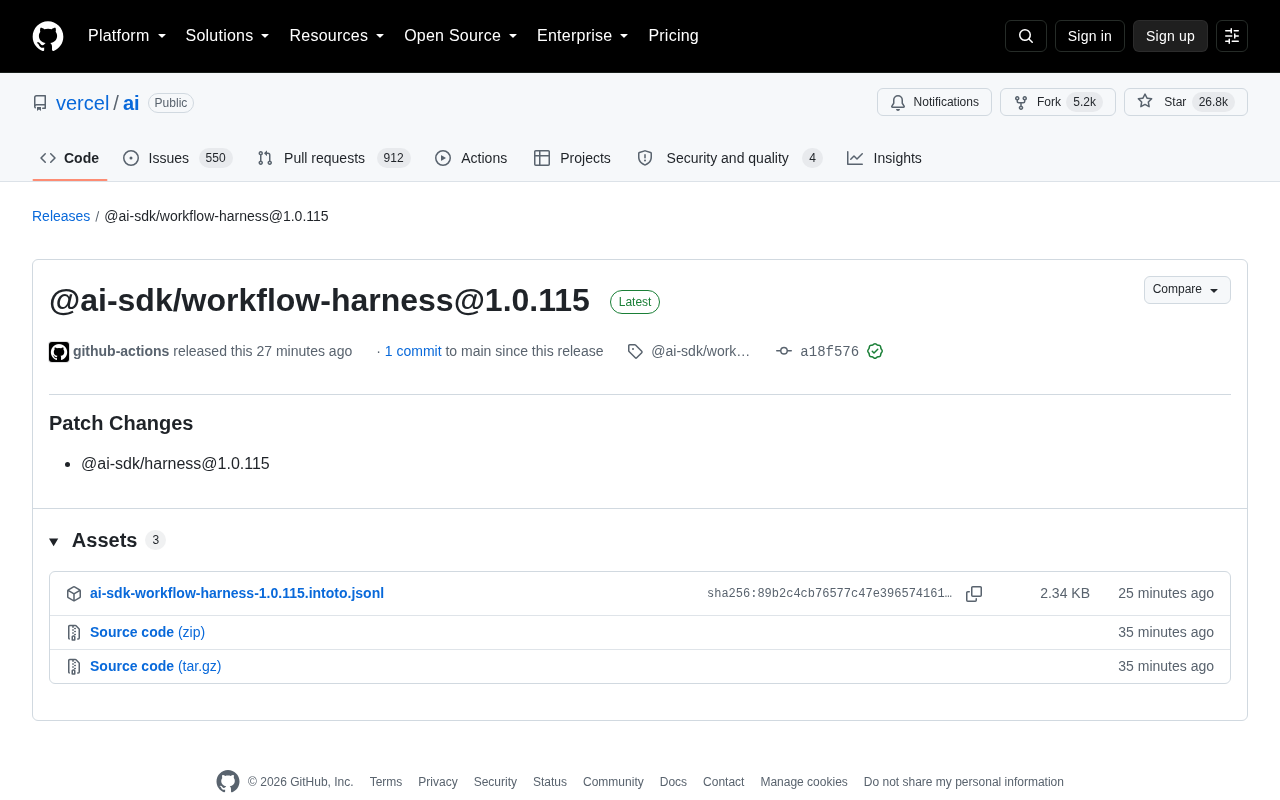
Vercel AI SDK 发布 workflow-harness 1.0.115 补丁更新
Vercel AI SDK 开源仓库发布 @ai-sdk/workflow-harness 1.0.115 补丁版本,同步升级 @ai-sdk/harness 依赖。本文解析该更新内容、发布机制与对开发者的意义。
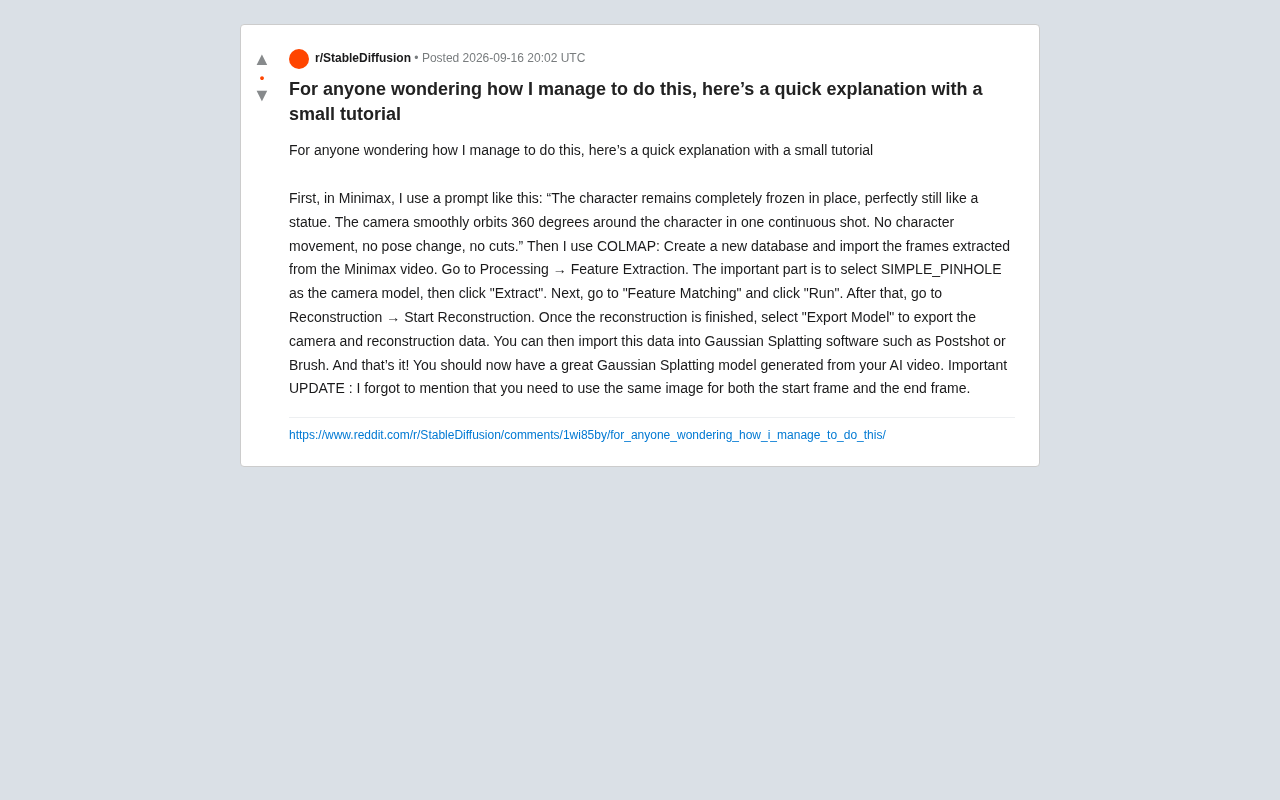
用AI视频生成3D高斯泼溅模型:Minimax+COLMAP实战教程
一份实用教程:如何用AI视频生成工具Minimax拍摄360度环绕镜头,配合开源工具COLMAP进行相机位姿估计,最终生成高斯泼溅3D模型。含完整提示词、COLMAP参数设置与关键操作细节。