rag-eval:零依赖、无需API密钥的RAG评测工具
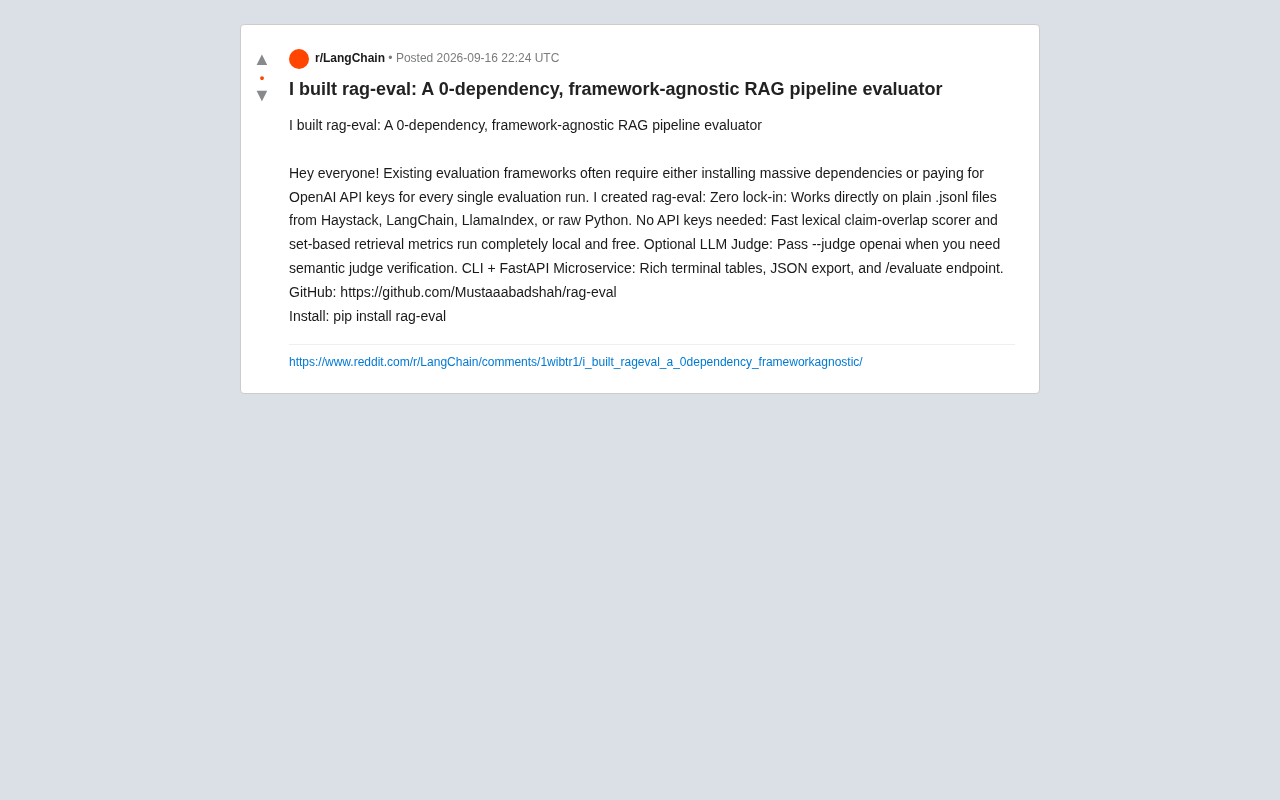
rag-eval:零依赖、无需API密钥的轻量RAG评测工具,支持本地词法指标与可选LLM裁判分层评估。
rag-eval 是一款面向 RAG(检索增强生成)管线的开源评测工具,核心卖点是零依赖、框架无关、无需任何 API 密钥。它直接读取标准 JSONL 文件,兼容 Haystack、LangChain、LlamaIndex 等主流框架的输出。内置本地运行的词法 claim-overlap 评分器和集合式检索指标,可在不产生 API 费用的情况下快速完成大批量评测;当需要更精细的语义判断时,可通过 `--judge openai` 参数启用 LLM Judge 作为可选层。工具同时提供 CLI 和 FastAPI 微服务两种形态,既支持本地手动评测,也便于集成进 CI/CD 自动化流程。其"默认省钱、按需精评"的分层策略,尤其适合处于快速迭代阶段的中小团队和个人开发者。
RAG评测的痛点:贵、重、难落地
检索增强生成(RAG)已经成为构建企业级AI应用的主流范式,但如何客观衡量一条RAG管线的质量,始终是工程师头疼的问题。现有的评测框架往往陷入两难:要么需要安装一大堆沉重的依赖,把项目环境搞得臃肿不堪;要么每跑一次评测都要调用OpenAI的API,付费成本随实验次数线性攀升。
对于需要频繁迭代、反复对比检索策略的团队来说,这两条路都不够友好。一款名为 rag-eval 的开源工具正是冲着这个缺口而来——它的核心卖点简单直接:零依赖、无需API密钥、框架无关。
rag-eval 的核心设计
作者在 Reddit 上介绍了这款工具的几个关键特性,整体思路是把「轻量」和「无锁定」做到极致。
零锁定:直接吃 JSONL 文件
rag-eval 不绑定任何特定框架。无论你的数据来自 Haystack、LangChain、LlamaIndex,还是纯手写的 Python 脚本,只要能导出成标准的 .jsonl 文件,就能直接喂给它评测。这种设计避免了工具与某个生态的深度耦合,团队切换底层框架时不必重写评测代码。
无需API密钥的本地评分
这是 rag-eval 最实用的一点。它内置了两类完全本地运行、免费且快速的评分方式:
- 词法层面的 claim-overlap 评分器:通过词汇重叠度衡量生成答案与参考答案之间的一致性;
- 基于集合的检索指标:评估检索环节召回的文档质量。
这两类指标不依赖任何外部大模型,跑起来又快又省钱,特别适合在开发阶段做大量快速迭代和回归测试。
claim-overlap 评分器的底层逻辑源自信息检索领域的经典方法。它将生成答案和参考答案分别拆解为词元(token)或 n-gram 片段,计算两者之间的重叠比率,本质上与 ROUGE 指标家族(尤其是 ROUGE-1、ROUGE-2)的思路一脉相承。这类指标的优势在于计算速度极快、结果可复现、无随机性,非常适合作为"冒烟测试"——快速排除明显不合格的检索或生成结果。其局限同样明显:同义词替换、语序调整、释义表达都可能导致词汇重叠度低但语义完全正确的答案被低估。因此在实践中,词法指标通常用于过滤大批量的明显错误,而非作为最终质量判定的唯一依据。集合式检索指标则对应经典的 Precision@K、Recall@K 等概念,衡量检索到的文档集合中有多少是真正相关的,以及相关文档被召回的比例。
可选的 LLM Judge
词法评分虽然快,但难以捕捉语义层面的正确性。为此 rag-eval 保留了一个可选开关:当你确实需要更精细的语义判断时,加上 --judge openai 参数,就能启用大模型作为「裁判」进行验证。这种「默认省钱、按需精评」的分层策略,兼顾了成本和质量。
LLM-as-Judge(大模型作裁判)是近两年 RAG 评测领域兴起的重要范式,由 MT-Bench、Chatbot Arena 等研究推广开来。其核心思路是:将待评答案和参考答案(或评分标准)一同送入一个能力较强的大语言模型,由它输出质量评分或优劣判断。这种方式能捕捉语义等价、逻辑推理正确性、事实一致性等词法指标无法覆盖的维度。然而它也存在已知缺陷:对位置偏见(倾向于偏好第一个选项)、冗长偏见(倾向于给更长的答案打高分)以及自我偏好(OpenAI 的模型倾向于偏好 GPT 风格的回答)较为敏感。rag-eval 将其设计为可选项而非默认项,正是在成本可控性与评测精度之间做出了务实的工程权衡。
CLI 与 FastAPI 双形态
rag-eval 同时提供命令行工具和微服务两种使用方式:
- CLI:输出富文本终端表格,直观展示各项指标,并支持导出 JSON 结果;
- FastAPI 微服务:提供
/evaluate接口,方便集成到 CI/CD 流程或线上评测系统中。
这意味着无论是本地手动跑评测,还是把评测接入自动化管线,rag-eval 都能覆盖。安装方式也极为简单,一条 pip install rag-eval 即可上手。
将评测接入 CI/CD 流程是 RAG 工程走向生产成熟度的重要标志。具体做法通常是:在每次代码提交或检索策略变更后,自动触发评测管线,将关键指标(如 claim-overlap 分数、检索召回率)与预设阈值对比,若指标下滑超过容忍范围则阻断合并。FastAPI 端点使得 rag-eval 可以被 GitHub Actions、GitLab CI 或 Jenkins 等工具以标准 HTTP 请求的方式调用,无需在 CI 环境中安装复杂依赖,只需启动一个轻量服务即可完成评测闭环。这种"评测即服务"的模式,是把 RAG 质量保障从事后人工检查升级为自动化回归测试的关键一步。
它适合谁用
rag-eval 的定位非常清晰——它不是要取代那些功能全面的重型评测平台,而是为追求轻量、快速、低成本的开发者提供一个务实的选择。
如果你正处在 RAG 应用的快速开发阶段,需要频繁对比不同检索策略或提示词,又不想每次都付 API 费用,那么用它的本地词法指标做初筛,等到关键节点再启用 LLM Judge 做语义验证,是一条相当高效的路径。
对于希望把评测嵌入工程流程的团队,FastAPI 端点也降低了集成门槛。
一点思考:轻量评测的价值
这类工具的出现,反映了 RAG 工程实践正在走向成熟。早期大家更关注「能不能跑通」,如今越来越多团队意识到,没有可量化的评测,就无法真正优化管线。
而评测本身如果成本过高,反而会拖慢迭代节奏。rag-eval 用「本地免费指标 + 可选大模型精评」的分层思路,把评测成本压到可控范围,这对于中小团队和个人开发者尤其有意义。
当然,词法重叠类指标有其局限,无法完全替代语义层面的判断,最终质量把关仍需谨慎结合 LLM Judge 或人工评估。作为开源项目,它的成熟度和长期维护也有待社区检验。感兴趣的读者可以在 GitHub 上查看源码。
相关推荐
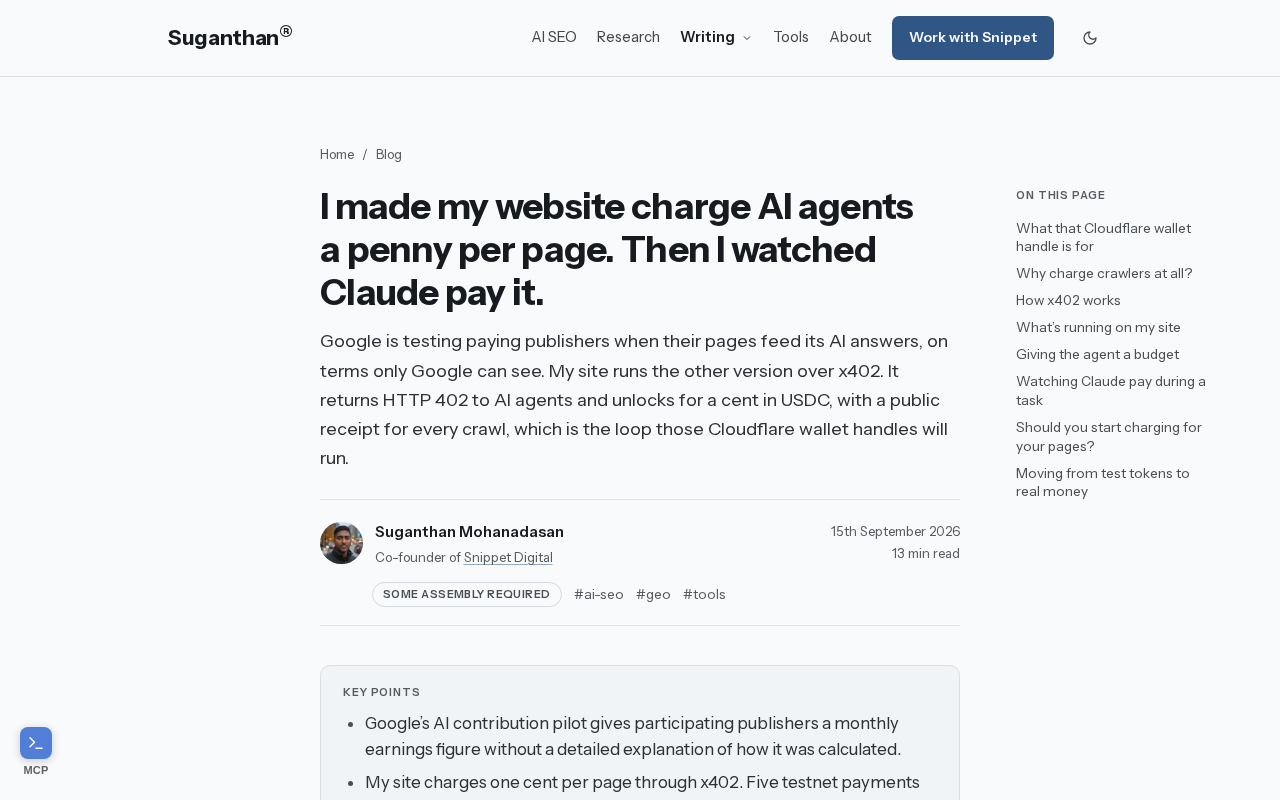
给AI代理网页收费:我看着Claude付了每页一分钱
一位开发者给访问网站的AI代理设置每页一分钱的收费门槛,并见证Claude自动完成支付。这一实验揭示了AI代理经济、HTTP 402微支付与内容变现的新可能,也引出成本失控与标准碎片化等争议。
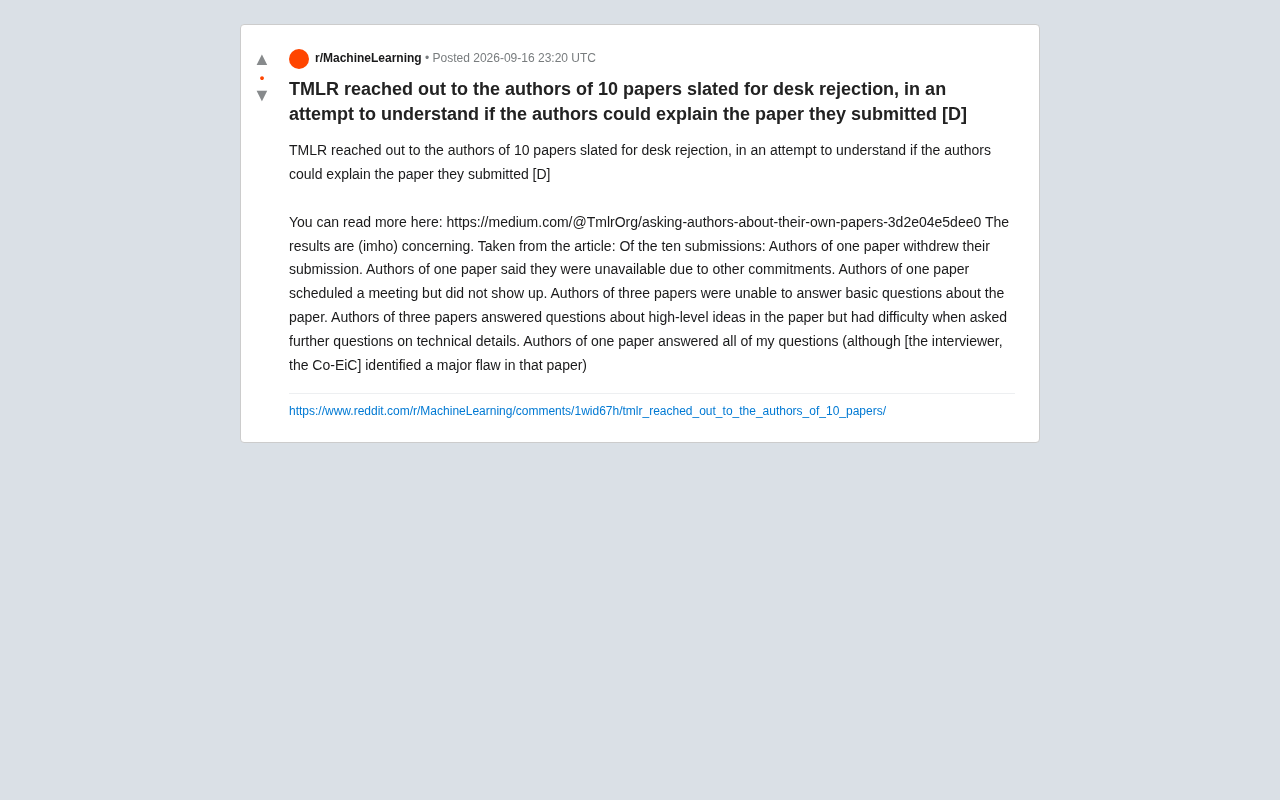
TMLR新实验:让作者解释自己的论文,结果令人担忧
机器学习期刊TMLR联系10篇桌拒论文的作者,请他们亲口解释自己的投稿,结果令人担忧:多数作者无法回答基础问题或讲不清技术细节。本文解读这一实验及其对AI时代学术诚信与同行评审的启示。
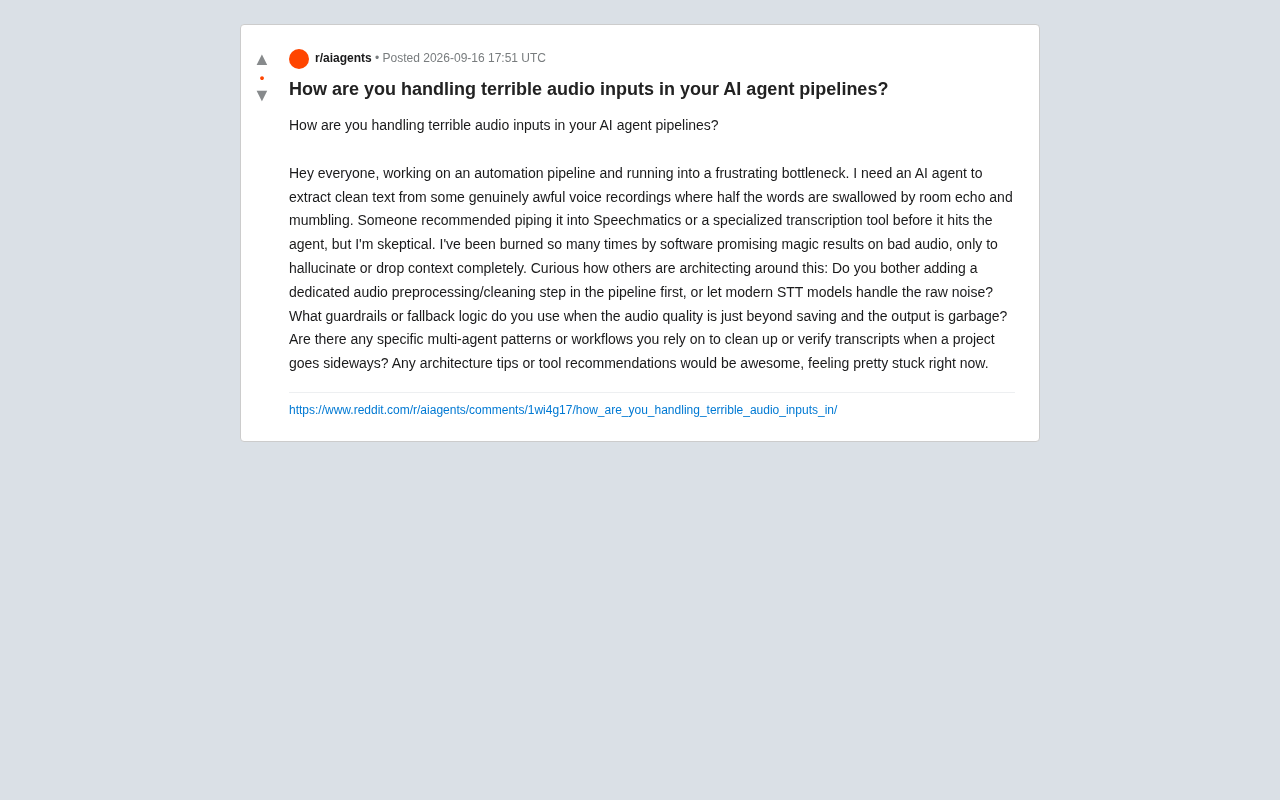
AI Agent 流水线中的劣质音频处理:架构策略与实战指南
面对回声、含混、噪声严重的劣质录音,AI Agent 语音流水线该如何设计?本文梳理音频预处理、STT 置信度护栏、幻觉检测与多 Agent 交叉验证等实战架构策略,帮你避免转录幻觉与上下文丢失。