WildAWM:开源模型合成计算机代理训练环境

微软WildAWM用开源模型合成三界面可执行环境,安全训练计算机代理并验证泛化。
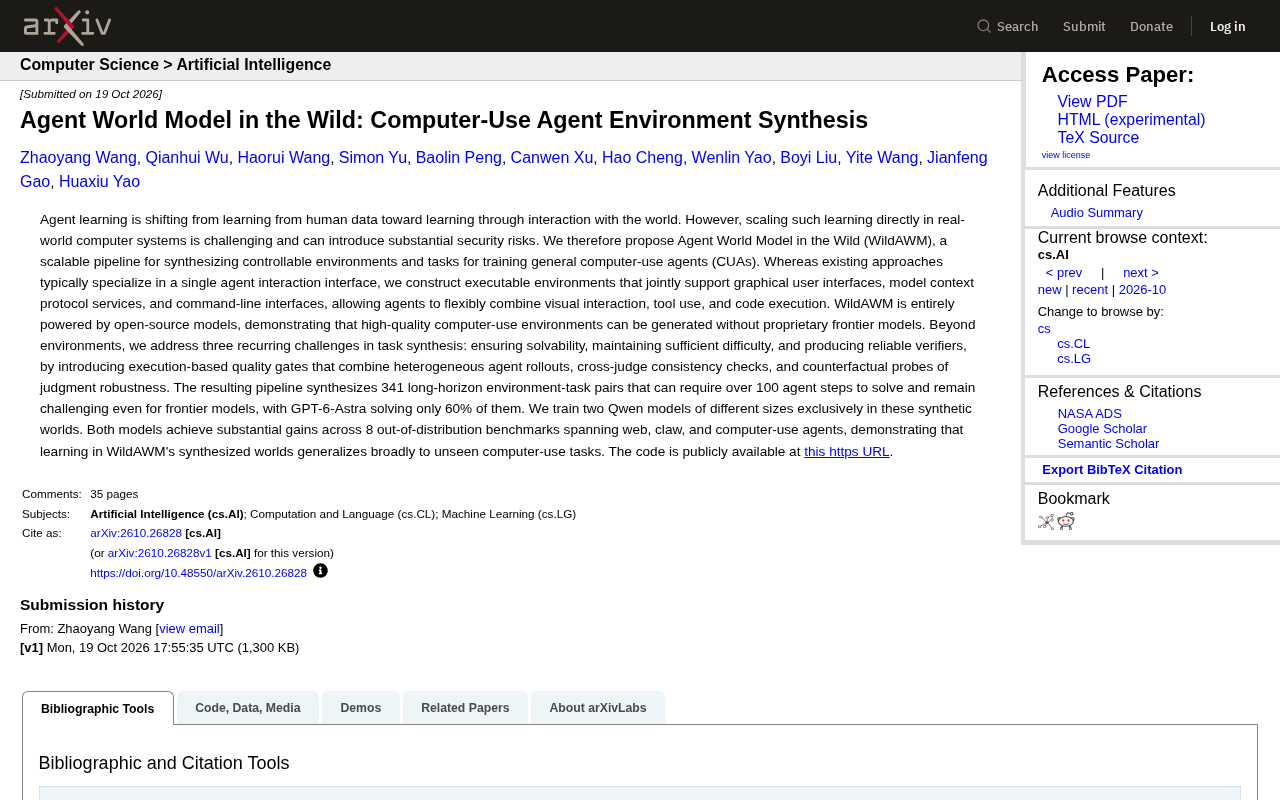
微软研究院提出WildAWM,将计算机代理的训练环境本身变为可合成的对象,以规避在真实系统中试错的安全风险与规模化难题。该管线完全由开源模型驱动,生成同时支持GUI、MCP和CLI三种交互方式的可执行环境,并通过异构代理rollout、交叉裁判一致性检查和反事实探针三道执行式质量门控,确保任务可解、足够难且验证可靠。最终产出341个长程环境-任务对,部分任务需超过100步,前沿模型GPT-6-Astra仅解决60%。仅用合成世界训练的两个Qwen模型在8个分布外基准上取得显著提升,表明合成环境习得的能力可迁移到未见过的计算机使用任务。
计算机代理(Computer-Use Agent, CUA)的训练正从模仿人类数据转向与真实环境交互,但直接在真实计算机系统中扩展这种学习面临巨大的安全风险。微软研究院提出的WildAWM(Agent World Model in the Wild)提供了一条可扩展的合成路径:用开源模型自动生成可控环境和任务,让代理在虚拟世界中安全地“试错”。
从真实系统到合成世界:为什么需要WildAWM
让代理在真实操作系统、浏览器和终端中学习,意味着它可能执行删除文件、发送邮件或调用付费API等不可逆操作。直接放开权限既危险又难以规模化——每次探索都需要隔离、回滚和监控。WildAWM的核心思路是把环境本身也变成可合成的对象:不依赖人工搭建的固定测试床,而是用模型自动生成一批可执行、可验证、难度可控的计算机环境。
论文强调,这条管线完全由开源模型驱动,不依赖专有前沿模型。这释放了一个重要信号:高质量的CUA训练环境不必是少数实验室的专属资源。代码已在GitHub开源(MSR-Orchard/WildAWM),社区可以复现并扩展。
三界面联合:一个环境,三种交互方式
现有环境合成工作通常只针对单一交互接口——要么是图形界面,要么是工具调用,要么是命令行。WildAWM的不同之处在于,它构建的可执行环境同时支持图形用户界面(GUI)、模型上下文协议(MCP)服务和命令行界面(CLI)。代理可以在同一个任务中组合视觉交互、工具调用和代码执行,例如先通过GUI定位按钮,再调用MCP服务查询数据,最后用CLI脚本批量处理结果。
这种“三合一”设计更接近真实计算机使用的复杂性。传统基准往往把代理能力切分成孤立的赛道,而WildAWM的任务要求代理在多种模态之间切换,对泛化能力提出了更高要求。
模型上下文协议(MCP) 是由Anthropic提出并已逐渐成为行业标准的一种开放协议,用于让AI模型以结构化方式调用外部工具、数据源和服务。与传统的函数调用(function calling)相比,MCP定义了更完整的客户端-服务器架构:MCP服务器暴露资源、提示模板和工具,代理作为客户端按统一接口发现并调用它们。在计算机使用场景中,MCP使代理能以可审计、可复用的方式访问文件系统、数据库或第三方API,而不必为每个工具单独编写适配层。WildAWM将MCP作为三种交互接口之一,正是看中了它标准化工具调用的能力,使合成环境中的任务既能通过GUI模拟人类操作,也能通过MCP走向程序化、结构化的工具使用,从而覆盖真实计算机使用中两种截然不同的交互范式。
任务合成的三道质量关
合成环境只是第一步,任务本身必须满足三个条件:可解、足够难、验证可靠。WildAWM为此引入了基于执行的质量门控(execution-based quality gates),包含三种机制:
- 异构代理 rollout:用不同代理实际执行任务,过滤掉无解或过于简单的样本;
- 交叉裁判一致性检查:多个验证器对执行结果独立判断,只有结论一致才保留;
- 反事实探针:扰动任务条件或执行轨迹,检验验证器是否会被“假成功”欺骗。
这三道关卡针对的是任务合成中反复出现的痛点。可解性靠真实执行确认,难度靠代理表现分布筛选,验证可靠性则通过对抗性探测来校准。相比仅靠模型自评或人工抽检,执行驱动的门控更接近训练时真正关心的信号。
反事实探针(counterfactual probe) 源于因果推断与鲁棒性测试的思路:在保持任务表面形式不变的前提下,对条件或执行轨迹做受控扰动,观察验证器的判断是否随之发生正确变化。例如,将一个真正改变系统状态的轨迹与一个仅产生相同屏幕输出但未改变底层状态的“假成功”轨迹进行对比,可靠验证器应拒绝后者。若验证器对扰动不敏感,说明它可能依赖表面特征而非真实执行结果。这类探针能暴露验证器的捷径学习和奖励黑客风险,是执行式门控中校准验证可靠性的关键手段,与异构代理rollout(测可解性)和交叉裁判一致性(测判断稳定性)形成互补。
341个长程任务:前沿模型也只有60%通过率
经过筛选,WildAWM产出了341个环境-任务对。这些任务属于长程(long-horizon)类型,部分任务需要超过100个代理步骤才能完成。难度基准相当直接:即便前沿模型GPT-6-Astra也只能解决其中60%。这意味着该数据集对当前最强的代理系统仍构成实质挑战,而不是又一个接近饱和的评测集。
有意思的是,长程任务的难度不仅来自单步操作的复杂性,还来自多步之间的状态依赖和错误累积。代理在GUI、MCP和CLI之间切换时,任何一步的偏差都可能让后续步骤失效,这对规划与纠错能力都是考验。
长程任务(long-horizon task) 指完成所需决策步数多、步骤间存在强状态依赖的任务,通常需要数十到上百个连续动作。与单步问答或短程工具调用不同,长程任务的核心难点在于错误累积与信用分配:早期一步的细微偏差会随执行链条放大,最终导致整体失败,而代理很难从最终结果反推是哪一步出了问题。此外,长程任务要求代理具备跨阶段的规划、记忆与自我纠错能力。WildAWM中部分任务超过100个代理步骤,且需在GUI、MCP和CLI之间切换,正是为了逼近真实计算机使用中长程、多模态的复杂性,这也是前沿模型通过率仅60%的重要原因。
在合成世界中训练,在真实基准上验证
研究团队仅用这些合成世界训练了两个不同规模的Qwen模型,然后在8个分布外(OOD)基准上评估,覆盖Web代理、claw类任务和计算机使用代理。两个模型都取得了显著提升,说明在WildAWM合成环境中习得的能力可以泛化到未见过的计算机使用任务。
这一结果回应了一个关键疑问:合成环境会不会让代理只记住特定界面的模式?从OOD表现看,跨界面、跨任务类型的迁移是成立的。由于训练数据完全来自合成管线,泛化收益更可能来自任务结构本身的可迁移性,而非对真实数据的隐式拟合。
分布外(OOD, Out-of-Distribution)评估 指在训练数据分布之外的测试集上衡量模型表现,用于检验泛化能力而非记忆能力。在代理学习中,OOD基准通常包含训练时未出现过的网站、应用、任务类型或交互界面。若模型仅在合成环境中训练却在多个异构OOD基准上提升,说明它习得的是可迁移的任务结构与交互策略,而非对特定环境的模式拟合。需要留意的是,OOD提升并不自动等同于真实场景鲁棒性——合成环境与真实系统之间的分布差距仍需量化,这也是作者列为开放问题的原因之一。
合成环境路线的意义与边界
WildAWM的价值在于把“环境”从稀缺资源变成可批量生产的训练材料。开源模型驱动的管线降低了门槛,执行门控保证了质量,三界面联合设计贴近真实使用场景。不过,论文也留下了一些开放问题:合成环境与真实系统的分布差距如何量化,验证器在更复杂任务上的可靠性如何维持,以及341个任务对更大规模训练的支撑是否足够。这些问题将决定合成环境路线能走多远。
对关注AI代理落地的团队而言,WildAWM提供了一个可复用的思路:与其在真实系统中小心翼翼地放权,不如先合成一个足够真实、足够难、可验证的世界,让代理在里面把该犯的错都犯完。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。