WildMAE:结构感知掩码自编码器如何提升野生动物图像重建
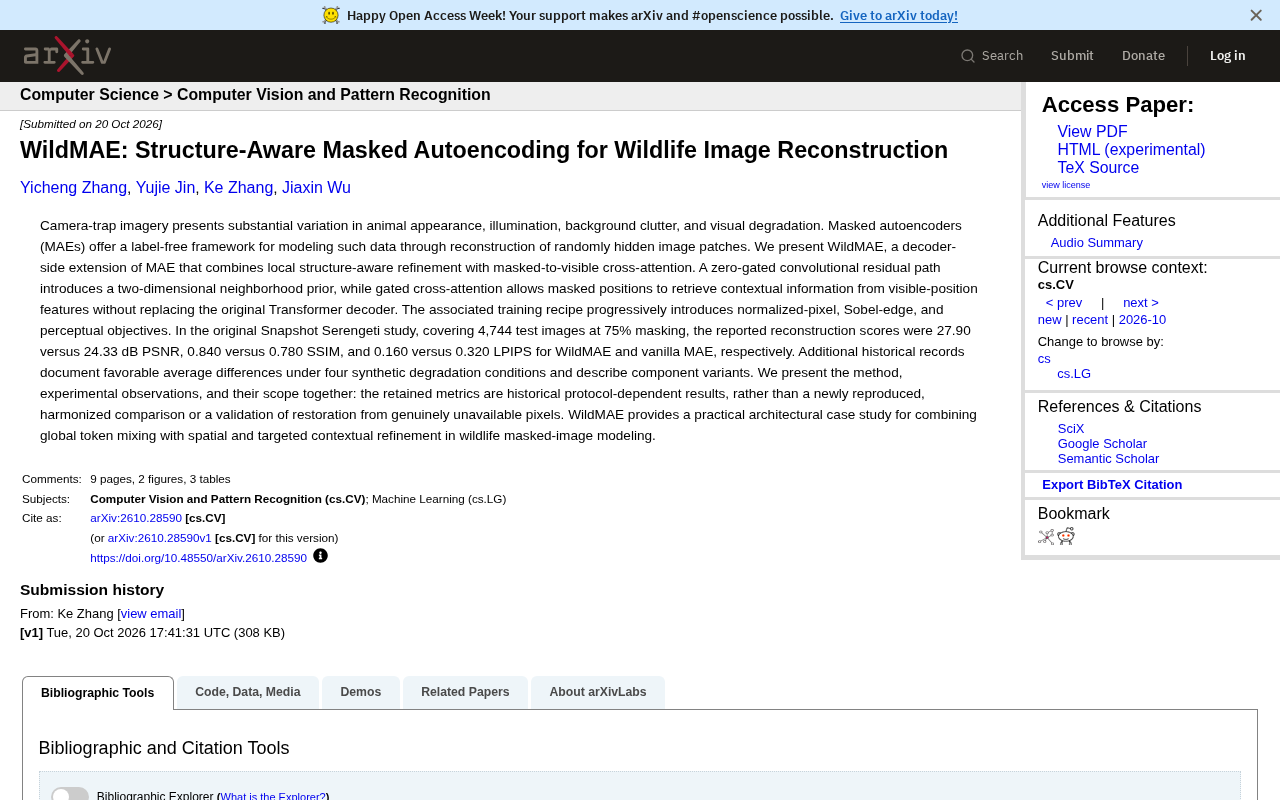
WildMAE在解码器端引入零门控卷积残差与门控交叉注意力,提升野生动物图像重建质量。
WildMAE 针对相机陷阱图像外观多变、光照差异大、背景杂乱等问题,在保持 MAE 编码器不变的前提下改进解码器:增加零门控卷积残差路径注入二维邻域先验以捕捉局部结构,并引入门控交叉注意力让掩码位置从可见位置检索上下文。训练采用渐进式多目标策略,依次引入归一化像素损失、Sobel 边缘损失和感知损失。在 Snapshot Serengeti 数据集 75% 掩码下,PSNR 由 24.33 dB 升至 27.90 dB,SSIM 由 0.780 升至 0.840,LPIPS 由 0.320 降至 0.160。作者声明结果为历史协议依赖,非统一复现对比,也未验证从真正不可见像素恢复图像的能力。
相机陷阱(camera trap)拍摄的野生动物图像,常常面临动物外观多变、光照差异大、背景杂乱以及图像质量退化等问题。传统的掩码自编码器(Masked Autoencoder, MAE)通过重建随机遮挡的图像块来学习无标签表示,但在处理这类复杂场景时,重建细节仍显不足。近期一篇题为《WildMAE: Structure-Aware Masked Autoencoding for Wildlife Image Reconstruction》的研究,提出了一种解码器端的改进方案,在75%掩码比例下取得了显著的重建指标提升。
核心思路:解码器端的结构感知与交叉注意力
WildMAE 并未改动 MAE 的编码器结构,而是将改进集中在解码器端。它引入了两条并行路径:一条是零门控的卷积残差路径,为模型注入二维邻域先验,帮助捕捉局部结构(如动物轮廓、纹理边缘);另一条是门控交叉注意力机制,允许被掩码的位置从可见位置的特征中检索上下文信息,而不是完全依赖 Transformer 解码器自身的全局注意力。
这种设计的关键在于“不替换原始 Transformer 解码器”,而是在其基础上增加局部细化与定向上下文聚合的能力。零门控的设计意味着卷积路径在训练初期几乎不生效,随着训练逐步放开,避免了局部先验与全局注意力在早期训练中的冲突。
掩码自编码器(MAE) 是 He 等人于 2022 年提出的自监督预训练框架:将图像划分为规则图像块(patch),随机遮挡其中大部分(常见 75%),仅将可见块送入 ViT 编码器,再由轻量解码器根据编码特征与掩码 token 重建被遮挡像素,以重建损失驱动表示学习。其非对称设计——编码器只看可见块、解码器处理全部 token——使预训练效率远高于逐块对比学习。MAE 的局限在于解码器主要依赖全局自注意力,对局部纹理与边缘等细粒度结构先验利用不足,这正是 WildMAE 选择在解码器端改进的出发点。
零门控(zero-gated) 是一种常见的残差注入技巧:将新分支的输出乘以一个初始化为 0 的可学习标量(或向量)门控系数,再加到主分支上。训练初期门控为 0,新分支对输出无影响,模型行为等价于原始架构;随着训练推进,门控逐渐增大,新分支平滑地参与优化。这一设计可避免随机初始化的卷积分支在早期引入噪声梯度、干扰预训练权重的收敛,在 ControlNet、Flamingo 等工作中也有类似思路。
训练策略:渐进式多目标优化
研究团队设计了一套渐进式的训练配方,依次引入三种损失目标:归一化像素损失、Sobel 边缘损失和感知损失(perceptual loss)。这种从像素级到结构级再到语义级的过渡,让模型先学会还原颜色和亮度,再聚焦于边缘和轮廓,最后优化整体感知质量。
据论文描述,这种训练策略与解码器架构的改进相辅相成——卷积残差路径负责局部结构,交叉注意力负责全局上下文,而渐进损失则引导两者在不同训练阶段发挥侧重作用。
感知损失(perceptual loss) 由 Johnson 等人提出,不使用逐像素误差,而是将重建图像与真实图像分别送入一个预训练的特征提取网络(通常是 VGG 或 ResNet),比较二者在中间层特征图上的差异。由于深度特征编码了纹理、语义等高层信息,感知损失优化的是“看起来像不像”,而非“每个像素差多少”,因此能缓解像素损失带来的过度平滑与模糊。它通常与像素损失、对抗损失联合使用,是超分辨率与图像修复任务的标准组件。LPIPS 指标正是基于类似的特征距离计算,因此引入感知损失往往能直接改善 LPIPS。
Sobel 边缘损失 则利用 Sobel 算子对图像做水平与垂直方向的离散差分卷积,得到梯度幅值图,再对重建图与真实图的梯度图计算 L1 或 L2 距离。它显式地约束边缘与轮廓的一致性,弥补像素损失对高频结构不敏感的缺陷。三阶段渐进引入的顺序(像素→边缘→感知)对应从低层颜色亮度、到中层结构、再到高层语义的优化重心迁移,避免多目标在训练初期相互拉扯。
实验结果:PSNR、SSIM 与 LPIPS 的全面改善
在 Snapshot Serengeti 数据集的 4,744 张测试图像上,以 75% 的掩码比例进行重建,WildMAE 与原始 MAE 的对比结果如下:
- PSNR:27.90 dB vs. 24.33 dB
- SSIM:0.840 vs. 0.780
- LPIPS:0.160 vs. 0.320(越低越好)
三项指标均显示 WildMAE 在像素精度、结构相似性和感知质量上优于原始 MAE。此外,论文还提到在四种合成退化条件下,WildMAE 也表现出有利的平均差异,并描述了不同组件变体的效果。
说一下,论文作者明确说明这些指标是“历史协议依赖的结果”,并非新近复现的统一对比,也未验证从真正不可见像素中恢复图像的能力。这意味着结果的可比性受限于原始实验设置,读者应将其视为架构层面的案例研究,而非绝对性能的基准。
PSNR(峰值信噪比) 由均方误差换算而来,单位为 dB,数值越高表示像素级误差越小;但它对结构性失真不敏感,常与人眼感知不一致。SSIM(结构相似性) 从亮度、对比度、结构三方面比较图像,取值 0–1,越接近 1 越好,比 PSNR 更贴近结构保真度。LPIPS(学习感知图像块相似度) 则用预训练网络的特征距离度量感知差异,数值越低表示感知上越接近,与人类主观评分相关性更高。三者互补:PSNR 反映像素精度,SSIM 反映结构一致性,LPIPS 反映感知质量,因此重建类论文通常三者并报。
Snapshot Serengeti 是相机陷阱领域最具代表性的公开数据集之一,由 Serengeti 国家公园数百台相机多年拍摄的数十万张图像构成,标注了物种、个体数量及空拍帧,被广泛用于物种分类与生态影像分析。其图像具有典型的野外特征:昼夜光照剧烈变化、动物尺度与姿态多变、植被背景杂乱,是检验重建模型鲁棒性的合适测试床。
意义与局限:架构探索的边界
WildMAE 的价值在于展示了一种将全局 token 混合与空间及定向上下文细化相结合的实用架构模式。对于野生动物图像分析这类需要处理复杂背景和外观变化的任务,这种结构感知的重建能力可能有助于下游任务(如物种识别、个体重识别)的特征学习。
然而,该研究并未声称解决了“从完全缺失像素中恢复信息”的难题——掩码重建本质上是从可见邻域推断被遮挡区域,而非真正的图像修复。此外,实验结果的协议依赖性也提醒研究者,在跨研究比较时需谨慎对待指标差异。
总体而言,WildMAE 为掩码图像建模在生态影像领域的应用提供了一个值得关注的技术方向,其解码器设计思路或可迁移至其他需要局部结构先验的视觉任务中。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。