Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库

Windows下用LangChain-Chatchat加DeepSeek和Ollama搭建本地私有知识库RAG问答的完整流程与避坑指南。
文章针对大模型面对企业私有文档时易产生幻觉的问题,介绍了RAG(检索增强生成)的解决思路,并基于B站UP主Mike的视频,整理了在Windows环境下用LangChain-Chatchat搭配DeepSeek搭建本地知识库问答的完整流程。内容包括:用Anaconda管理Python 3.10虚拟环境、通过Ollama本地运行DeepSeek R1模型并用环境变量修改模型存储路径、配置conda与pip国内镜像源加速下载、修改model_settings.yaml将默认模型替换为deepseek-r1并确保模型列表一致、初始化知识库与启动应用。文中还总结了httpx需锁定0.27.2版本等关键避坑点,整套方案在CPU环境下也可运行,适合低成本构建私有知识库。
大模型虽然强大,但在面对企业内部的财务制度、人事规章等非公开文档时,往往因为训练语料不包含这些内容而出现“幻觉”。解决这个问题的有效路径是RAG(检索增强生成),即外挂一个本地知识库。B站UP主孤炮科技联合创始人Mike分享了一套在Windows环境下,用LangChain-Chatchat搭配DeepSeek实现本地知识库问答的完整流程。本文基于该视频内容,整理出关键步骤与避坑点。
为什么需要本地知识库?
大模型的预训练基于公开语料,垂直领域的私有资料不在其中。直接提问时,模型容易编造答案。据UP主解释,RAG的流程是:加载文件→文本分割→文本向量化→问句向量化→在向量库中匹配Top K相关上下文→将上下文与问题拼接成Prompt→提交给大模型生成回答。这样,大模型就能基于检索到的真实文档片段作答,显著减少幻觉。
文本分割(Text Splitting) 是RAG流程中的关键步骤,指将长文档切分成适合模型处理的短片段(chunk)。常见的分割策略包括按固定字符数切分、按段落或标题切分、递归分割等。分割粒度直接影响检索质量:片段过大会引入无关信息,过小则可能丢失上下文。LangChain-Chatchat默认使用递归字符分割器,并支持设置chunk_size(每段字符数)和chunk_overlap(相邻片段重叠字符数),后者用于避免关键信息刚好被切断。
文本向量化(Embedding) 是将文本片段转换为高维数值向量的过程,使语义相似的文本在向量空间中距离更近。本文使用的bge-m3是智源研究院开源的多语言嵌入模型,支持中文、英文及稠密/稀疏混合检索,在中文语义匹配任务上表现较好。向量化后的片段存入向量数据库(如FAISS或Milvus),提问时同样将问句向量化,通过余弦相似度等度量检索Top K个最相关片段。
环境准备:Anaconda与Ollama
UP主推荐使用Anaconda管理Python环境,因为它允许在同一台Windows机器上创建多个Python版本(如3.10),避免版本冲突。安装时建议选择非C盘路径,并勾选注册Python环境。
为了在本地运行DeepSeek广告模型,需要安装Ollama。Ollama的安装包默认装在C盘且路径不可改,但模型存储路径可以修改。UP主演示了通过系统环境变量新建OLLAMA_MODELS,指向其他磁盘,从而避免C盘空间被模型占满。据UP主实测,DeepSeek R1模型文件约4.7GB,下载需要一定时间。
Ollama 是一个开源的本地大模型运行与管理工具,支持Windows、macOS和Linux。它通过命令行即可拉取和运行模型(如ollama pull deepseek-r1),并自动处理模型量化、GPU/CPU推理调度和API服务暴露(默认监听11434端口)。Ollama内置的模型库涵盖Llama、Qwen、DeepSeek等主流开源模型,模型文件以GGUF量化格式存储,因此体积远小于原始权重——这也是DeepSeek R1仅约4.7GB的原因。Ollama启动后会在后台运行一个兼容OpenAI API风格的服务,LangChain-Chatchat正是通过该接口调用本地模型。
配置conda与国内镜像
安装完Anaconda后,在CMD中运行conda --info检查环境变量是否生效。若命令无法识别,需手动将Anaconda安装目录下的根目录、Scripts、Library\bin三个路径加入系统Path。
默认的conda源在国外,下载依赖速度慢。UP主建议修改用户目录下的.condarc文件,替换为清华镜像源。修改后再次运行conda --info,确认channel-urls已变更。
创建虚拟环境并安装LangChain-Chatchat
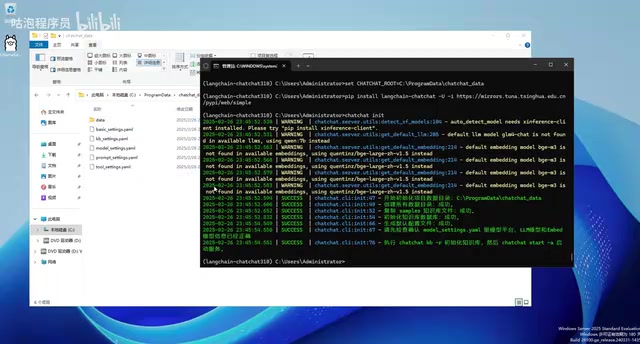
使用conda create -n langchain-chat python=3.10创建名为langchain-chat的虚拟环境,然后通过conda activate langchain-chat激活。激活后,用pip安装LangChain-Chatchat:
pip install langchain-chatchat -U -i https://pypi.tuna.tsinghua.edu.cn/simple
UP主强调,加上国内镜像源可以大幅提升下载速度。安装完成后,通过chat-init初始化项目文件。建议先用set CHAT_ROOT=自定义路径指定配置文件生成目录,避免文件散落在系统默认位置。
修改模型与向量化配置
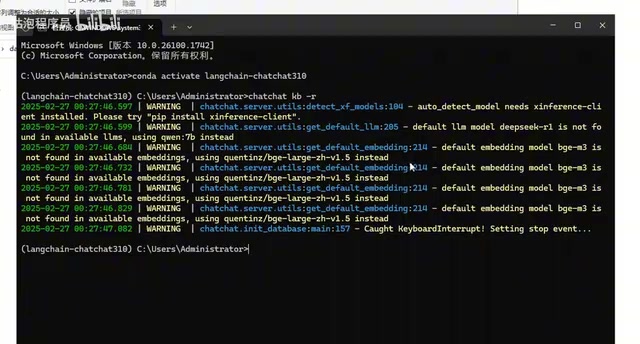
初始化后会生成多个yaml配置文件。需要修改model_settings.yaml,将默认的glm4-chat替换为本地Ollama中的deepseek-r1,向量模型默认是bge-m3,需确保Ollama中已下载该模型(约1.2GB)。同时,在basic_settings.yaml中可调整知识库路径和default_bind_host(若需局域网访问,改为0.0.0.0)。
UP主特别提醒,在model_settings.yaml的LLM_MODELS和EMBEDDING_MODELS列表中要显式添加deepseek-r1和bge-m3,否则初始化知识库时会提示模型未找到。
初始化知识库与启动应用
将需要纳入知识库的文档(如PDF、TXT)放入指定目录,执行chat-init -i初始化知识库。UP主建议先删除示例文件中的大量测试内容,只保留少量文件以加快初始化速度。
启动应用使用chat-chat start命令。UP主在演示中遇到一个常见报错:API未能返回正确的JSON。原因是httpx包版本0.28.1不支持代理,需卸载后安装0.27.2版本:
pip uninstall httpx -y
pip install httpx==0.27.2
重新启动后,应用运行在127.0.0.1:8501。在对话界面提问,若回答风格符合DeepSeek特征,说明本地模型对接成功。随后在“知识库管理”中上传文档,系统会自动分割并向量化存储。在RAG对话中提问,模型会先检索相关片段,再结合上下文生成答案。
关键要点与避坑总结
- 使用Anaconda管理多Python版本,避免环境冲突。
- Ollama模型路径可通过环境变量修改,节省C盘空间。
- conda和pip均建议配置国内镜像源,提升下载速度。
- 配置文件中的模型列表必须与Ollama中实际下载的模型名称一致。
httpx版本需锁定0.27.2,否则启动报错。
据UP主演示,这套方案在Windows 11、Python 3.10、CPU环境下也能运行(CUDA非必须但官方建议11.7以上)。整个流程涵盖了从环境搭建到知识库上传、问答测试的完整闭环,适合希望低成本构建私有知识库的开发者参考。
相关推荐
投票权失守之后:美国民主的隐性代价
探讨美国民主党未能通过《约翰·刘易斯投票权促进法案》和《自由投票法案》后,各州限制性投票立法、最高法院削弱《投票权法案》以及党派杰利蝾螈对选民参与和公平代表性的影响。

AI编程Agent最难的不是写代码,而是知道何时该动手
一位开发者分享构建AI编程Agent的经验:最难的不是让模型更聪明,而是让它知道何时直接动手、何时询问确认、何时完全不碰,配合自检沙箱与模型路由实现可控行为。

陶哲轩:AI正将优美数学变成训练废料
陶哲轩批评硅谷用AI强攻数学难题,将优美数学降格为原始训练材料,产生大量缺乏结构美感的证明。本文解析其“有毒废料”比喻背后的数学审美与激励冲突。