WolveKafka:用HTTP端点消费Kafka消息
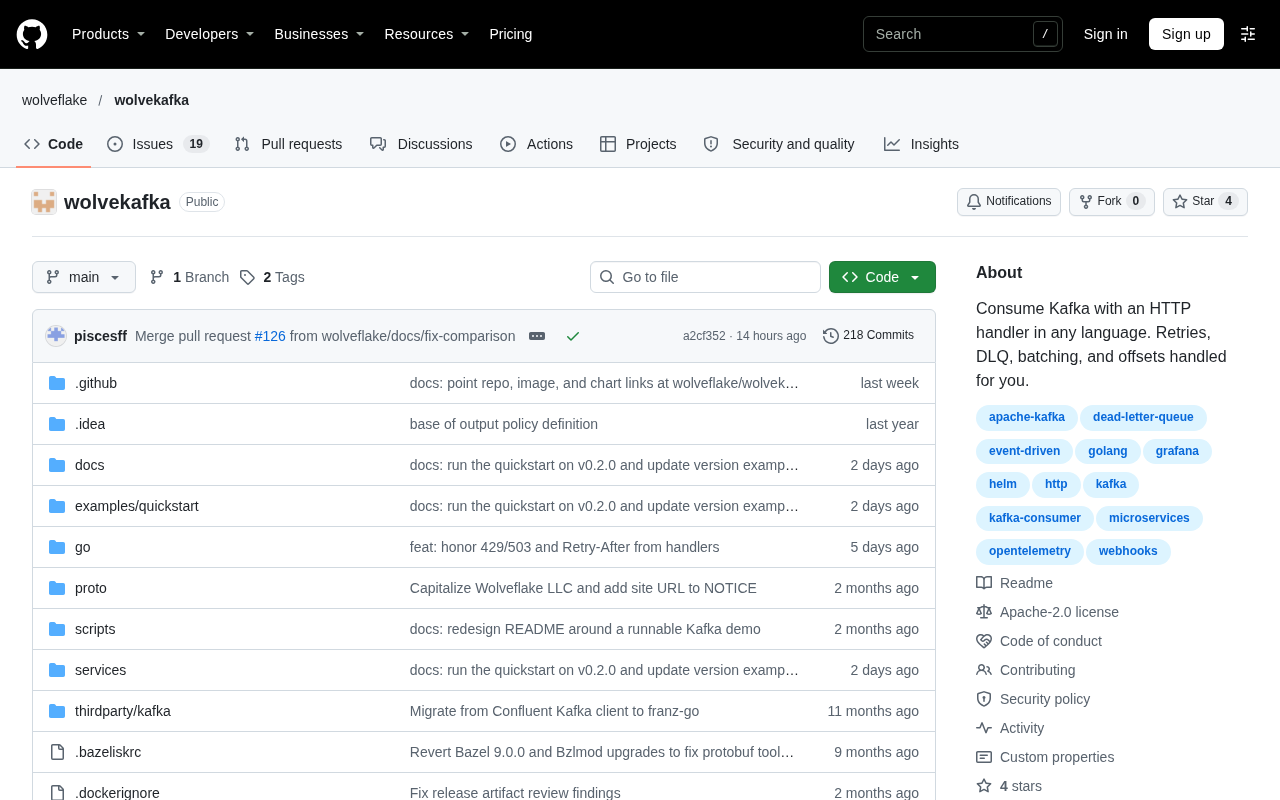
WolveKafka 用 HTTP 端点封装 Kafka 消费,降低轻量场景接入门槛。
WolveKafka 是一个出现在 Hacker News Show HN 上的早期开源项目,它把 Kafka 消息消费抽象为普通 HTTP 请求,让浏览器、Serverless 函数、低代码平台和运维脚本等任何能发 HTTP 的环境都能成为 Kafka 消费者。文章指出,Kafka 原生消费者依赖 TCP 长连接与自定义二进制协议,性能虽高但接入门槛不低。HTTP 封装适合轻量集成、调试排查和周期性拉取,却不适合高吞吐低延迟的主链路,因为 HTTP 的无状态特性与消费者组位移管理之间存在固有张力,往返开销也无法与原生客户端相比。项目目前仅获 4 点、零评论,架构、认证、性能等细节均未公开,需开发者自行查阅源码评估。
Kafka 是流处理领域的事实标准,但它的客户端生态长期绑定在 Java 生态和特定协议之上。对于习惯了 REST 风格、只想用 curl 或几行 Python 脚本快速拉取消息的开发者来说,接入 Kafka 往往意味着一堆依赖和配置。Hacker News 上出现的 Show HN 项目 WolveKafka 试图改变这一点:它让开发者通过一个普通的 HTTP 端点来消费 Kafka 消息。
为什么 HTTP 消费 Kafka 值得关注
Kafka 的原生消费者建立在 TCP 长连接和自定义二进制协议之上,这套设计在高吞吐场景下非常高效,但也抬高了入门门槛。你需要引入对应语言的客户端库、处理序列化、管理消费者组位移,还要应对版本兼容问题。
WolveKafka 的思路是把消费动作抽象成一次 HTTP 请求。这意味着任何能发 HTTP 请求的环境——浏览器前端、Serverless 函数、低代码平台、运维脚本——都能成为 Kafka 的消费者。对于轻量级集成、调试排查、边缘场景的数据拉取,这种模式的价值相当明显。
消费者组与位移(offset)机制是理解 Kafka 消费模型的基础。Kafka 中的每条消息在分区内都有一个单调递增的 offset,消费者通过提交 offset 来标记自己消费到了哪里。消费者组(consumer group)则让多个消费者实例分摊同一主题下不同分区的消息,Kafka 会在 broker 端保存每个组的提交位移,从而实现故障转移后从断点继续消费。原生客户端把这套协调逻辑封装在库内部,而一旦把消费动作搬到 HTTP 层,谁来保存 offset、如何触发再均衡、多实例之间如何避免重复消费,就从"库自动处理"变成了"架构必须显式设计"的问题。这也是评估任何 Kafka HTTP 网关时首先要问清的语义边界。
设计取舍与适用边界
把 Kafka 包一层 HTTP 并不是新想法,企业里常见的做法是自建一个网关服务。WolveKafka 作为独立开源项目出现,省去了重复造轮子的成本,但它同样继承了这类方案的固有取舍。
HTTP 的无状态特性与消费者组的有状态位移管理之间存在张力。如果服务端不维护消费进度,客户端就需要自己记录 offset;如果要维护消费者组语义,服务端就得承担额外状态。不同的实现会在这两端做不同权衡,这也是评估此类工具时的关键问题。
另一个现实约束是延迟和吞吐。HTTP 请求的往返开销和连接复用效率,与原生 Kafka 消费者不是一个量级。对于实时性要求高、消息量大的主链路,HTTP 消费并不合适;但对于周期性拉取、后台任务、一次性数据导出,它足够用且更省心。
**长轮询(long polling)**是这类 HTTP 网关常用的折中手段:客户端发起请求后,服务端在没有新消息时挂起连接,直到有数据或超时才返回。它能在一定程度上缓解纯短轮询带来的空转开销和延迟,但仍无法达到原生 TCP 长连接推送的效率。与之相关的还有连接复用(HTTP keep-alive)、批量拉取(一次请求返回多条消息以减少往返)以及背压控制。判断一个 Kafka HTTP 封装是否实用,很大程度上就是看它在这些工程细节上做了多少工作,而不仅是"能不能拉到消息"。
项目当前阶段与信息局限
这个 Show HN 帖子获得 4 个点数、0 条评论,说明项目仍处于非常早期的阶段,社区还没有形成有效讨论。原始信息只给出了项目定位,没有披露架构细节、支持的认证方式、消息格式处理策略,也没有性能数据。
对这些维度的判断需要开发者自行查看仓库源码和文档。有意尝试的团队应重点关注:消费者位移如何管理、是否支持批量拉取、如何与现有 Kafka 集群的 ACL 体系对接、以及在高并发下的连接池表现。
这类工具的机会在哪里
WolveKafka 的价值不在于替代原生 Kafka 客户端,而在于覆盖那些"不值得引入完整客户端"的场景。数据工程师写一个临时脚本验证某条消息、前端团队想做一个简单的消息监控面板、运维同学需要在故障时快速 dump 一批消息——这些场景下,一个 HTTP 端点比一套客户端依赖轻便得多。
它能否走得远,取决于项目在协议兼容性、安全模型和易用性上的投入。对于关注 AI 应用与数据管道集成的开发者,这类轻量网关也提供了一个思路:把消息中间件的能力暴露成更通用的接口,让上层应用不必被特定技术栈绑定。
相关推荐
大厂Agent实战:从PRD到代码测试的四个Agent与Loop护栏
大厂Agent项目实战拆解:从PRD到代码测试的四个Agent分工、容器隔离底座、Loop护栏终止条件与知识库沉淀,解析AI编程在生产环境落地的演进路径与常见误区。
AgentScope Java极速入门:Java程序员搭建AI智能体实战
AgentScope Java 是阿里开源的企业级 Agent 框架,本文梳理其从环境配置、模型接入到 Agent 创建与多智能体协作的核心原理,对比普通 AI SDK 的差异,并给出分布式存储选型与生产落地要点,帮助 Java 开发者快速跑通第一个 Hanais 智能体项目。
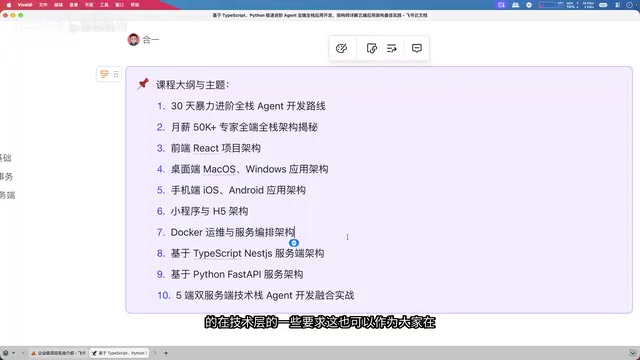
Agent全栈实战:一套代码跑通五端双服务端
从B站AI全栈实战课程出发,解析一套Agent项目如何同时跑通iOS、安卓、小程序、桌面端与H5五端,并用NestJS与FastAPI双服务端架构完成工程化落地,附Docker编排与工具调用链路演示要点。