五大AI模型对决:GPT、Gemini、Claude、Grok、DeepSeek能力解析

B站「模型洄游」预告以拟人对决方式呈现GPT、Claude、Gemini、Grok、DeepSeek五大AI模型的能力定位与行业竞争格局。
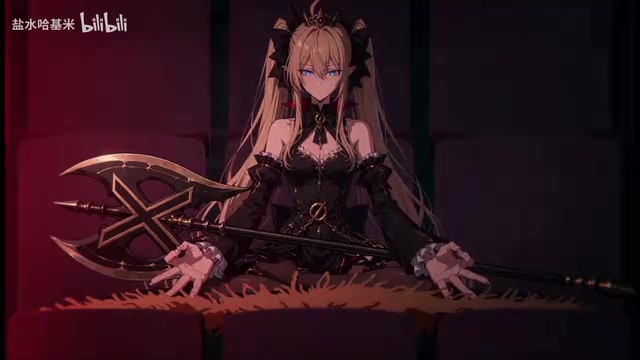
一段来自B站的「模型洄游」预告片,用拟人化、游戏化的「斩杀战」叙事,将当前最主流的五大AI模型放上同一擂台:GPT被描绘为凭一次更新「恶龙觉醒」重返顶点的全能王者;Claude以高输出能力见长,深受开发者信赖;Gemini主打多模态与最快输出速度,延续Google的差异化路线;Grok聚焦多智能体与长链路任务执行;DeepSeek则凭借开源与本地部署成为高性价比的国产崛起代表。这段内容的价值不仅在于娱乐化的包装,更在于它准确折射出大模型行业的真实竞争格局——技术领先只是暂时的,一次关键版本迭代即可重新洗牌,而对用户而言,了解各模型的核心优势才能在实际场景中选对工具。
一场正在上演的AI军备竞赛
AI模型的迭代速度快得惊人,新旧版本的更替周期远超外界预期。这段来自B站的「模型洄游」预告以一种拟人化、戏剧化的方式,把当下主流的五大AI模型——GPT、Gemini、Claude、Grok、DeepSeek广告——放到同一个擂台上,用「斩杀战」的比喻描绘它们彼此之间紧张的竞争态势。
每一款模型都有各自擅长的领域,也都在等待着下一次版本更新带来的能力跃升。这种「你追我赶」的格局,恰恰是当前大模型行业最真实的写照:没有谁能长期稳坐头把交椅,一次重大更新就足以重新洗牌。
五大模型各自的能力画像
预告中为每款模型给出了一个象征性的「评分」和能力定位,虽然这些数字更偏向娱乐化的设定,但背后的能力描述与现实中各家模型的特点高度吻合。
Grok:复杂任务的分解执行者
Grok被描述为擅长「将复杂目标拆解,并交由多个自主智能体持续执行」。这指向的是多智能体(Multi-Agent)与长链路任务执行能力——把一个大目标切分成可执行的子任务,让多个Agent协同完成。在当前Agent化浪潮下,这类能力正成为衡量模型实用性的关键指标。
多智能体(Multi-Agent)架构是指将一个复杂任务分配给多个相互协作的AI智能体(Agent)共同完成,每个Agent负责其中某个子任务,彼此之间可以传递信息、相互调用。这种范式的优势在于并行处理、职责分离,能够突破单一模型上下文窗口和单次推理深度的限制。以"订一次出行计划"为例,一个Agent负责查航班,一个负责订酒店,一个负责整合行程,最后由协调Agent汇总输出——整个流程无需人工干预。当前,AutoGPT、LangGraph、CrewAI等框架已将Multi-Agent编排能力产品化,而具备原生Agent能力的基础模型,在这一架构下往往能发挥更稳定的表现。
Claude:数据轨迹与高输出能力
Claude被赋予「以无数用户留下的数据轨迹为自身领域」的定位,评分为53分,被称为「输出能力在所有模型中最高」。这与Claude在长文本处理、代码生成和稳定输出上的口碑一致,是许多开发者眼中的「重器」。
Gemini:多模态与最快输出速度

Gemini评分41分,出身Google体系,被标注为「多模态竞争者」,创作能力出色,并拥有「当前最快的输出速度」。多模态是Google一直强调的方向,而输出速度在实际交互体验中往往被低估,却直接影响用户的使用感受。
多模态(Multimodal)指模型能够同时理解和生成多种类型的信息,包括文本、图像、音频、视频等,而不是只处理纯文字。Google的Gemini从设计之初便以原生多模态为核心目标,与GPT-4最初以文本为主、视觉能力后续补充的路径不同。在实际应用中,多模态能力意味着用户可以直接上传图片提问、让模型分析图表数据、或将视频内容转化为文字摘要。输出速度(即token生成速率)则影响用户等待响应的实际体验,在实时对话、代码补全等低延迟场景中,速度优势可以直接转化为产品竞争力。
DeepSeek:开源与本地部署的性价比之选

DeepSeek评分40分,关键词是「开源」「本地部署」,并且「以足以碾压同级模型的性能」著称。作为近年崛起的国产力量,DeepSeek以开源策略和高性价比打开局面,让更多开发者能够在本地环境中部署高性能模型,这是它区别于闭源对手的核心优势。
「开源」与「本地部署」在大模型语境下有特定含义。开源模型是指开发者公开发布模型权重(即模型参数文件),任何人可以免费下载并在自己的硬件上运行,无需通过官方API付费调用。本地部署则意味着模型运行在用户自己控制的服务器或个人电脑上,数据不经过第三方服务器,对于涉及隐私或合规要求严格的企业场景尤其重要。DeepSeek的MoE(混合专家)架构使其在推理时只激活部分参数,显著降低了对硬件的要求,让普通消费级GPU也能运行较大规模的模型,这是其「高性价比」口碑的技术根源。
「斩杀战」背后的行业隐喻
预告将这场竞争称为「模型的斩杀战」,并描绘各家都在「屏息等待新版本到来」的紧张状态。这个比喻点出了大模型竞争的残酷性:技术领先往往只是暂时的,一旦竞争对手推出重大更新,原有的优势可能瞬间失效。

这种「军备竞赛」式的格局,对用户而言未必是坏事。各家为了保持竞争力不断加码研发,最终受益的是整个生态——更强的能力、更快的速度、更低的使用门槛。
GPT的「恶龙觉醒」
预告的高潮落在GPT身上。它被描述为一度「落后于人」,但随后「恶龙觉醒」——仅凭一次更新就重返顶点,被称为「横跨全领域的当代之巅」,评分同样是53分。
这段叙事其实折射出OpenAI在行业中的特殊地位:即便在某些阶段被竞争对手超越,但凭借深厚的技术积累和一次关键的版本迭代,依然能够重新夺回领先。这也正是大模型竞争最耐人寻味之处——头部玩家之间的差距,常常只隔着一个版本号。
结语:拟人化叙事下的真实竞争
这段「模型洄游」预告用拟人化、游戏化的手法把枯燥的技术参数变成了一场充满张力的对决,让普通观众也能直观感受到五大模型各自的特点与定位。虽然其中的评分和「战斗力」设定带有明显的娱乐性质,但它所传递的核心信息是真实的:
AI大模型的竞争已进入白热化阶段,没有永恒的王者,只有持续的迭代。对于使用者来说,理解每款模型的擅长领域——GPT的全能、Claude的高输出、Gemini的多模态与速度、Grok的多智能体执行、DeepSeek的开源性价比——才能在实际场景中选对工具。
相关推荐

从工作流到评估驱动:AI时代解决任务的范式转变
AI解题范式正从设计确定性工作流转向「定义评估+爬山优化」。本文解析评估驱动如何重塑任务解决方式、数据供应商的新角色、人类从执行者到方向制定者的转变,以及Agent应用界面的演化趋势。

收据伪造检测模型接近随机?文档图像取证的实战困境与破局思路
一个收据伪造检测项目的 ROC-AUC 始终接近随机水平,本文剖析文档图像取证中的小样本困境,并给出从二分类转向异常检测、自监督预训练、数值一致性校验等可验证的破局方向。

特斯拉Powerwall+电动车:停电时的双重备用供电方案
特斯拉Powerwall家庭储能系统结合电动车双向充电,可在停电时提供多重备用供电。本文解析Powerwall续航能力、车辆作为备用电池以及超充补能的闭环方案与现实边界。