#多模态
共 156 篇相关文章
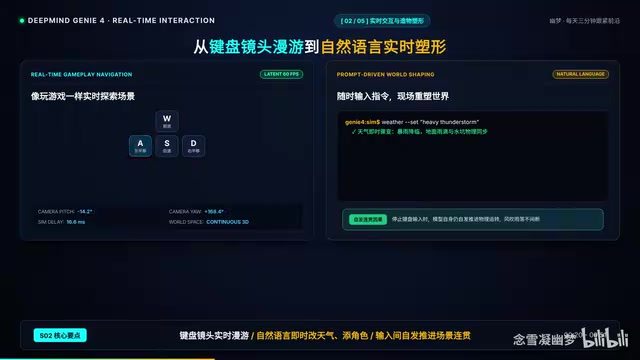
DeepMind Genie 4发布:实时交互世界模型首次原生发声
Google DeepMind 发布 Genie 4 世界模型,首次实现高保真实时交互模拟与原生音频生成。本文解析其自然语言实时塑形、Gemini 家族协同机制、开放节奏,以及官方坦承的物理连贯性等硬伤。
Gemini音频分类实战:实时情感与主题识别
通过 Streamlit 与 Gemini 音频决策模型构建实时音频分类应用,演示情绪、情感、低语检测与话题识别能力,并分析其技术路径与当前局限。
DeepSeek App 能力全量开放:API 一键复刻完整体验
DeepSeek 宣布 App 全套能力通过 API 开放,涵盖搜索、文件、链接、安全与语音,支持内置参数启用或调用 OCR、ASR、TTS 独立 API,并开源前端 Demo 支持导入对话历史。
多模态错误检测:1.5B语言模型如何揪出胸片报告中的不一致
Rad-Linter 用 1.5B 语言模型与图像分类器交叉验证胸片报告一致性,受控实验配对准确率 98.5%,显著优于规则基线,优势集中在理解报告措辞。
用Jacobian透镜探测视觉语言模型的"意识":选择性访问与全局工作空间
研究提出多模态概念透镜MC-Lens,基于全局工作空间理论探测视觉语言模型内部概念处理机制,发现概念信息可选择性访问并参与下游推理,跨模型存在共享模式。

ForeSeek:预判驱动的长视频推理新范式
ForeSeek 提出预判驱动的长视频理解新方法,将检索式智能体升级为预测探索式推理,在五个基准上以少 2.5–4.4 倍帧数取得更优准确率,并开源代码。

Liquid AI决策模型d1.2上线AI Gateway:告别文本生成
Liquid AI 的 d1.2 与 d1.2-ultra 决策模型已上线 AI Gateway,支持音频输入和边界框定位,返回结构化答案而非生成文本,可用于分类、评分与目标定位等任务。
Gemini 4 Hydrogen 五大极限测试:96.7% 准确率与一键建站
YouTube 创作者对 Gemini 4 Hydrogen 进行五项极限测试:单提示词生成游戏、3D 太阳系模拟、30 分钟视频时间戳定位、287 页财报转交互仪表盘,以及抗幻觉测试中 96.7% 的准确率表现。

AI周报:Gemini 4 Carbon翻车,24个新发布降本提速
本周AI圈24个新发布:Gemini 4 Carbon实战暴露长耗时与稳定度短板,Hydrogen轻量版降本提速,Decisions API、Muse Ember等低价批量接口与开源语音、视觉工具集体拉低AI使用门槛。
视觉语言模型的安全盲区:场景状态推理漏洞与S3TA攻击
研究揭示视觉语言模型的场景状态安全漏洞:模型能通过推理视觉事件提供有害协助,攻击成功率高达45.6-72.3%。S3TA攻击方法在MM-SafetyBench上平均ASR达71.2%,比最强基线高6.1个百分点。现有文本过滤和视觉审核防护有限,需关注场景推理过程的安全。
Nunchi:用对话线索解决多人场景视线识别难题
Nunchi框架利用对话线索提升多人场景视线目标识别准确率,在SORBET基准上比最强方法提升4.8个百分点,对话线索比额外视觉线索更有效。

ID-MAE:多模态掩码扩散自编码器提升驾驶损伤检测
ID-MAE是一种多模态掩码扩散自编码器,通过自监督学习提升驾驶损伤检测性能。在DIVERT数据集上,其配对AUC达0.706,显著优于基线。模型同时重建掩码视线和轨迹,并探索了多模态融合设计空间。
CorrectCast:冻结主干网络,轻量校正器提升降水临近预报精度
CorrectCast 提出解耦残差校正框架,冻结基础降水临近预报模型,仅训练轻量校正器,融合 QPE 与 PWV 多模态上下文,在 MRB 和 CONUS 数据集上提升六种基础模型的 CSI。

视觉语言模型为何被2D图片“欺骗”?CueClash基准揭示3D空间推理短板
CueClash基准揭示前沿视觉语言模型(Claude Opus 5.5、GPT-5.5、Gemini 3.6 Flash)在3D空间推理中依赖2D图片线索,捷径差距达18-37个百分点。模型在给定地面坐标时准确率99-100%,但俯视地图存在深度压缩问题。

视觉语言模型的跨图比较为何“看见却说不出来”
新研究追踪视觉语言模型跨图比较失败的两大断点:完全相同的副本被比对却读不出,语义对应存在却传不到答案。仅训练16-32个关键注意力头的查询和键投影,即可在SPair-71k上提升28.3个点,为多模态模型定向修复提供新思路。
279M文本排序器击败2B/7B视觉语言模型:乌尔都语GUI定位新突破
一项研究提出279M参数的文本排序器,在乌尔都语GUI定位任务中以73.4%准确率击败2B和7B视觉语言模型,方法基于DOM候选元素排序而非坐标回归,显著提升指代性指令处理能力。

从像素中学习AGI:Black Forest Labs的视觉智能路线
Black Forest Labs 的 Andreas Blattmann 与 Dustin Podell 阐述从像素、运动与声音学习 AGI 的路线,分析视觉智能的三个信号维度,以及它与文本中心路线的技术分歧。

Seedance 2.5 Flash 上线 AI Gateway:更快更省的视频生成
字节跳动 Seedance 2.5 Flash 登陆 AI Gateway,作为 Seedance 2.5 的快而省版本,支持 4-30 秒、720p、24fps 带同步音频视频生成,支持图片/视频参考与首尾帧控制,可通过 AI SDK 7 以 bytedance/seedance-2.5-flash 接入。