吴恩达Agent课精华:从单代理到完全自动化的实践路径

吴恩达联合LangChain与Tavily,用两小时系统拆解从ReAct到LangGraph的智能体核心设计模式与工程实践。
这门课程由吴恩达、LangChain创始人Harrison Chase与Tavily创始人Rotem Weiss联合推出,系统讲解了AI Agent的五大设计模式(规划、工具调用、反思、多智能体、记忆),并通过从零手写ReAct Agent到用LangGraph重构的完整路径,阐明了「LLM负责智能、外部代码负责控制流」的架构分工。课程着重介绍了LangGraph的节点-边-状态模型、持久化与流式输出,以及基于Checkpoint实现状态修改、时间旅行和人类介入等高级能力。收官项目将研究-生成-批判-再研究的自我迭代循环串联成多节点图,并概览了监督者架构、规划执行、语言智能体树搜索等前沿方向。
吴恩达联合LangChain创始人Harrison Chase、Tavily创始人Rotem Weiss推出的《AI Agents in LangGraph》课程,用两小时系统拆解了智能体工作流的核心设计模式。这堂课从一个最朴素的问题切入:为什么迭代式的Agentic Workflow,往往比让大模型「一口气写完」要好得多?
为什么Agentic Workflow值得期待
吴恩达把当前主流的LLM用法比作「让人从第一个字写到最后一个字、中间不许按退格键写完一篇文章」。这显然违背了人类真实的创作过程。而Agentic Workflow的思路恰恰相反——先列提纲,再决定是否需要上网检索,然后写初稿、自我批判、根据批判迭代改进。
他分享了一个堪比「ChatGPT时刻」的「Agentic AI时刻」:在斯坦福做现场演示时,让Agent先做网页检索再写文章,结果Web Search的API突然失败。就在他以为演示要当众翻车时,Agent自主切换到了他早已忘记自己配置过的维基百科搜索工具,顺利完成了任务。这种「软件能自主执行复杂动作序列」的体验,正是他对Agent乐观的根源。
一个有意思的技术细节是:Agentic Workflow还反过来反哺基础模型训练。直接用LLM生成文本再训练下一代模型是行不通的,但如果在中间插入一个Agentic Workflow来生成高质量数据,这些数据对训练新一代模型就确实有用。
智能体的五大核心设计模式
吴恩达用「三人合写论文」的比喻解释了Agent协作:一个人做规划列提纲,一个人做研究跑查询收集文档,一个人写初稿,再有人审阅提建议并循环修改。他随后提炼出Agentic Workflow的五个关键设计模式:
- Planning(规划):思考要走哪些步骤,先列大纲再决定后续动作
- Tool Use(工具调用):知道有哪些工具可用、如何使用,比如搜索工具
- Reflection(反思):迭代式改进结果,可由多个LLM相互批判、给出修改建议
- Multi-agent(多智能体通信):每个角色都像一个带独特Prompt的LLM,承担独特职责
- Memory(记忆):跨多步骤追踪进度与结果
Harrison Chase补充了过去一年Agent得以成功落地的两个关键改进:一是支持函数调用(Function Calling)的LLM让工具使用变得可预测、稳定;二是像搜索这样的具体工具被改造得更适合Agent使用——Agent需要的不是一堆链接,而是能引用来源的结构化答案。
从零手写一个ReAct智能体
课程的第一步是不依赖任何框架,仅用LLM加Python手写一个基于ReAct(Reasoning + Acting)模式的Agent。这个模式的循环是:LLM先思考(Thought),再决定动作(Action),动作在环境中执行并返回观察结果(Observation),然后LLM带着观察结果继续循环,直到判断任务完成。
实现上,Agent类由一个系统消息参数化,维护一个消息列表,每轮调用都把新消息追加进去。通过精心设计的系统Prompt约束模型按Thought/Action/PAUSE/Observation的格式输出,并提供两个玩具工具(计算器和查询狗平均体重)。课程演示了从手动逐步调用,到用正则表达式解析动作、封装成query循环函数自动运行的全过程。
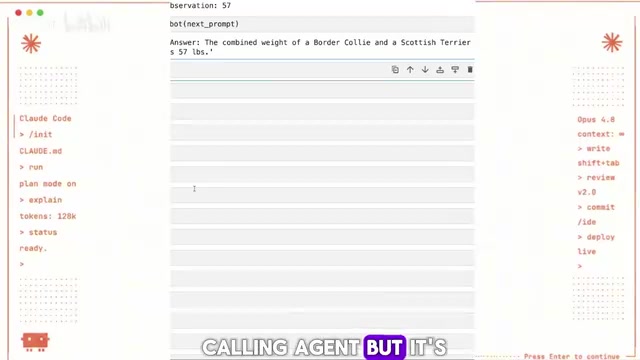
这个环节的价值在于清晰区分了「哪些工作由LLM负责、哪些由围绕LLM的运行时代码负责」——Agent的智能来自LLM,而控制流、工具执行、循环逻辑都是外部代码在管理。
ReAct(Reasoning + Acting)是2022年由谷歌和普林斯顿大学联合提出的一种Agent推理框架,论文标题即《ReAct: Synergizing Reasoning and Acting in Language Models》。其核心思想是将「思维链(Chain-of-Thought)推理」与「外部工具动作」交织在一起,而非让模型单纯在内部推理或单纯执行动作。传统的思维链(CoT)只在模型内部进行推理,无法获取外部世界的最新信息;纯粹的动作执行又缺乏推理步骤,难以应对需要多步分解的复杂问题。ReAct通过 Thought → Action → Observation 的循环,让模型每一步都能把外部观察结果纳入下一步推理,从而有效减少「幻觉」并提升对长程任务的完成能力。这也是为什么在实现中需要用精心设计的系统Prompt严格约束输出格式——模型必须在每个 PAUSE 节点停下来等待真实的工具执行结果,而不能自行捏造Observation。
用LangGraph重构:节点、边与状态
手写Agent中那个庞大的循环函数,正是LangGraph要解决的问题。LangGraph是LangChain的扩展,专为Agent和多智能体流程设计,核心能力是描述并编排控制流,尤其是构建循环图(Cyclic Graph)。
LangGraph有三个核心概念:**节点(Nodes)**是Agent或函数,**边(Edges)**连接节点,**条件边(Conditional Edges)**用于决定下一步该去哪个节点。课程把前面手写的Agent重构为:一个执行LLM的节点、一个判断是否存在待执行动作的条件边、一个执行动作的节点,动作执行后自动回到LLM节点,形成闭环。
另一个关键是**状态(State)**管理。Agent State在图的所有节点和边中都可访问,可存入持久化层。课程特别讲解了状态更新的两种行为:用operator.add标注的字段(如消息列表)在更新时是追加而非覆盖;未标注的字段则会被新值覆盖。这个设计直接决定了Agent如何累积对话历史和中间步骤。
实测中,面对「2024超级碗冠军所在州的GDP是多少」这类问题,Agent展现了串行工具调用能力——它必须先知道冠军是堪萨斯城酋长队、确定所在州是密苏里,才能发起第二次查询。这与同时查询「旧金山和洛杉矶天气」的并行工具调用形成对比。
LangGraph底层基于有向图(Directed Graph)的计算范式,与早期LangChain以「链式调用(Chain)」为核心的设计有本质区别。链式调用是有向无环图(DAG),数据只能单向流动,天然不支持循环;而现实中的Agent任务往往需要「做完一步、评估结果、再决定下一步」的反复迭代,必须引入有向有环图(Cyclic Graph)才能描述。LangGraph的状态(State)管理借鉴了函数式编程中的「Reducer」概念:每个节点不是直接修改全局状态,而是返回一个局部更新,由框架按照预先定义的合并规则(如追加或覆盖)统一应用到全局状态上。这种设计使得状态变更可预测、可追溯,也是后续持久化与时间旅行功能得以实现的基础——每次状态变更都可以被独立记录为一个检查点(Checkpoint)快照。
Agentic Search:Agent需要的不是链接
课程用一节专门讲解Agentic Search与传统搜索的区别。普通搜索返回的是一堆链接,还需要人去点击、抓取、解析HTML、清洗内容——课程现场演示了用DuckDuckGo加BeautifulSoup抓取网页的繁琐过程。
而Tavily这类Agentic Search工具,会先理解问题、必要时拆分为子问题,为每个子问题选择最佳数据源(比如天气类问题就用天气API),再从源中抽取相关信息、分块做向量检索取出最相关的片段,最后打分过滤。返回的是结构化的JSON。
吴恩达团队点出了一个核心洞察:这种JSON对人类来说可读性很差,但「这正是Agent想要的——结构化数据」。人类需要的是带温度、湿度、风速图标的直观界面,而Agent需要的是能被程序精确解析的数据格式。
持久化、流式与人类介入
长时间运行的Agent任务离不开两个概念:**持久化(Persistence)**让你保存某一时刻的Agent状态并在未来恢复;**流式(Streaming)**让你实时看到Agent正在做什么。LangGraph通过Checkpointer(如SQLite Saver)在每个节点间保存状态快照,并用thread ID区分不同会话,支撑生产环境中的多用户并发。
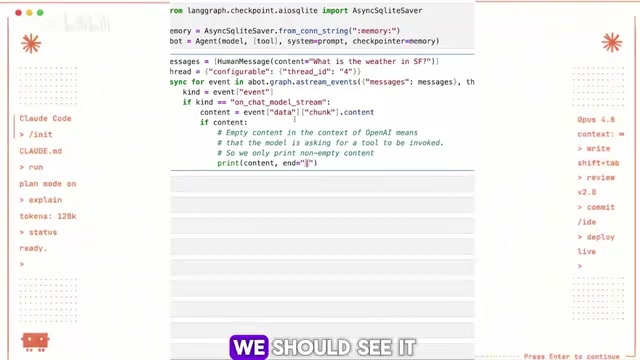
持久化还解锁了强大的「人类介入(Human-in-the-loop)」能力。通过在编译图时设置interrupt_before=action,可以在执行工具前中断,等待人工审批。课程进一步演示了几种高级模式:
- 修改状态:把Agent误解的「洛杉矶(Los Angeles)」纠正为「路易斯安那(Louisiana)」
- 时间旅行:通过
get_state_history回到任意历史检查点并从那里重新运行 - 分支编辑:回到过去的状态后修改并走出一条新分支
- 手动注入结果:用
as_node=action参数伪装成动作节点,直接给Agent一个模拟的工具返回值,而不真正调用工具
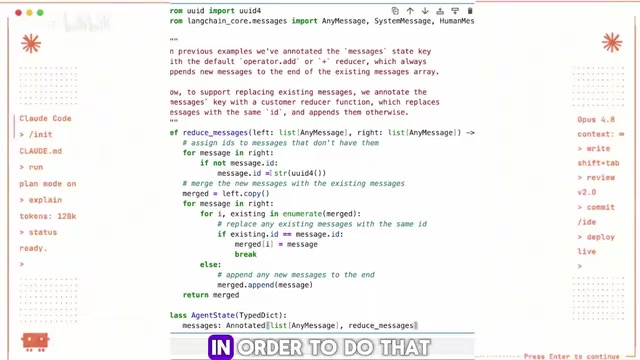
这里的一个技术细节是,人类介入场景中需要替换而非追加消息,因此要写一个自定义的reduce_messages函数,根据消息ID判断是替换还是追加。
「人类介入(Human-in-the-loop,HITL)」是工业级AI系统可靠性工程的核心概念,指在自动化流程的关键决策节点保留人类审批或纠错的能力。在Agent场景下,HITL尤为重要,因为LLM存在幻觉风险,且部分工具调用(如发送邮件、执行数据库写操作、触发支付)具有不可逆的副作用。LangGraph通过interrupt_before机制将图的执行在指定节点前挂起,本质上是把一个本来连续的计算过程变成了「可暂停、可恢复」的协程(Coroutine)风格。结合Checkpointer的持久化能力,即使Agent中断后服务器重启,也能从检查点精确恢复上下文,而无需重新执行已完成的步骤。「时间旅行」功能则进一步把Agent的执行历史变成一棵可分支的版本树,这在调试复杂Agent行为、或需要对同一任务尝试不同策略时具有重要的工程价值。
终极项目:会自我批判的论文写作Agent
课程的收官项目是一个「AI研究员/论文写作Agent」,它把前面所有概念串联成一个复杂的多节点图:先生成写作计划 → 基于计划做研究(调用Tavily取文档)→ 生成初稿 → 判断是否完成 → 若未完成则进入Reflect节点生成批判 → 根据批判再做一轮研究 → 回到生成节点重写,如此循环直到满足max_revisions条件退出。
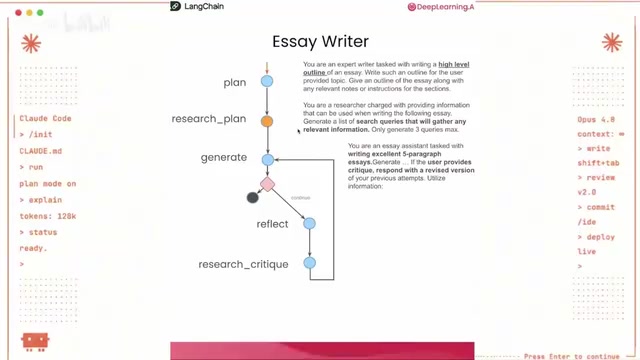
这个Agent的状态比之前复杂得多,要追踪任务、计划、草稿、批判、研究内容列表,以及修订次数和最大修订次数。课程还配套做了一个GUI,可以在每个节点后中断、查看内存状态快照、手动修改计划(比如把「披萨店」荒诞地改成「果酱甜甜圈在披萨制作中的重要性」),直观演示了状态如何演变、时间旅行如何工作。
更前沿的Agent架构
课程最后概览了几种未能在课上实现、但值得了解的高级架构:
- 多智能体架构(Multi-agent):多个Agent在同一共享状态上协作
- 监督者架构(Supervisor):一个强大的LLM作为监督者,负责路由和协调各子Agent,子Agent可有各自独立的状态
- 流程工程(Flow Engineering):源自Alpha Codium论文,在关键节点设置循环以达到SOTA编码性能
- 规划-执行(Plan-and-Execute):先显式规划,再逐步执行,中途可按需重新规划
- 语言智能体树搜索(Language Agent Tree Search):对可能的动作状态做树搜索,可回溯并更新父节点信息——这也凸显了持久化的重要性
Harrison Chase强调,LangGraph与其他框架最大的差异在于高度的可控性——图中每条箭头都明确定义了状态流转,而这种可控性正是打造真正能用的Agent的关键。
相关推荐

别再为AI智能超额付费:OpenAI DevDay成本优化全攻略
OpenAI DevDay成本优化实战解读:从每任务成本思维、帕累托曲线选模型,到提示缓存、程序化工具调用、推理强度与批处理四大杠杆,附Perplexity、Notion、Clio、Blitzy真实客户案例,教你不再为AI智能超额付费。

Databricks IP 函数正式 GA:用原生 SQL 搞定 IP 与 CIDR 分析
Databricks IP 函数正式 GA,支持用原生 SQL 解析、校验和关联 IPv4/IPv6 地址及 CIDR 网段,在 Photon 引擎优化下 CIDR join 最高提速 3.1 倍、成本降低 6.4 倍,助力 Security Lakehouse 安全分析。

如何约束AI智能体?Omnigent策略实现成本与行为双控
AI智能体如何防止过度消费和执行危险操作?Omnigent策略通过动作执行前的检查,实现成本上限、工具权限限制与会话级累积风险追踪,达到阈值时自动触发人工审批,为智能体安全治理提供务实方案。