悟空2.2P开源:35B MOE模型性能超越Qwen3.6-27B,速度快3-5倍

悟空2.2P 35B MOE模型开源,通过对抗式杂交蒸馏实现小模型性能逆袭。
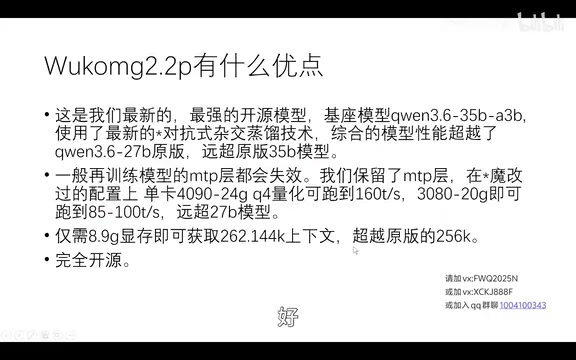
AI团队"神奇能赢"开源了悟空2.2P 35B MOE模型,基于Qwen3.6-35B基座,采用对抗式杂交蒸馏技术训练,综合性能号称超越Qwen3.6-27B原版。该模型结合MOE架构实现推理速度快、显存占用低的优势,适合本地部署。其核心技术融合了多教师蒸馏与GAN对抗训练思想,代表了社区驱动的开源模型创新方向。
概述:开源小模型的新标杆
近日,AI创作者"神奇能赢"团队正式开源了最新力作——悟空2.2P(Plus)35B MOE模型。这款基于Qwen3.6-35B基座、采用"对抗式杂交蒸馏"技术训练的模型,综合性能号称超越Qwen3.6-27B原版,同时在推理速度和显存占用上具备显著优势。对于追求本地部署高性价比方案的用户来说,悟空2.2P是一个值得关注的选择。
当前开源小模型领域竞争激烈,形成了以Qwen(阿里)、LLaMA(Meta)、Mistral、Gemma(Google)为主要基座的生态格局。在此基础上,大量第三方团队通过微调、蒸馏、合并等技术二次开发,形成了活跃的模型社区。悟空系列所代表的"对抗式蒸馏"路线,与Nous Research的Hermes系列、Teknium的OpenHermes等走的是类似路径——在开源基座上通过创新训练方法追求性能突破。这类社区驱动的模型创新正在快速缩小与商业闭源模型的差距,也为本地部署用户提供了越来越多的高质量选择。
核心技术:对抗式杂交蒸馏如何让小模型逆袭
对抗式杂交蒸馏的训练范式
悟空2.2P延续了悟空2.2系列的核心训练方法——对抗性知识蒸馏。知识蒸馏(Knowledge Distillation)最早由Hinton等人于2015年提出,其核心思想是让小模型(学生模型)学习大模型(教师模型)的输出分布,而非仅学习硬标签。传统蒸馏通常是一对一的师生关系,而"杂交蒸馏"则引入多个教师模型,让学生模型从多个来源汲取知识,类似生物学中的杂交优势。"对抗式"则借鉴了GAN(生成对抗网络)的思想,通过对抗性训练框架迫使模型在更具挑战性的样本上持续优化,避免简单拟合教师模型的平均行为,从而在特定能力维度上实现超越单一教师的表现。
此次悟空2.2P与之前的悟空2.2 Lite 9B在训练方法和数据集上几乎完全一致,唯一区别在于基座模型从Qwen3.5-9B升级到了Qwen3.6-35B。更大的基座配合成熟的蒸馏技术,带来了质的飞跃——团队宣称其综合性能不仅超越Qwen3.6-27B原版,更是"远超原版35B模型"。
MOE架构:速度与容量兼得的根本原因
理解悟空2.2P速度优势的关键,在于理解MOE(混合专家模型,Mixture of Experts)架构与传统稠密模型的本质差异。稠密模型每次推理都激活全部参数,而MOE模型包含多个"专家
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
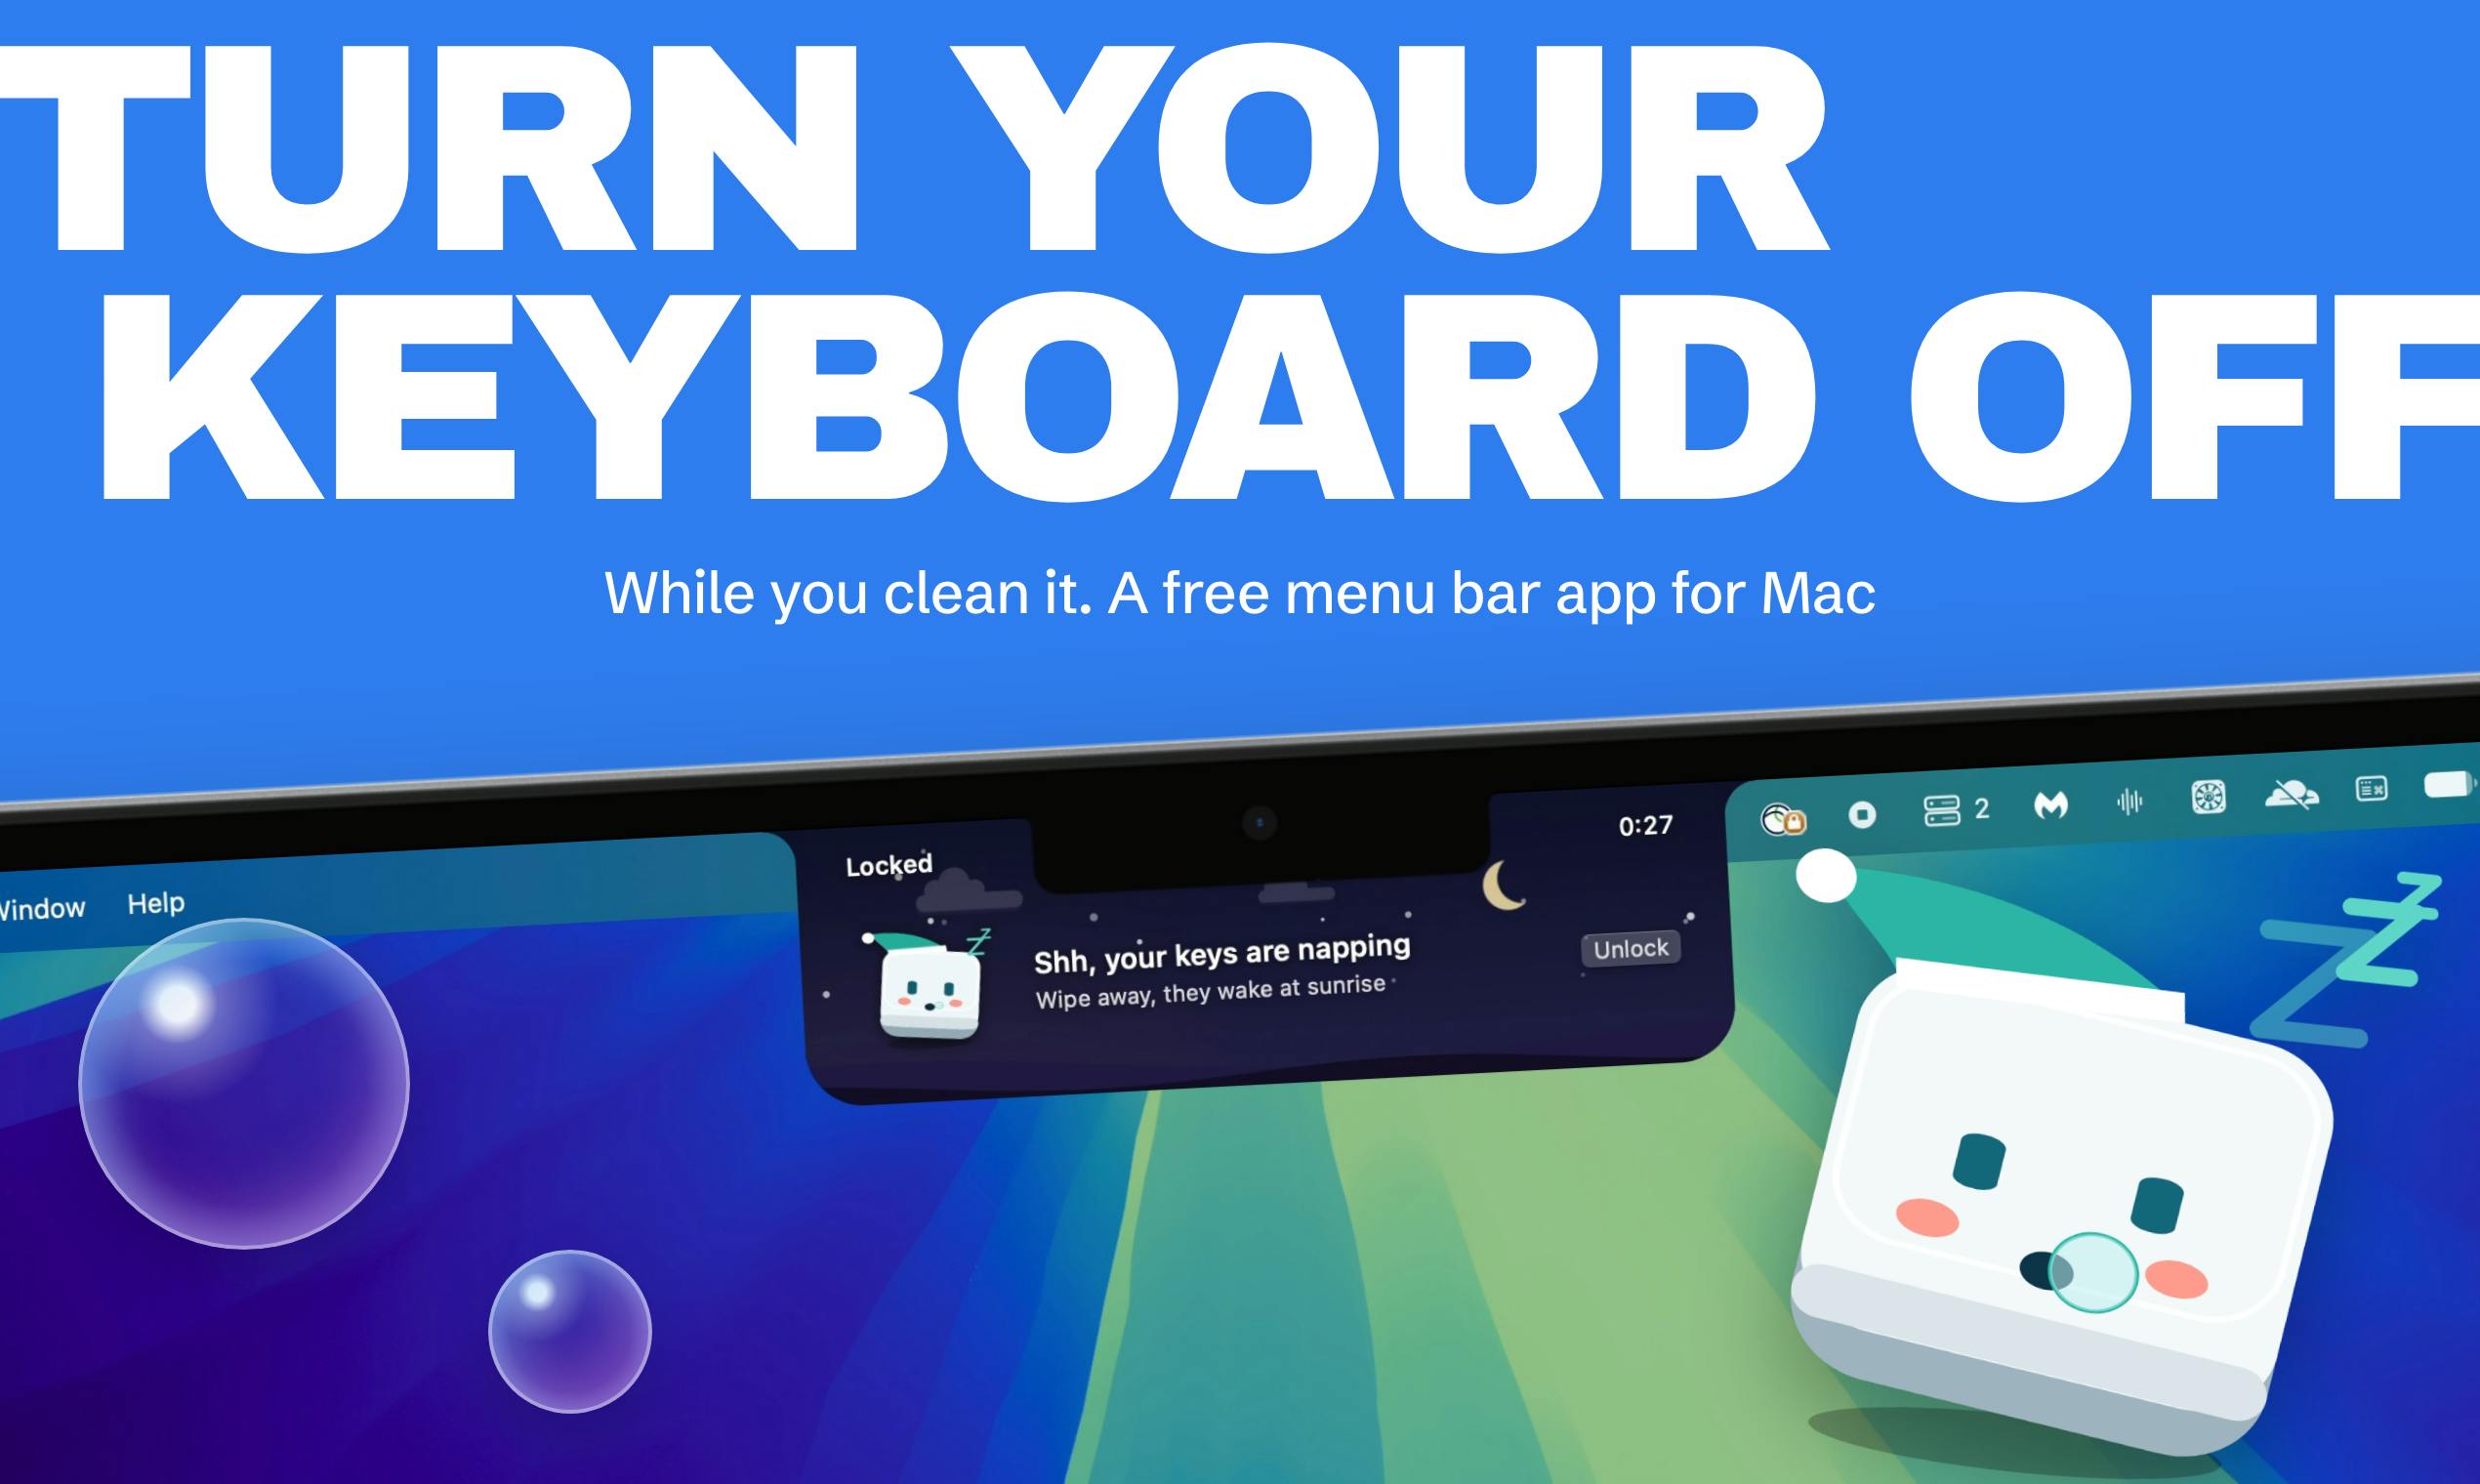
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。