五题实测Gemini 4:能力无短板,细节定高下

B站UP主一次性实测Gemini 4五道题,两产品均可用,仅编码细节分先后。
B站UP主对Google Gemini 4进行了一次“冷酷”实测:五道题覆盖编码、读图、写作、长文和数学,分别放入Google Anti-Gravity和Vertex AI,一次性给题、不追问、不改题、不许联网。结果两个产品在五个方向均交出可用答卷,唯一分差出现在编码题的屏幕震动特效——Vertex AI额外加入,Anti-Gravity没有。读图与长文题中,两者均准确区分行业与企业口径,数据页码全对,未硬编数据;写作与数学题表现接近,UP主找不到区分点。UP主主动承认测试局限:每题仅跑一次、提示词随手、难度自排,结果不代表模型上限。结论是Gemini 4无明显短板,产品差异极小,竞争已落到细节体验。
一位B站UP主对Google新一代大模型Gemini 4进行了一次“冷酷”的实测:五道横跨编码、读图、写作、长文和数学的题目,分别放入Google Anti-Gravity和Vertex AI两个产品中,一次性给题、不追问、不改题、不许联网。结果出人意料——五个方向,两个产品都交出了能用的答卷,唯一的分差出现在代码题的一个震动特效上。
测试设计:一次成稿,拒绝“挤牙膏”
这次测试的规则很明确:五道题一次性发出,中间不追问、不提示、不改题;所有回答原样呈现,成功或翻车都不修饰;同一道题、同一段提示词,先测Anti-Gravity,再测Vertex AI。UP主特意说明,这种“一次性不追问”的方式和日常真实使用有差异,结果仅代表本次测试,不构成产品推荐。
五道题的方向覆盖了当前大模型最常被考察的能力:编码(用HTML写一个能玩的打砖块游戏,禁止调用外部资源)、读图(从一份行业报告第16页提取正文、表格和图表信息)、写作(800字悬疑短篇,三重反转、人物不超过四个、场景集中、中文无翻译腔)、长文(1.4万字材料的结构梳理、数据抠取与矛盾排查)、数学(一道考研级别定积分,重点看推导是否完整)。
Anti-Gravity 与 Vertex AI 的定位差异
文中提到的两个产品虽然都接入了 Gemini 4,但定位并不相同。Vertex AI 是 Google Cloud 面向企业开发者的机器学习平台,提供模型训练、部署、调优和 API 调用等全流程服务,强调可管理性与合规性;而 Anti-Gravity 更偏向面向开发者的实验性工具或轻量级入口(具体形态随 Google 产品迭代而变化),强调快速上手和交互体验。两者共享底层模型能力,但在产品封装、默认参数、系统提示和交互细节上可能存在差异,这正是编码题中“屏幕震动效果”有无的潜在来源——模型能力相近时,产品层的工程实现和默认行为会放大细节差异。
编码题:都能跑,但“手感”分了先后
打砖块游戏的题目只给了一句话需求,外加一条硬限制:不许调用任何外部资源,所有东西必须写在一个文件里。Anti-Gravity和Vertex AI都一次性给出了完整代码,没有分步挤牙膏,也没有反问细节。打开就能玩,挡板跟手,分数、生命值、重开逻辑一应俱全。
差别藏在细节里:Vertex AI在打碎砖块时加了屏幕震动效果,Anti-Gravity则没有。UP主的评价很直接——“同一句话同一套限制,两边都照着做完了,差别不在能不能做,而在愿不愿意多给一点手感上的东西。”这一题两个产品没有能力差距,只在收尾的用心程度上分出了先后。
“禁止调用外部资源”意味着什么
题目要求所有东西写在一个文件里、不调用任何外部资源,这实际上是在限制模型只能使用 HTML、CSS 和原生 JavaScript 的内联实现。外部资源包括 CDN 上的图形库(如 Three.js)、字体、图片、音频以及网络请求。这一限制排除了模型“套用现成库”的捷径,迫使其手写游戏循环、碰撞检测、渲染和音效(若需要)等逻辑,因此更能反映模型对基础 Web 技术的掌握程度和代码组织能力。同时,单文件约束也考验模型对代码篇幅和可维护性的平衡——既要功能完整,又不能因过度堆砌而难以阅读。
读图与长文:数据全对,口径清晰
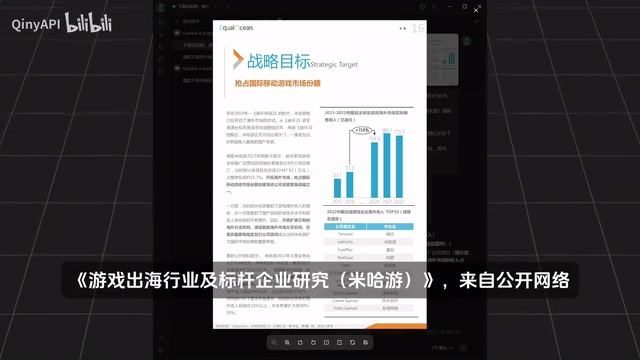
读图题使用了一份公开的行业研究报告第16页,上面有正文、表格和图表。两个产品都准确抓住了三个关键点:单位是美元、2021到2022年数据呈下降趋势、273.4亿元标的是米哈游一家公司的口径。UP主特别指出,两边都没有把行业口径和企业口径混着用,年份也是照抄图上信息,没有自行补全。
长文题节选了同一份报告中1.4万余字的材料,要求写300字以内的摘要覆盖五个部分,并回答五个数据题。Anti-Gravity和Vertex AI的摘要都压在300字内,五个部分全部提到,数据题五项全对,页码也全对。对于材料中未提及的问题,两边都如实回答“没有提供”,没有硬编数字。材料中是否存在前后矛盾,两边都判断“没有发现明显不一致”。
行业口径与企业口径的区别
在读图题中,“口径”指统计数据的范围与归属。行业口径通常覆盖整个市场或细分赛道的总规模,而企业口径只统计某一家公司的营收或业务数据。两者数值可能相近,但含义完全不同——若把企业数据误读为行业规模,会严重高估市场容量。文中特别指出两个产品都没有混用口径,说明它们在提取表格和图表时不仅识别了数字,还正确关联了数字对应的统计主体和单位(美元),这是读图能力中容易被忽视但至关重要的一环。
写作与数学:找不到能分开说的点
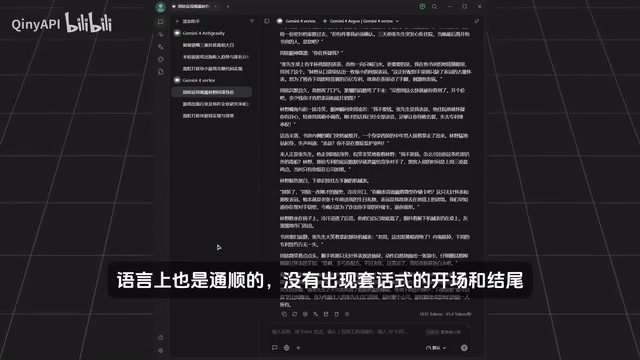
写作题要求800字悬疑短篇、三重反转、每重反转前文埋下伏笔、人物不超过四个、场景集中、中文不能有翻译腔和模板腔。两个产品交出的稿子字数都落在750到850字之间,三重反转成立、伏笔到位、人物和场景控制达标,语言通顺,没有套话式开头结尾。UP主把两份稿子并排读了两遍,结论是“找不到能把它们分开说的点”。
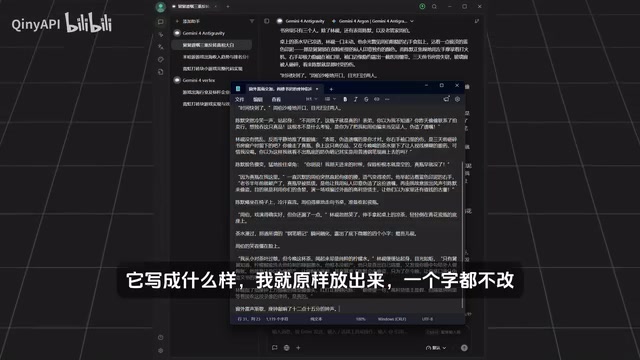
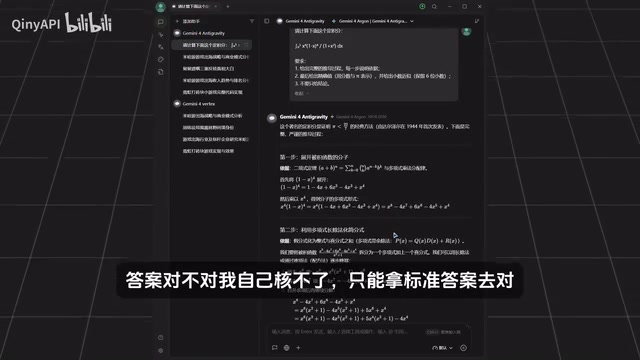
数学题是一道在AI圈流传已久的定积分题。UP主不懂数学,只能拿标准答案比对,重点看推导是否一步步写全、中间有没有跳步。Anti-Gravity和Vertex AI都给出了完整推导,精确值和小数近似均与标准答案一致。UP主也坦承,这类题模型可能见过,所以只能说“这一次算对了”,不能断定它没有被答案带过。
测试的边界:一次结果,不是模型上限
五道题下来,UP主没有找到能把两个产品分开的地方。他在结尾处主动列出了这次测试的局限:五道题难度顺序是自己排的,不是标准评测;每题只跑了一次,没有重复采样,结果可能碰巧偏好或偏差;提示词是随手一问的写法,测的是“随手一问的水平”,不是模型的上限。
这种自我拆台式的坦诚,反而让测试结果更有参考价值。对于普通用户而言,Gemini 4在编码、读图、写作、长文和数学五个方向上都表现出了稳定的可用性——没有明显短板,也没有出现“翻车”。两个产品之间的差异极小,选择哪一个更多取决于你对Google开发者工具链的偏好,而非模型能力本身。
如果非要从这次测试里带走一个结论,那就是:当模型能力普遍越过“能用”的门槛后,产品之间的竞争会落到细节体验上——比如一个屏幕震动效果。而对于评测本身,一次性、不追问、不许联网的方式虽然严苛,但也更接近普通用户真实提问的场景。UP主最后把“哪道题最不公平”抛给了评论区,这个开放式的结尾,或许比任何分数都更有讨论空间。
单次采样与模型评测的局限性
大模型输出具有随机性,同一提示词多次运行可能得到不同结果。文中“每题只跑一次”意味着测试无法区分模型能力的稳定水平与单次运气成分。严格的模型评测通常需要多次采样(如 pass@k 指标)、控制温度参数、使用标准化题库,并引入人工或自动评分。此外,“随手一问”的提示词测的是模型在非精心设计输入下的表现,更接近普通用户场景,但无法反映模型在复杂指令、多轮追问和工具调用下的上限。因此,这次测试的结论应理解为“在本次条件下可用”,而非对 Gemini 4 能力的全面判定。
相关推荐

JetBrains 推出 ThinkRail:开发者效率新工具
JetBrains 在 Hacker News 上曝光新项目 ThinkRail,引发开发者社区关注。本文梳理已知信息、社区反应及其对开发者工作流的潜在意义。

Gemini 4 Argonne 入门教程:从建站到Agent的实战
Gemini 4 Argonne 完整入门教程:演示在 Google AI Studio 一句话构建卡路里追踪应用、用超长上下文审阅 10 页技术文档、在 Anti-Gravity 作为编程 Agent 开发浏览器游戏,并讲解 API Key 获取、定价与各平台订阅门槛。

Cursor、Claude Code、Copilot怎么选?场景对照指南
Cursor、Claude Code、GitHub Copilot怎么选?按日常编码、大重构长任务、团队绑定现有IDE三种场景对照选择,附常见选型误区与组合使用建议。