无线GPU实测:笔记本隔空调用RTX 5090

视频展示无线GPU原型:行李箱内置RTX 5090,通过Wi-Fi让笔记本无感调用远端算力。
一段YouTube视频展示了一台装在行李箱内的「无线GPU」设备,内置NVIDIA RTX 5090,通过Wi-Fi向笔记本提供算力。远端显卡在系统层面直接显示为笔记本的「GPU 1」,无需特殊配置即可被应用调用。作者实测在Wi-Fi链路上运行《赛博朋克》,并用NVIDIA-SMI确认负载落在远端5090上。该方案命名为Wi-Sci(无线计算基础设施),宣称可运行大模型并涉及410TB内存池,但具体实现方式未在素材中展开。文章认为这展示了算力与终端分离的激进形态,但网络依赖、延迟、内存池形态和功耗散热等问题仍待解决,目前更像可行性验证而非可交付产品。
一台笔记本,没有插任何外接线,却能调用一块RTX 5090跑《赛博朋克》,还能加载本不该在这台机器上运行的大模型。这不是科幻,而是一段YouTube视频里展示的「无线GPU」原型。
开箱:行李箱里的RTX 5090
视频作者收到一个装在行李箱里的奇怪设备——外观上看不出是显卡,但内部塞进了一块NVIDIA RTX 5090。他给这台设备的定义是「无线GPU」:把桌面级显卡的计算能力,通过无线网络投送到另一台设备上。
这个思路并不新鲜,云端GPU、远程串流都做过类似的事。但把5090这种级别的卡做成随身携带的无线节点,并且让它在系统层面直接以「本机GPU」的身份出现,体验上的差别是根本性的。
系统识别:它就像笔记本自带的显卡
开机后,作者用一台小尺寸华硕笔记本连接。系统里除了笔记本原有的核显/独显,多出了一个「GPU 1」,识别为RTX 5090。
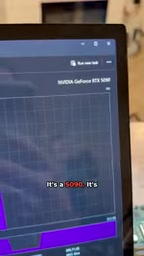
关键在于「无感」:没有装驱动之外的特殊配置,没有手动指定远程渲染管线,任务管理器(或等效工具)里它就是这台笔记本的一块显卡。对上层应用来说,本地GPU和远端GPU的边界被抹掉了——这是这套方案最有价值的部分,也是它区别于传统远程桌面串流的地方。
PCIe与远程GPU的「伪装」机制
现代操作系统和应用程序通过PCIe总线枚举GPU设备,驱动则依赖这一层抽象。要让远端GPU被识别为本地硬件,通常需要在内核层或驱动层实现一个虚拟PCIe设备,将远端传来的计算指令和内存操作映射到本地总线。这涉及复杂的地址转换、中断模拟和DMA重映射。传统远程串流(如Steam Remote Play)是在应用层截取画面和输入,而Wi-Sci这类方案试图在系统层欺骗操作系统,使所有GPU调用(包括CUDA、DirectX、Vulkan)都透明地重定向到远端。这要求极低的协议开销和高效的远程内存访问,否则性能损失会非常明显。
实测:Wi-Fi上跑3A大作
作者直接在笔记本上打开了《赛博朋克》。画面正常渲染,同时他用NVIDIA-SMI查看了GPU占用情况,确认计算确实落在远端那块5090上。
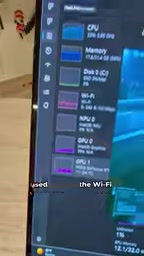
网络层面,整个链路走的是Wi-Fi,而非有线。设备开始负载后风扇明显提速,能听到明显的散热噪音——这说明5090确实在高负载运转,不是在跑一个轻量占位任务。
值得留意的是延迟表现。视频没有给出具体帧率或延迟数值,但从作者能正常游玩来看,Wi-Fi链路的传输质量已经跨过了「可玩」的门槛。当然,这距离电竞级低延迟还有多远,仅凭演示无法判断。
NVIDIA-SMI与远程GPU监控
NVIDIA-SMI是NVIDIA提供的系统管理接口,用于监控GPU利用率、显存占用、温度等。在远程GPU场景中,本地运行的nvidia-smi需要能查询到远端GPU的状态,这要求驱动层将查询请求转发到远端并返回结果。视频中作者通过NVIDIA-SMI确认负载落在远端5090上,说明该方案实现了管理接口的透明重定向。但这也带来安全性和多租户隔离的挑战:如果多个客户端共享同一块远端GPU,如何保证资源隔离和QoS?目前演示仅涉及单客户端,生产环境需进一步设计。
更大的野心:410TB内存池与Wi-Sci
演示不止于游戏。作者提到这套方案的名字叫Wi-Sci,即Wireless Computing Infrastructure(无线计算基础设施),并称它可以运行「本不该在那台小笔记本上运行」的大模型。
他给出的数字是410TB内存——但特意强调「不是你想的那种方式」。这句话的暗示很明确:这410TB大概率不是单机显存,而是某种跨节点聚合的内存池。视频没有展开细节,作者把完整解释留在了视频后段。
如果这个方向成立,它的意义就不只是「远程玩游戏」了。把算力和内存从终端设备上解耦,意味着终端可以做得极轻,而重负载集中调度——这对本地大模型推理、多设备协同计算都是另一条路径。
内存池化与分布式共享内存
410TB内存池很可能指通过高速网络聚合多台机器的内存(包括显存和主存),形成一个统一的虚拟地址空间。这类似于分布式共享内存(DSM)系统,但需要解决缓存一致性、远程直接内存访问(RDMA)延迟和带宽瓶颈。常见实现包括NVLink(有限距离)或基于InfiniBand/RoCE的RDMA over Converged Ethernet。然而,Wi-Fi的带宽和延迟远不及有线网络,因此410TB内存池若依赖Wi-Fi,性能将难以满足大模型推理的需求。作者强调「不是你想的那种方式」,可能暗示采用了分层存储或近内存计算等更复杂的架构,而非简单的网络聚合。
冷静看待:演示与产品之间还有距离
必须承认,这是一段以演示为主的视频,信息密度高但技术细节少。几个悬而未决的问题值得关注:
- 网络依赖性:Wi-Fi链路稳定性、丢包处理、移动场景下的切换能力,都是可用性的前提。
- 延迟上限:游戏能玩不等于所有交互式负载都能跑,专业渲染、实时推理对延迟更敏感。
- 410TB的真实形态:内存池如何组织、带宽多少、一致性如何保证,视频均未说明。
- 功耗与散热:行李箱形态的设备,移动性和供电方案是绕不开的工程问题。
从技术趋势上看,「算力与终端分离」正在被反复尝试。无线GPU把这个概念推到了一个更激进的形态:不是把终端变成瘦客户端,而是让远端算力在系统里伪装成本地硬件。这个思路如果工程化成熟,终端设备的形态和价格结构都可能被重新定义。
但现阶段,它更像一个漂亮的可行性验证,而非可交付的产品。视频里的那句「你得看完整视频才能了解更多」,本身也说明了关键信息还没有被完整披露。
(本文基于YouTube视频内容整理,引用数据均来自视频原话,未经第三方验证。)
瘦客户端与硬件虚拟化的区别
传统瘦客户端(如VDI)将整个桌面会话运行在服务器端,客户端只接收画面流,所有外设和GPU加速都在远端。而Wi-Sci的思路是让远端GPU「伪装」成本地硬件,应用仍在本地CPU上运行,仅将GPU计算卸载到远端。这更接近GPU虚拟化中的「远程GPU」模式(如NVIDIA GRID的某些实现),但后者通常依赖数据中心内的低延迟网络。无线GPU将这一模式扩展到Wi-Fi,挑战在于网络抖动和带宽波动。此外,本地应用与远端GPU之间的数据同步(如纹理上传、帧缓冲回读)会产生大量往返流量,对Wi-Fi是严峻考验。
相关推荐

奥特曼称本地部署不如数据中心,开源AI路线之争再起
奥特曼称开源大模型本地部署不如数据中心集中运算,B站UP主瓜熟迪落拉拆解这一表态背后的技术路线之争与中美AI业态差异,讨论本地部署是否真的该被放弃。

MiniMax H3开源工作流:低显存也能打造呼吸感皮肤
本文介绍B站UP主分享的MiniMax H3双采样工作流,通过融合模型、破线LoRA和低显存节点,解决AI人物面部油腻问题,并让12G显存设备也能运行。包含模型搭配、双采样逻辑与参数设置详解。

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。