无需框架:用Python+Ollama打造本地ReAct AI Agent
用纯Python与本地Ollama从零实现ReAct代理,彻底理解Agent框架背后的运行机制。
本文介绍了一种抛开LangChain等框架、用纯Python手写ReAct代理的教学实践方案。作者拆解了Agent的三个核心要素:LLM作为推理大脑、工具集赋予执行能力、观察循环驱动持续迭代。整个系统基于Ollama在本地运行llama3.2和nomic-embed-text,无需API密钥、无需联网,数据全程留在本机。工程上使用uv管理项目,核心依赖仅需官方ollama包,极为精简。实现要点在于消息列表必须放在循环外维护,每轮循环追加内容以保留完整上下文,这是ReAct循环持续运转的底层基础。该方案的价值不在于替代生产框架,而在于打开"黑盒",帮助开发者真正理解Agent的运作本质。
在AI Agent(智能代理)开发中,LangChain、SmolAgents 等框架几乎成了默认选择。但框架的黑盒特性也让不少开发者难以理解 Agent 的运行本质。一位 B站 UP主 在其教学视频中给出了另一条路径:不依赖任何框架,用纯 Python 配合本地运行的 Ollama,从零手写一个具备工具调用能力的 ReAct 代理。整个流程 100% 本地运行,无需任何 API 密钥。
ReAct 代理的核心组成
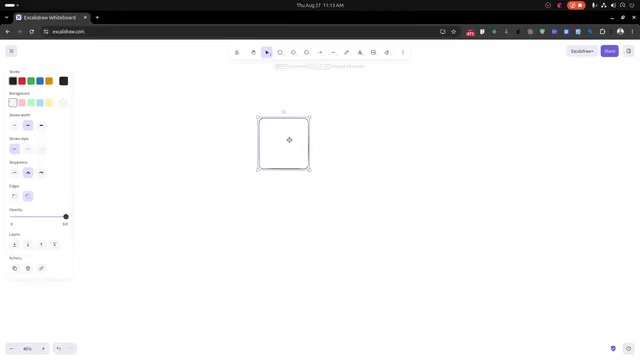
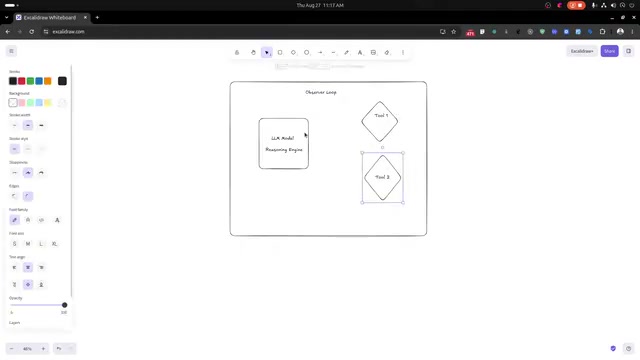
在动手写代码之前,理解 Agent 的骨架比什么都重要。视频作者用一张草图拆解了自定义代理的三个核心要素。
第一个要素是 LLM 模型,它扮演代理的“大脑”——也就是推理引擎(reasoning engine)。所有的判断与决策都由它完成。
第二个要素是工具(Tools)。LLM 模型被授予调用一组工具的权限,这些工具让模型能够执行实际操作,而不只是生成文本。第三个、也是最关键的要素是观察循环(observation loop)。所有的推理与工具调用都发生在这个循环内部:每一轮循环,系统都会检查 LLM 是否产生了“潜在动作”。
所谓潜在动作只有两种可能——要么是调用某个工具,要么是直接生成最终答案。这正是 ReAct(Reasoning + Acting)范式的精髓:模型在“思考”和“行动”之间往复迭代,直到得出结论。理解了这个循环,也就理解了市面上大多数 Agent 框架背后的运行机制。
ReAct(Reasoning + Acting)是 2022 年由 Google Research 提出的一种 LLM 推理范式,论文标题为《ReAct: Synergizing Reasoning and Acting in Language Models》。其核心思想是让模型在每一步同时生成思维轨迹(Thought)和动作(Action),而不是只输出最终答案。具体来说,模型在每轮迭代中会先用自然语言"想"一步(Thought),再决定执行什么操作(Action),执行后将结果作为观察(Observation)反馈回来,如此循环直到得出最终答案(Final Answer)。这种结构使模型的推理过程变得可追踪、可调试,也便于在出错时定位是哪一步的判断有问题。相比纯链式调用(Chain-of-Thought),ReAct 多了"与外部环境交互"的能力;相比纯工具调用,它多了显式的推理步骤。市面上大多数 Agent 框架(包括 LangChain 的 AgentExecutor)本质上都是对这一范式的封装实现。
为什么选择完全本地化方案
作者明确表示不使用 LangChain、SmolAgents 等现成框架,而是自己动手实现。这种做法看似“重复造轮子”,实则有其教学与工程价值。
框架封装了大量细节,方便快速上手,但也让开发者对 Agent 的实际运作缺乏掌控。手写一遍循环逻辑,能真正弄清楚消息是如何在模型与工具之间流转的。
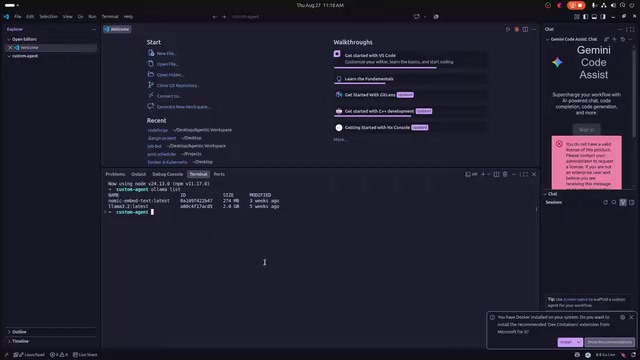
更重要的是运行成本与隐私。方案采用 Ollama 在本地运行大模型,作者本机已安装了 llama3.2 作为语言模型,以及 nomic-embed-text 作为嵌入模型。这意味着整个 Agent 不需要调用 OpenAI 等云端服务,无需 API 密钥,无需联网,也不产生调用费用——数据全程留在本地,对隐私敏感的场景尤其友好。
Ollama 是一个开源的本地大模型运行时,支持在 macOS、Linux 和 Windows 上一键拉取并运行 Llama、Mistral、Gemma 等主流开源模型。其底层基于 llama.cpp,针对 Apple Silicon(M 系列芯片)和 NVIDIA GPU 都有硬件加速优化,普通消费级设备即可流畅运行 7B 到 13B 规模的模型。llama3.2 是 Meta 发布的 Llama 3.2 系列模型,提供 1B 和 3B 两个轻量版本,专为边缘设备与本地推理场景设计,在工具调用(function calling)方面有专项优化,适合作为 Agent 的推理核心。nomic-embed-text 则是 Nomic AI 开源的文本嵌入模型,上下文窗口达 8192 tokens,常用于构建本地向量数据库和语义检索场景。两者配合,可以在完全离线的环境中搭建具备语义理解与工具调用能力的完整 Agent 系统。
环境搭建与代码起步
项目从初始化一个 Python 工程开始。作者使用 uv(一个高性能的 Python 包管理与虚拟环境工具)来初始化项目并创建虚拟环境,随后添加核心依赖——官方的 ollama Python 包。
uv init
uv venv
uv add ollama
这个 ollama 包提供了在 Python 中与本地 Ollama 服务交互的接口,是连接代码与本地模型的桥梁。相比一堆框架依赖,这里的依赖清单极其精简,几乎只需要这一个包。
uv 是由 Astral 团队(也是 Ruff 代码格式化工具的开发者)用 Rust 编写的新一代 Python 包管理工具,定位为 pip + venv + pip-tools 的一站式替代。其最显著的优势是速度——依赖解析和包安装比传统 pip 快 10 到 100 倍,且内置了虚拟环境管理和项目初始化功能。uv init 会创建标准的项目结构和 pyproject.toml 配置文件;uv venv 创建隔离的虚拟环境;uv add 则负责添加依赖并自动更新锁文件,确保环境可复现。对于像本文这样强调"精简依赖"的教学项目,uv 能清晰地显示实际安装了哪些包,避免框架带来的隐式依赖膨胀,让学习者对项目的依赖边界保持清醒认知。
消息循环的设计要点
代理能持续对话和调用工具,关键在于消息(messages)状态的维护。
作者强调了一个容易被忽视的细节:消息列表必须放在循环之外。如果每次循环都重新初始化消息,代理就会“失忆”,无法基于历史上下文推理。正确的做法是——消息在循环外声明,每一轮循环都往这个列表中**追加(append)**新的内容。
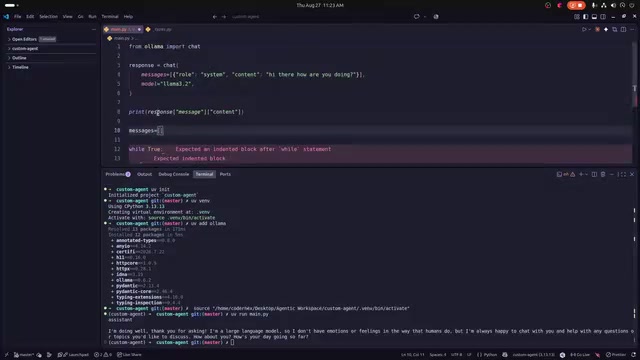
具体流程是:先构建一条系统消息(system message)来定义代理的角色与行为规范,再进入循环。每轮循环中,聊天接口会用更新后的完整消息列表去调用模型,模型返回的响应又会被追加回消息列表,形成不断累积的上下文。这个“调用—响应—追加”的闭环,正是 ReAct 循环得以持续运转的底层机制。
小结
这个案例展示了一条务实的学习路径:抛开框架,用最少的依赖亲手实现一个本地 ReAct 代理。它的价值不在于替代生产级框架,而在于把 Agent 的“黑盒”打开——LLM 作大脑、工具作双手、循环作心跳,三者协同的逻辑一旦想通,再去理解和使用任何框架都会事半功倍。
需要说明的是,本文基于视频教学的前半部分整理,涵盖了设计思路与环境搭建阶段;完整的工具定义、动作解析与循环终止逻辑还需结合作者后续的实际编码来补全。对想深入理解 Agent 原理、又不愿被云端 API 束缚的开发者来说,这是一个值得动手复现的起点。
相关推荐
Qwen 27B 本地部署实测:开源大模型能否替代 GPT-4?
Qwen 27B 开源大模型本地部署实测:一条命令用 Ollama 安装,混合注意力支持 262K 长上下文,代码审计任务响应快于 GPT-4,三年成本对比显示本地方案更省钱。开发者本地 AI 部署完整指南。
177B大模型跑在廉价显卡上?Qwen3 Flash Next本地部署实测
B站UP主实测用两块廉价显卡加32GB内存本地运行177B参数的Qwen3 Flash Next模型,通过将51B Ngram表卸载到SSD,实现22 tokens/s推理速度。本文解析其架构拆分、llama.cpp部署参数与性能表现。
MiniMax H3登陆Draw Things:Mac/iPad本地跑开源最强音视频模型指南
开源最强音视频模型MiniMax H3已在苹果AI工具Draw Things正式支持。本文详解首尾帧与参考生成两种版本、加速LoRA选择、M系列芯片硬件门槛及LLM提示词技巧,帮Mac/iPad用户判断能否本地运行。