无需上传云端:用本地AI对话你的Obsidian笔记

OGAD 用只读连接让本地模型直接读取 Obsidian 文件夹,笔记不出本机即可问答。
OGAD(Off Grid AI Desktop)提供了一条不把笔记上传云端的替代路线:连接本机 Obsidian 文件夹后,为模型配备列出、搜索、读取笔记的工具,由模型按需调用,而非把整库塞进上下文。连接是只读的,编辑仍在 Obsidian 内完成;它也不保证解析插件、画布、附件与图谱,只擅长普通 Markdown。使用需桌面版且含该集成,文件须是真实本地文件而非云占位符。建议先用三篇笔记做小规模验证,要求回答给出文件名、日期与支撑段落,并回到 Obsidian 核实。隐私保障取决于所选模型:本地模型把推理留在家,远程模型可能收到笔记文本;自行云同步也会影响隐私边界。
把笔记库交给云端AI处理,隐私顾虑始终挥之不去。OGAD(Off Grid AI Desktop)提供了一种替代思路:让本地模型直接读取你电脑上的Obsidian文件夹,笔记不出本机,问答照常进行。
它是怎么工作的
核心机制并不复杂。OGAD连接到你指定的Obsidian文件夹后,会赋予所选模型一组工具:列出笔记、搜索文件名和内容、读取指定笔记。连接文件夹不等于把每篇笔记都塞进对话上下文——模型是按需读取的。
这个连接是只读的。编辑笔记仍然回到Obsidian里完成,OGAD不会写回任何内容。它也不承诺理解所有插件、画布、附件或图谱关系,普通Markdown文本才是它擅长的领域。
有一点容易混淆:Obsidian笔记库是磁盘上的一个文件夹,和OGAD那个加密的密码Vault是两回事。选择Obsidian文件夹不会把它搬进密码数据库。
工具调用(Tool Calling) 是指模型在生成回答的过程中,主动请求执行外部函数并接收其返回结果的能力。普通对话模型只能基于训练时记住的知识或当前上下文作答,而支持工具调用的模型可以在回答前先「决定」去调用搜索、读取等工具,把真实数据取回来再组织语言。OGAD 正是借此把「列出笔记、搜索文件名和内容、读取指定笔记」这几件事包装成模型可调用的工具,由模型自行判断何时调用、调用哪个、传入什么参数。这也是为什么文章反复强调要选「支持工具调用的本地文本模型」——如果模型只会聊天而不具备这一能力,它就无法真正去读你的笔记,只能凭空作答。
只读连接与「按需读取」 是理解 OGAD 隐私模型的关键。「只读」意味着 OGAD 只向文件系统申请读取权限,没有任何写入、删除或改名的通道,所以你的笔记在 OGAD 侧不可能被意外覆盖,编辑工作始终由 Obsidian 完成。而「按需读取」指的是:连接文件夹只是在 OGAD 内部登记了一个可访问的路径,并不会把成百上千篇笔记一次性加载进模型的上下文窗口。只有当你提出问题时,模型才通过工具去搜索命中的少数文件并读取其正文。这既节省了上下文空间,也缩小了单次推理实际接触到的笔记范围——不过要注意,只要是被读取到的内容,就会进入该次对话,进而影响隐私边界。
连接与配置
需要桌面版OGAD,且版本包含Obsidian集成代码。笔记必须是真实的本地文件——如果文件只是云存储的占位符,得先完成下载,本地读取器才能用。
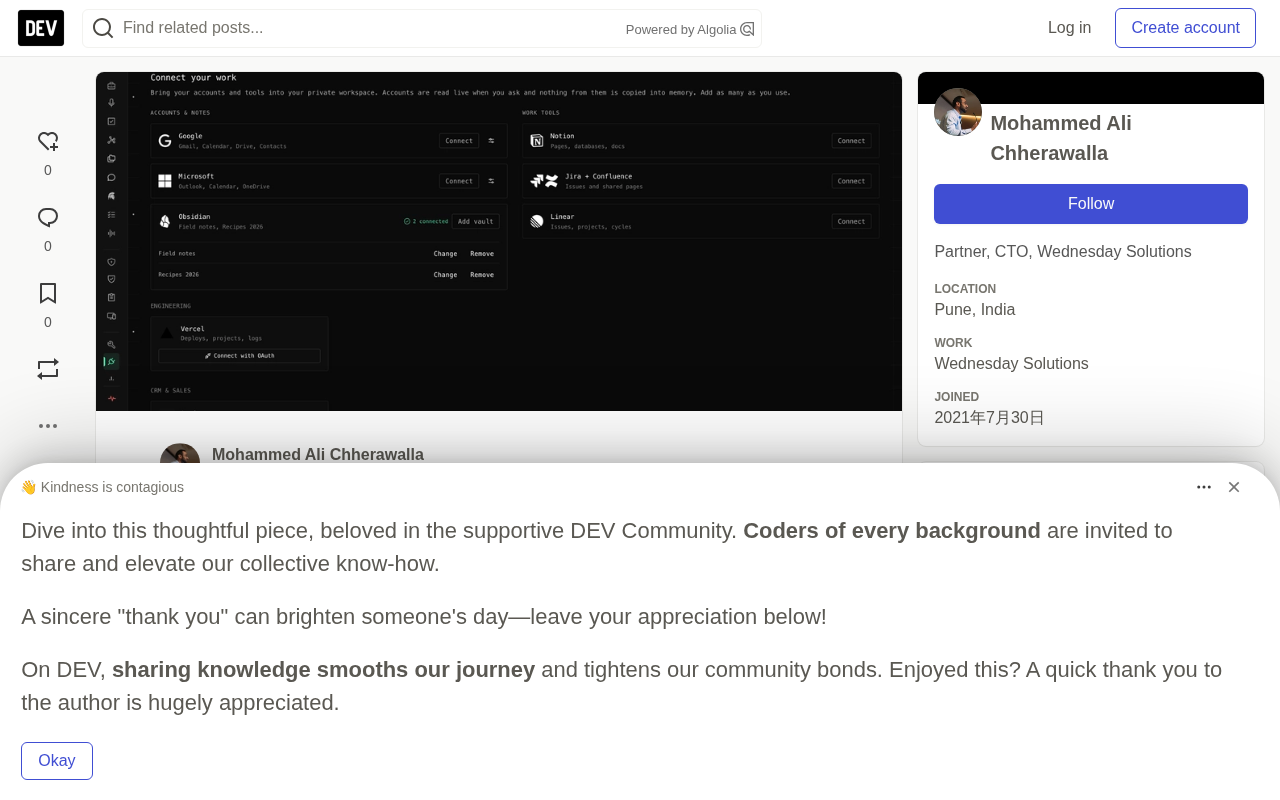
操作路径很直接:在OGAD中打开Integrations,找到Obsidian,选择包含Markdown笔记的文件夹,确认卡片显示已连接,然后选一个支持工具调用的本地文本模型,打开对话即可。
整个过程不需要Obsidian云账号或API密钥。App和模型下载阶段需要联网,之后用已下载的本地模型读取已下载的笔记,断网也能工作。
从可验证的问题开始
建议先拿一个小型项目试手——三篇笔记就够:项目简报、会议决策、待解决问题。第一个问题聚焦单一决策:
在我的Obsidian笔记库中搜索启动审查。关于注册表单我们决定了什么?回答前先读取相关笔记。给出每个决策的文件名和日期,引用支撑它的简短段落。如果两篇笔记有冲突,都展示出来。
拿到回答后,去Obsidian里打开它提到的文件,核实段落确实存在,日期含义和回答一致。注意:文件的修改时间不等于决策做出的时间。
如果回答只是重复你的问题,或者说无法访问笔记,先检查这个集成是否对该对话启用,再确认模型是否真的支持工具调用。能聊天的模型不一定能正确使用搜索和读取工具。
用笔记支撑下一步行动
第一个回答有可靠出处之后,可以问需要跨笔记综合的问题。比如对比原始项目简报和最新审查记录,哪些需求变了,哪些待解决问题仍在阻塞工作。
一个实用的输出格式是四列表格:需求、原始立场、最新证据、下一个问题。让助手从你的笔记中填充这个表格,但不要接受没有来源的完整行。如果找不到更新的决策,「在已读笔记中未找到」比编造一个更新更有价值。
之后可以要求生成会议议程或项目更新草稿。在核实之前,草稿里保留来源文件名。确认后的文本自己复制回Obsidian——这个只读连接不会替你写入。
多笔记库与搜索边界
用Add vault可以连接更多文件夹。工作和个人笔记库可以保持独立。提问时指定笔记库名称,尤其是两边都有「规划」「周报」这类常见词的时候。比如「只在Field notes中搜索启动决策」,范围清晰,结果缺失时也更容易定位原因。
移动笔记库后,用Change或Choose again恢复访问。移除连接会停止后续读取,但不会删除原始笔记,也不会抹掉已保存对话中复制过去的文本。
搜索工具搜的是文本,不保证一个宽泛短语能命中所有相关概念。试试项目名、人名,或者你记得的笔记中的确切术语。第一次搜不到就换个词再搜。大笔记库和超长笔记有读取与搜索上限,把请求缩窄到某个文件夹、项目或已知文件名,并问清楚模型实际读了哪些文件。部分搜索的结果,不能当成「这个决策从未存在」的证据。
隐私的边界在哪
隐私条件取决于你选的模型。远程模型可能收到回答所需的笔记文本;本地模型则把推理留在你的电脑上。另外,如果你自己通过云服务同步Obsidian,那个服务仍然是你笔记存储方案的一部分。
OGAD的Obsidian集成解决的是一个具体问题:你记得某个决策在笔记里,但不记得在哪个文件。本地文件夹连接加上本地模型,让你在不出本机的前提下把这个问题问出来,再回到Obsidian打开原文。从你记得的一个决策开始,核实它的出处,然后用同样的方法处理还没解决的问题。
「本地模型」与「远程模型」的区别并非绝对的安全与不安全,而是数据流向的不同。 本地模型(通过 Ollama、LM Studio 等运行的模型)把权重文件和推理计算都放在你本机,笔记文本从磁盘读取后直接进入本机内存和显存,理论上不经过网络。远程模型则通常以 API 形式调用,你为回答而检索到的笔记片段会被作为请求内容发送到服务商的服务器,对方是否记录、保留多久取决于其隐私政策。因此唯一合规的做法是:先想清楚某次问答会读到哪些笔记,再决定要不要用远程模型。此外,同步环节也常被忽略——即便 OGAD 本身不上传,若你用 iCloud、OneDrive 或 Obsidian Sync 同步笔记库,这些云端服务仍持有你的笔记副本。
相关推荐

AI数字分身实战:用DOT自动追踪Bug与用户反馈
DOTS 团队工程师演示如何用 AI 数字分身 DOT 跨平台收集用户反馈、自动归类问题主题、开线程调查 Bug 根因并直接提交 PR,展示 AI 代理参与缺陷分诊的完整工作流与可审计设计。

晶体管为何不再扁平?从平面到环绕栅极的演进
晶体管从平面到FinFET再到环绕栅极的演进:为何栅极需要从三面包裹到四面环绕,以抑制短沟道效应和泄漏电流,延续摩尔定律。

蜂群思维=单个RL智能体?多臂老虎机等价性证明
一篇论文证明蜂群通过局部模仿进行的集体决策,在数学上等价于单智能体强化学习。N个盲目模仿者相当于N个并行环境采样,有效学习率为1/N。本文解读Maynard-Cross Learning算法的推导与影响。