XERJ:AI搜索数据新方式,Token消耗降低40倍

开源项目XERJ用autoindex索引替代grep,声称为AI Agent节省40倍Token。
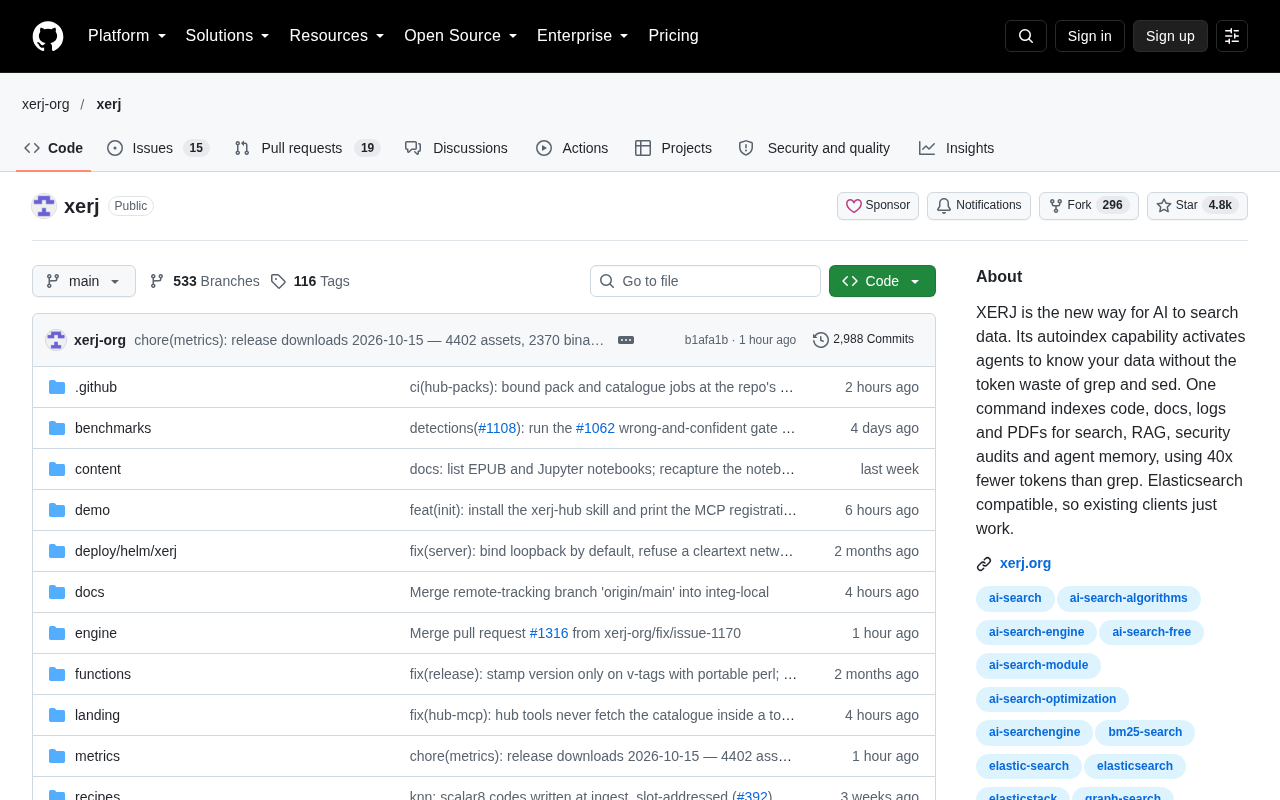
XERJ是一个用Rust编写的开源项目,定位为"AI搜索数据的新方式",核心是autoindex自动索引技术。它针对AI Agent处理代码、文档、日志和PDF时Token消耗过高的痛点,声称相比传统grep方式可节省40倍Token,从而降低推理成本、提升响应速度。项目兼容Elasticsearch协议,现有客户端可直接对接,迁移门槛极低,并覆盖搜索、RAG、安全审计和Agent记忆等场景。凭借单一工具统一处理多种数据源的定位,XERJ在GitHub上线后增长迅速,已获4751颗星、295次fork,单日新增725星,但其"40倍"效果仍需真实场景基准测试验证。
在AI代理(Agent)逐渐成为开发者日常工具的当下,一个被忽视的瓶颈正在浮出水面:数据搜索的Token成本。无论是让AI阅读代码库、检索日志,还是从PDF中提取信息,传统的 grep 和 sed 方式都需要将大量文本塞入上下文窗口,Token消耗惊人。GitHub上一个名为 XERJ 的开源项目正在尝试解决这个问题。
XERJ是什么?
根据项目仓库的描述,XERJ 定位为"AI搜索数据的新方式"。它的核心能力叫做 autoindex(自动索引):只需一条命令,就能对代码、文档、日志和PDF建立索引,供搜索、RAG(检索增强生成)、安全审计以及Agent记忆等场景使用。
最关键的卖点在于:相比grep,XERJ声称可以节省40倍的Token。这意味着AI代理在获取同等信息量的前提下,上下文窗口的占用大幅降低,直接影响到推理成本和响应速度。
项目采用 Rust 编写,当前在GitHub上已获得 4751 颗星、295 次fork,单日新增725颗星,增速相当可观。
RAG(Retrieval-Augmented Generation,检索增强生成) 是一种将外部知识检索与大模型生成结合的技术范式:系统先根据用户问题从知识库中检索相关片段,再把这些片段作为上下文交给模型生成答案。它的价值在于让模型访问训练数据之外的最新或私有信息,同时减少幻觉。RAG的效果高度依赖检索层的质量——检索得越准,模型需要的上下文就越少,Token成本也就越低。这正是XERJ这类索引工具切入的位置:它并不直接做生成,而是为RAG提供更高效、更精准的检索底座。
为什么Token效率如此重要?
要理解XERJ的价值,需要先看清AI Agent处理数据时的真实困境。
当一个Agent需要在一个大型代码库中定位某个函数的定义时,传统做法是执行 grep 搜索,返回匹配行及其上下文。这些内容全部要进入模型的上下文窗口,而大型项目的一次搜索结果动辄数千行,Token消耗迅速累积。对于需要反复搜索、多轮交互的Agent工作流来说,成本会成倍放大。
XERJ的思路是用索引替代暴力搜索。预先建立的结构化索引让Agent可以直接查询所需信息,而无需将原始文本大量搬入上下文。官方给出的"40倍Token节省"正是这一思路的直接收益。
上下文窗口(Context Window) 是大语言模型单次推理能够处理的最大Token数量,包括输入提示和输出结果。主流模型的上下文窗口从几千到几十万Token不等,但无论窗口多大,输入Token都会按量计费,且窗口占用越高,推理延迟越大、成本越贵。这就是为什么Agent工作流中"把大量原始文本塞进上下文"的做法难以为继:一次grep可能返回数千行代码,几轮交互下来就轻易耗尽预算。索引化检索的本质,是把"让模型读原文"变成"让模型读结构化结果",用更少的Token承载同等甚至更精确的信息。
Elasticsearch兼容:降低迁移门槛
XERJ有一个容易被忽略但极具实际意义的特性:Elasticsearch兼容。
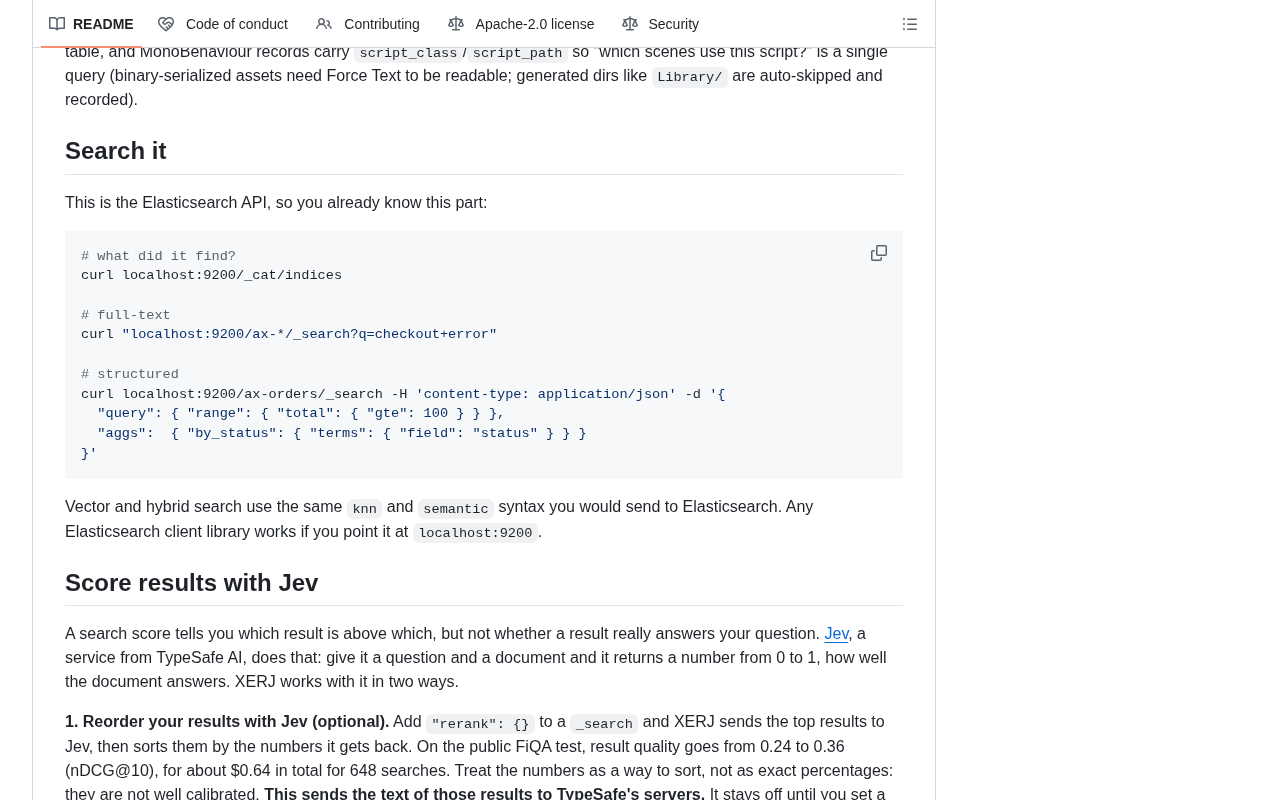
这意味着已有的Elasticsearch客户端无需修改即可直接对接XERJ。对于大量使用Elasticsearch做日志分析和全文检索的团队来说,这消除了迁移的技术阻力。你不需要重写查询逻辑,也不需要更换客户端库,替换后端即可获得XERJ带来的Token效率提升。
从工程角度看,这个决策相当务实。搜索领域的基础设施已经高度标准化,另起炉灶构建全新协议只会增加采用成本。兼容现有生态,让XERJ可以直接嵌入已有的技术栈。
Elasticsearch 是基于Apache Lucene构建的分布式搜索与分析引擎,广泛用于日志分析(常与ELK栈配合)、全文检索和可观测性场景。它的核心抽象是索引(index)、文档(document)和基于JSON的查询DSL,生态中包含大量官方与第三方客户端库。所谓"Elasticsearch兼容",通常指目标系统能够识别Elasticsearch的REST API和查询语法,因此现有客户端、仪表盘和查询语句无需改写即可指向新后端。这种兼容策略在基础设施领域很常见,它把"是否采用"的决策从"重写整套检索逻辑"降级为"换一个服务地址",显著降低了团队评估和试用的心理与工程成本。
多场景覆盖:从RAG到Agent记忆
XERJ声称支持的数据类型覆盖了当前AI应用的主流需求:
- 代码索引:让AI编程助手快速定位函数、类、变量定义,减少无关代码的上下文占用
- 文档与PDF:为知识库问答和RAG提供高效的检索层
- 日志检索:面向运维和安全审计场景,快速定位异常事件
- Agent记忆:为长期运行的Agent提供持久化的信息存取能力
这种"一个工具覆盖多种数据源"的设计,减少了团队在多个专用工具之间切换的负担。一条索引命令统一处理代码、文档、日志和PDF,在工程效率上有明显优势。
Rust加持的性能基础
项目选择Rust作为实现语言,这对于需要处理大规模数据索引和高速检索的工具来说是合理的技术选型。Rust在内存安全和并发性能方面的优势,使得XERJ能够在建立索引和执行查询时保持较低的运行时开销。
不过,Rust也意味着较高的贡献门槛。对于一个仍处于早期阶段的开源项目而言,社区能否围绕Rust生态快速积累贡献者,将影响其功能迭代速度。
向量检索与混合搜索 是当前降低Agent数据获取成本的两条主流技术路线。向量检索把文本编码为高维向量,通过近似最近邻(ANN)算法按语义相似度召回内容,擅长处理模糊语义匹配;传统关键词检索(如倒排索引)则擅长精确匹配和结构化过滤。混合搜索将两者结合,兼顾语义召回与关键词精度。XERJ所采用的autoindex更偏向结构化/倒排索引路线,强调的是用精确索引减少无关内容进入上下文。不同路线各有取舍:向量检索语义能力强但需要嵌入模型和额外算力,结构化索引则更轻量、更可控,但依赖索引质量。理解这一分野,有助于判断XERJ在具体场景中是否比向量方案更划算。
竞争格局与观察
XERJ切入的是一个正在升温的赛道。随着AI Agent从演示走向生产环境,Token成本优化已经成为绕不开的工程问题。目前已有多个项目在尝试用向量检索、混合搜索或结构化索引来降低Agent的数据获取成本。
XERJ的差异化在于三点:一是明确对标grep并给出量化的Token节省数据;二是兼容Elasticsearch降低采用门槛;三是用单一工具覆盖多种数据类型。这些组合在一起,构成了一个相对清晰的价值主张。
但项目当前仍需要更多实际使用案例来验证"40倍"这一数字在不同场景下的普适性。不同数据规模、不同查询模式下,Token节省效果可能存在显著差异。对于考虑采用的团队来说,建议在自己的真实数据集上进行基准测试后再做决策。
项目地址:github.com/xerj-org/xerj
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。