习近平倡议金砖国家建设开源AI合作区
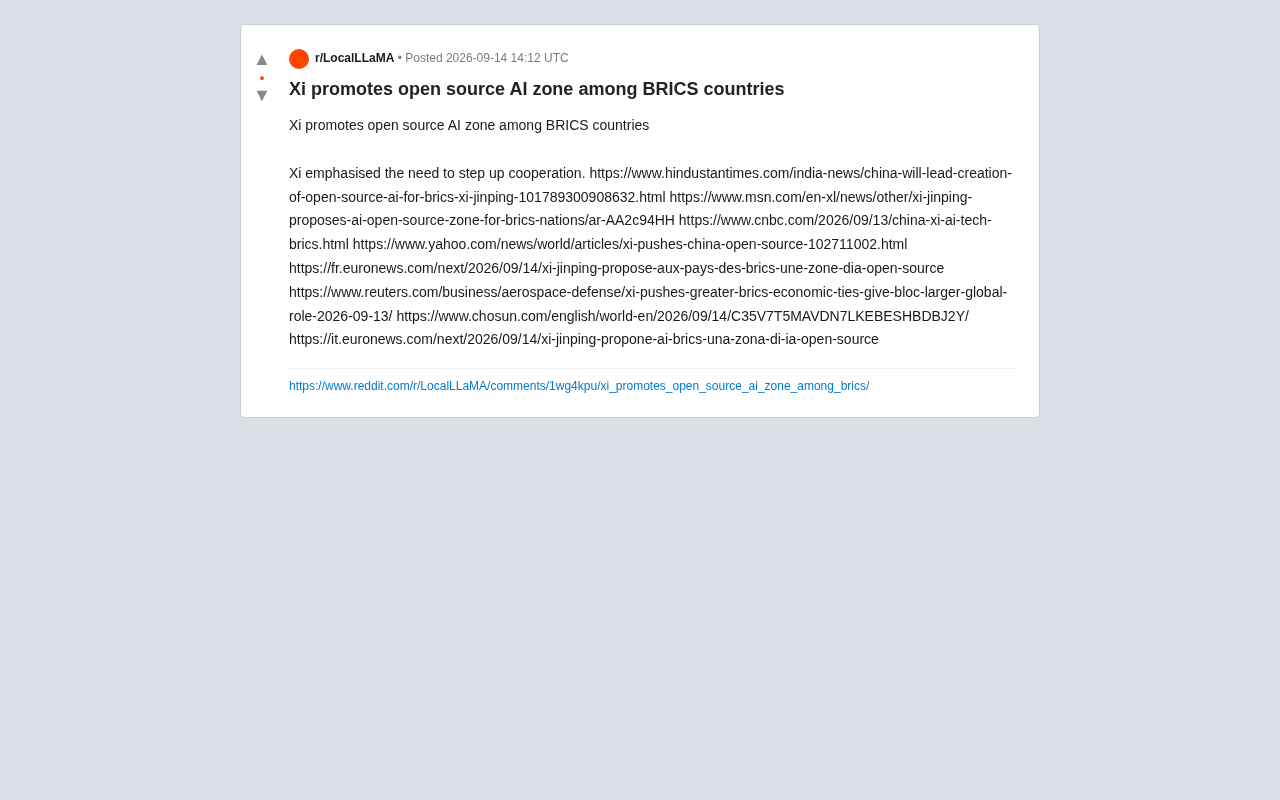
习近平在金砖峰会倡议建立开源AI合作区,以开源多边合作对抗西方技术封锁并争夺全球AI标准话语权。
在近期金砖峰会上,习近平提出建立"开源AI合作区",核心逻辑是以开源共享替代西方主导的闭源商业模式,帮助新兴经济体降低AI技术门槛。中国已借助DeepSeek、通义千问等开源模型构建起相当规模的开源生态,此次提议实质上是将这套生态向金砖国家输出,同时在数据治理和AI标准等领域构建有别于西方的规则体系。然而,成员国间技术水平与利益诉求的差异、数据主权顾虑,以及"开源"边界不清晰等现实障碍,使该提议短期内更多停留于政治宣示层面。分析人士指出,此举折射出全球AI竞争正从单纯技术比拼演变为闭源商业与开源多边两套生态阵营的深层角逐。
金砖峰会上的AI新提议
在近期的金砖国家(BRICS)领导人会晤中,中国国家主席习近平提出了一项引发国际科技界广泛关注的倡议:在金砖成员国之间建立一个「开源人工智能合作区」(open source AI zone)。据路透社、CNBC、印度斯坦时报及多家欧洲媒体的报道,习近平强调金砖国家需要在AI领域加强合作,共同应对技术发展带来的机遇与挑战。
这一提议的核心在于「开源」二字。与美国主导的、以闭源大模型和技术封锁为特征的AI生态不同,金砖框架下的开源AI合作区旨在通过共享底层模型、数据集和开发工具,降低成员国的技术门槛,推动南方国家在AI浪潮中获得更大的话语权。
为何选择「开源」路线
开源模式的选择并非偶然。当前全球AI竞赛中,算力、数据和顶尖人才高度集中在少数发达经济体,许多发展中国家面临「用不起、用不上」的困境。开源路线的意义在于,它让技术能力较弱的国家也能在现有模型基础上进行本地化改造和二次开发,而无需从零构建。
据CNBC的分析,中国近年来在开源AI领域的布局日益积极——从DeepSeek到通义、GLM等一系列开源模型的推出,已经形成了相当规模的开源生态。将这套生态推广至金砖国家,既是技术输出,也是构建以中国为中心的AI标准与话语体系的战略举措。
开源作为地缘技术工具
值得关注的是,欧洲媒体(如euronews的法语和意大利语版本)在报道中都将这一提议置于更宏观的地缘政治框架下解读。在美国不断收紧对华芯片和AI技术出口的背景下,中国转而通过开源和多边合作来突破封锁、扩大影响力。开源在这里不只是一种技术哲学,更成为一种规避技术脱钩、重塑全球供应链的工具。
DeepSeek是中国人工智能公司深度求索于2024年底至2025年初推出的一系列开源大语言模型,其中DeepSeek-R1因以远低于GPT-4的训练成本实现可比性能,在国际AI社区引发广泛关注。通义千问(Qwen)是阿里巴巴旗下的开源模型系列,GLM系列则由清华大学和智谱AI联合开发。这三个项目均将模型权重完全公开发布,允许任何机构下载、微调和商业部署,与Meta的LLaMA模型共同构成了当前全球最活跃的开源大模型生态。中国在开源大模型上的密集投入,一方面源于国内企业在英伟达高端芯片受限后对「以开放换生态」的主动选择,另一方面也使中国在开源社区中积累了相当的技术声誉和标准影响力,为向金砖国家输出这套生态奠定了基础。
金砖扩员后的战略意图
路透社的报道指出,习近平此次不仅谈及AI,还推动金砖国家加强整体经济联系,赋予该集团更大的全球角色。随着金砖机制近年来的扩员,成员国覆盖了亚洲、非洲、南美和中东的多个新兴经济体,其在全球人口和GDP中的占比持续上升。
在这样的背景下,AI合作区被视为金砖集团从「经济合作平台」向「技术标准联盟」升级的尝试。如果这一设想落地,金砖国家有望在数据治理、AI伦理、模型标准等领域形成不同于西方的规则体系,从而在全球AI治理格局中占据一席之地。
2023年金砖峰会宣布扩员,沙特阿拉伯、伊朗、埃塞俄比亚、埃及、阿联酋和阿根廷(后因政府更迭婉拒加入)受邀成为正式成员,使核心成员国从5个增至10个。此轮扩员后,金砖国家合计涵盖全球约45%的人口和约35%的GDP(按购买力平价计算),并在石油出口和关键矿产供应链上占据举足轻重的地位。扩员的地理覆盖——从中东产油国到非洲人口大国——使金砖集团获得了构建独立技术标准联盟所需的市场规模和资源多样性。AI合作区的提议正是在这一扩员红利尚未充分转化为实质合作的窗口期出现,体现出中国希望为扩大后的金砖框架注入技术合作实质内容的战略考量。
潜在的挑战与不确定性
尽管愿景宏大,开源AI合作区的落地仍面临不少现实障碍。首要问题是成员国之间技术水平和利益诉求的差异——印度、巴西等国在AI发展路径上有各自的考量,未必愿意完全依附于中国主导的技术生态。
其次是数据主权与安全的顾虑。开源意味着一定程度的技术透明和共享,但各国对本国数据的跨境流动都持谨慎态度。如何在共享与保护之间找到平衡,将直接决定合作区的可行性。
此外,「开源」本身的边界也值得追问:模型权重开源不等于训练数据和核心算力开源,真正决定AI能力的关键环节是否会被纳入共享范围,目前尚无明确细节。这些悬而未决的问题,使得该提议在短期内更多停留在政治宣示层面。
「开源」在AI领域并没有统一的法律或技术定义,实践中存在明显的层次差异。最宽松的形式仅公开模型权重(即神经网络的参数文件),允许他人运行和微调,但不包含训练数据、训练代码或完整的技术报告——Meta的LLaMA系列即属此类,其许可证还附带商业限制条款。更彻底的开源则要求同步公开训练数据集、数据清洗流程和完整复现代码,目前做到这一程度的大型模型极少。真正决定模型能力上限的往往是训练算力(即高端GPU集群的可及性)和数据质量,这两者都难以通过简单的「开源」实现共享。因此,当金砖开源AI合作区宣称「共享底层模型」时,其实际赋能程度高度依赖于最终公开内容的边界,而这正是目前尚无明确细节的核心问题。
对全球AI格局的深远影响
无论最终落地程度如何,这一提议本身已经释放出清晰信号:全球AI竞争正在从单纯的技术较量,演变为技术标准与生态阵营的角逐。西方以OpenAI、Google为代表的闭源商业模式,与中国推动的开源多边合作模式,可能会在未来形成两套并行甚至竞争的AI生态。
对于广大发展中国家而言,多一种技术选择未必是坏事。开源生态确实降低了参与AI革命的门槛。但技术从来不是中立的——依附于哪一套生态,往往也意味着接受相应的标准、规则乃至价值取向。习近平此次的倡议,正是这场全球技术博弈的一个缩影。
相关推荐
ComfyUI Prompt Studio:从参考图到可用提示词的工作流
ComfyUI Prompt Studio 是一款开源工作流工具,能从参考图和简单创意自动生成可投产的图像提示词、多模型定制提示和 MiniMax 视频脚本,支持忠实重建与自由创作两种模式。
RSI短期不会发生?新论文用NeurIPS实验给出否定答案
一篇新论文让AI智能体重做未发表的NeurIPS论文并由原作者评分,结果显示当前智能体无法胜任开放式ML研究,据此论证递归自我改进(RSI)短期内不会发生。本文解析其实验设计、核心论证与局限。
K2 Horizon 7B:小体量模型跑出中量级智能水平
K2 Horizon 7B 在 Artificial Analysis 智能指数上排名介于 Qwen 3.6 27B 与 35BA3b 之间,用 70 亿参数逼近数倍体量模型的表现,成为本地部署用户的高性价比选择。