稀疏注意力协同设计:破解长上下文推理效率瓶颈
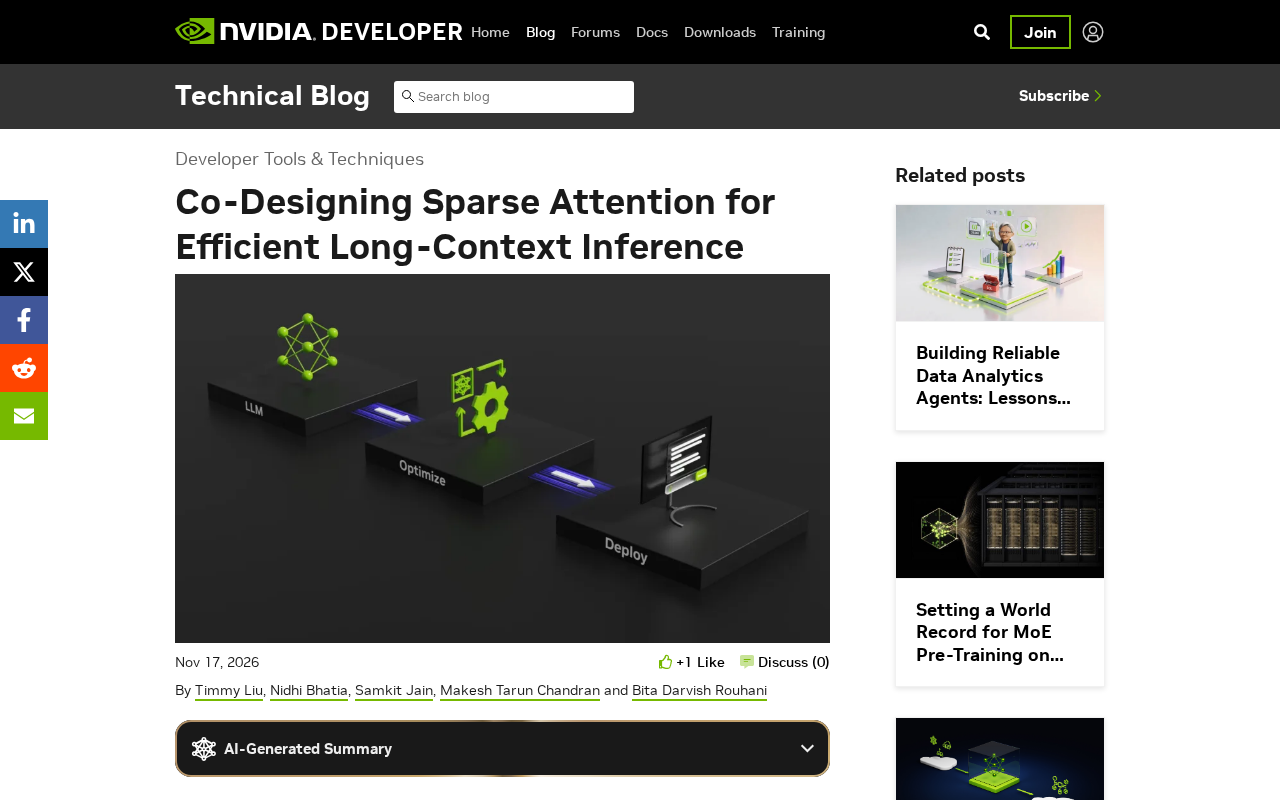
长上下文推理的真正瓶颈是注意力模式与硬件访存错配,稀疏注意力需算法硬件协同设计。
文章指出,长上下文推理的瓶颈不只是注意力计算的平方级复杂度,更在于稀疏模式与 GPU 访存特性之间的错配。NVIDIA 提出的协同设计要求算法设计者在设计稀疏结构时同步考虑内存层次、线程调度与数据布局,并权衡稀疏度提高后索引元数据开销反噬收益的拐点。文章进一步区分 prefill 与 decode 两个阶段:前者吃算力、后者吃显存带宽,稀疏策略需分别调整,且 KV Cache 占用往往比注意力计算更早成为限制。对开发者而言,应在本机硬件和真实负载上验证端到端延迟与显存占用,而非只信论文加速比,并把协同设计思路延伸到批处理、KV Cache 管理与算子融合等整个推理栈。
长上下文推理的现实困境
Agentic 工作负载、长文档处理和大规模代码库分析,正把大模型的上下文长度从数万 token 推向数十万 token。长度增加带来的不只是显存压力,注意力机制本身的计算复杂度也在以平方级增长。NVIDIA 开发者博客在其最新技术文章中指出,单纯把序列塞进更长的窗口并不能解决问题,真正的瓶颈在于注意力计算与硬件访存之间的错配。

这也解释了为什么稀疏注意力重新成为研究热点。它通过只计算部分注意力连接来降低开销,但稀疏模式选得不好,反而会让 GPU 的并行单元空转。
为什么稀疏注意力需要“协同设计”
算法与硬件的错位
稀疏注意力的核心思路并不新鲜:跳过那些贡献较小的注意力权重,只保留关键连接。问题在于,不同稀疏模式对硬件极不友好。块稀疏、结构化稀疏、动态稀疏在数学上都能成立,但落到张量核心和显存带宽上,表现差异巨大。一个在理论上 FLOPs 更低的方案,可能因为访存不连续而实际更慢。
NVIDIA 文章强调的“协同设计”(co-design),正是要求算法设计者在设计稀疏模式时,同步考虑目标硬件的内存层次、线程调度和数据布局,而不是先设计算法再指望编译器优化。
块稀疏、结构化稀疏与动态稀疏的区别:块稀疏把注意力矩阵划分成固定大小的块,整块保留或跳过,索引元数据少、访存连续,对张量核心友好;结构化稀疏进一步约束稀疏模式(如每行保留固定数量的连接),便于用规则化的掩码和专门的硬件指令加速;动态稀疏则根据输入内容实时决定保留哪些连接,灵活但索引结构随输入变化,访存不规则,往往需要额外的 gather/scatter 操作。三者在理论 FLOPs 上可以接近,但在 GPU 上的实际效率取决于内存合并访问、warp 内线程负载均衡以及索引数据的存放位置(片内还是显存),这正是“协同设计”需要权衡的地方。
稀疏度的代价
稀疏并非免费的午餐。跳过计算意味着需要额外的索引结构来记录哪些位置被保留,这些元数据的访存开销在极端稀疏度下可能反噬收益。协同设计的关键权衡在于:稀疏度提到多高时,索引开销开始超过节省下来的计算量。这个拐点与硬件架构强相关,也是通用稀疏方案难以跨平台移植的原因。
稀疏度与索引开销的拐点:稀疏度通常指被跳过的注意力连接所占比例。稀疏度越高,需要保留的连接越少,但记录这些连接位置的索引(行偏移、列索引、块掩码等)在总访存中的占比会上升。在极端稀疏的情况下,读取索引和间接寻址的开销可能超过直接计算稠密注意力,收益转为负值。该拐点取决于硬件的缓存层次、访存带宽与计算单元的比例,以及索引是压缩存储还是按字节对齐存储,因此同一稀疏方案在不同 GPU 代际上的最优稀疏度并不相同,这也是通用稀疏库难以跨平台取得一致加速的原因。
从理论收益到实际吞吐
长上下文推理的评估不能只看单次前向的 FLOPs。在真实服务场景中,prefill 阶段和 decode 阶段的瓶颈完全不同:prefill 更吃算力,decode 更吃显存带宽。稀疏注意力对两个阶段的收益并不对称,协同设计需要分别针对两个阶段调整稀疏策略。
文章还提到,长上下文场景下 KV Cache 的显存占用往往比注意力计算本身更早成为限制因素。稀疏注意力如果能与 KV Cache 的压缩或淘汰策略配合,收益会叠加;反之,两者各自为战可能互相抵消。
prefill 与 decode 的瓶颈差异:prefill 阶段一次性处理整段提示词,所有 token 并行参与注意力计算,属于计算密集型,瓶颈在矩阵乘的算力利用率;decode 阶段逐 token 自回归生成,每步只处理一个新 token,但需要读取全部历史 KV Cache,属于显存带宽密集型,瓶颈在数据搬运而非计算。因此稀疏注意力在 prefill 中主要节省计算量,在 decode 中则要通过减少 KV 读取来获益;若稀疏模式不能降低实际读取的 KV 数据量,decode 阶段的加速就会非常有限。KV Cache 压缩(如量化、低秩表示)与淘汰(如滑动窗口、基于重要性的驱逐)正是针对 decode 带宽瓶颈的手段,与稀疏注意力配合时可叠加收益。
对开发者的实际启示
对一线开发者来说,这类研究的价值在于提示:不要直接把论文里的稀疏注意力实现搬进生产环境。需要在自己的硬件和目标负载上验证稀疏模式的实际吞吐,尤其关注 decode 阶段的延迟表现,而不是只看论文里的加速比。
同时,长上下文能力的提升不能只依赖注意力层的优化。批处理策略、KV Cache 管理和算子融合同样重要,协同设计的思路可以延伸到整个推理栈,而不仅是注意力这一个模块。
小结
稀疏注意力的效率红利,取决于算法稀疏模式与硬件执行特性的匹配程度。NVIDIA 提出的协同设计思路,把注意力机制从纯算法问题拉回到系统问题:只有让稀疏结构对硬件友好,长上下文推理的吞吐提升才能真正落地。对正在部署长上下文应用的团队而言,这意味着评估重心应从理论复杂度转向端到端的实际延迟与显存占用。
相关推荐
计算机科学家为何认为超级智能不会成真
计算机科学家Cal Newport从工程角度反驳超级智能叙事:递归自我改进受限于数据瓶颈与算力约束,超级智能未必可计算,LLM智能体的失控源于架构而非对齐难题。他警告,追逐ASI本身就是一种过失。
Holiday Extras员工把AI助手当“狗”养:Brian与Beast的真实工作日常
Holiday Extras员工将AI助手命名为Beast,每天早晚对话、提前准备会议数据、监控任务进展。本文还原一个真实用户如何把AI嵌入日常工作流,并给出低门槛启动建议。
十亿美元级合作:美国电池市场迎来转机?
Sila与Panasonic Energy签署十亿美元级硅碳负极供应协议,本文分析该交易对美国下一代电池市场、供应链本土化及商业化前景的影响。