稀疏自编码器特征评分到底识别了什么?从激活到干预的鸿沟

新研究证明SAE特征的观察性发现分数无法识别其干预效应,干预归因需用梯度单独估计。
稀疏自编码器(SAE)被广泛用于从大模型激活中发现可读特征,但新论文指出,特征发现阶段的观察性证据(线性探针、相关系数、激活频率)无法识别干预归因——即改变某隐变量对模型输出的一阶效应。作者给出梯度分解,证明干预归因可梯度估计,并在四对模型-SAE 上测得探针与干预归因的量级比中位数达数十到数百倍;单隐变量消融中梯度预测符号与真实一致率 91%–97%,探针仅 17%–35%。按归因选择的特征在留出提示上的平均消融效应也大于相关性、秩检验和探针系数选择。论文建议将干预归因确立为特征选择的原则性目标,并提醒安全对齐与模型编辑实践者区分可发现性与可干预性。
稀疏自编码器(Sparse Autoencoder, SAE)是当前可解释性研究中最热门的工具之一。研究者用它从大模型的激活中"挖"出可读的特征,再通过引导(steering)或消融(ablation)来验证这些特征是否真的对应某种概念。但新研究指出:这些特征被"发现"的方式,和它们被"使用"的方式之间,存在一道系统性的鸿沟。
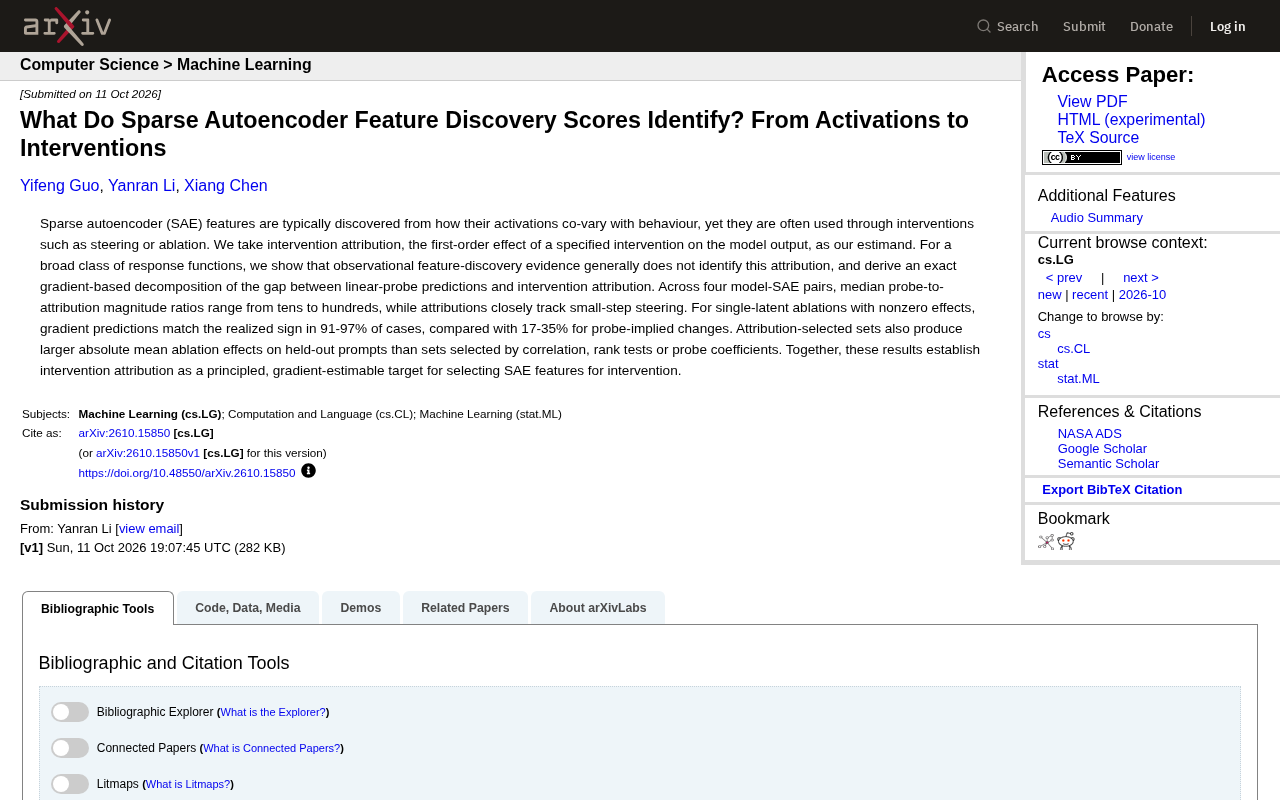
发现与干预:两套不兼容的逻辑
SAE 特征的发现过程,本质上是观察性的——看某个隐变量的激活值如何与行为协同变化。比如,当一个特征在"金门大桥"相关文本上频繁激活,研究者就倾向于认为它编码了"金门大桥"这个概念。
但干预是完全不同的一件事。当你用这个特征去引导模型输出,或者把它消融掉,你关心的问题是:改变这个隐变量,模型的输出会改变多少?
论文把后者形式化为"干预归因"(intervention attribution)——即一次特定干预对模型输出的一阶效应。问题在于,观察性的发现证据,能否识别这个干预归因?
作者给出的答案是否定的。
对于一大类响应函数,观察性的特征发现证据一般无法识别干预归因。
这不是某个具体方法的缺陷,而是一个结构性结论。线性探针分数、相关系数、激活频率——这些在特征发现阶段常用的指标,和"这个特征被干预后能撬动多少输出"之间,没有必然的对应关系。
稀疏自编码器(SAE) 是一种无监督学习结构,通过将一个高维的模型激活向量压缩到一个过完备的稀疏隐空间,再重建原始激活,迫使每个隐变量只对少数输入模式敏感。在大模型可解释性研究中,SAE 被用来把多义、稠密的神经元激活分解为大量单义、可读的隐特征,典型工作包括 Anthropic 的「字典学习」和 OpenAI 的「稀疏电路」尝试。
引导(steering) 指在推理时人为放大或抑制某个特征的激活值,观察模型输出是否朝预期方向改变,例如增大「金门大桥」特征让模型更频繁提及该地标。消融(ablation) 则是将该特征激活置零或替换为基线值,观察模型能力或行为受到多大损害。两者都属于干预手段,目的是从相关性走向因果性验证。
线性探针 是一种轻量级可解释性工具:在模型激活之上训练一个线性分类器来预测某个属性(如情感、语法性),其权重常被当作该属性在激活空间中的方向。尽管探针能高精度解码属性,但它的分数只反映观察性关联,未必等价于因果效用,这是本文质疑的核心。
梯度分解:量化探针与干预之间的差距
论文没有止步于"二者不同"的定性判断,而是给出了一个精确的梯度分解,把线性探针预测与真实干预归因之间的差距拆解开来。
这个分解的意义在于,它表明干预归因本身是可梯度估计的。换句话说,你不需要真的做干预实验,就能用梯度信息去近似"干预这个特征会带来多大影响"。
这为特征选择提供了一个新的目标函数:与其用激活相关性来挑特征,不如用干预归因来挑。
干预归因(intervention attribution) 来自因果推断中的归因思想,衡量的是对某个内部变量施加一次特定干预后,模型输出的一阶变化量。若把模型输出记为 (f),被干预的隐变量记为 (z_i),则干预归因可近似为 (\partial f / \partial z_i) 在干预点处的取值——这正是论文称其「可梯度估计」的原因:无需真的运行干预实验,只需反向传播即可得到局部效应估计。
这一形式化与观察性归因形成对比。观察性归因通常用特征激活值与输出之间的相关系数、线性探针系数或秩统计量来度量,它们不要求对内部变量做任何改动,因而只能捕捉自然共变关系。论文的梯度分解则把「探针预测」与「真实干预效应」之间的差拆成若干可分析项,说明为何前者无法一般性地识别后者。
值得注意的是,这种梯度估计仅在干预幅度足够小、模型局部近似线性的条件下有效。对于大范围引导或非线性极强的响应函数,一阶近似可能失真,因此论文用小步长引导实验来验证归因估计与实际效果的一致性。
四对模型-SAE 的实证:差距有多大?
论文在四组模型-SAE 配对上做了系统测量,数字相当惊人。
探针归因与干预归因的量级比(median probe-to-attribution ratio)从数十到数百不等。 这意味着,如果一个特征在线性探针上得分很高,它在实际干预下的效应可能只有探针暗示的几十分之一甚至几百分之一。
更细致的验证来自小步长引导实验:归因估计与实际引导效果高度吻合。这说明梯度估计的归因不是纸上谈兵,它确实追踪了真实的干预行为。
在单隐变量消融实验中,对于效应非零的情况:
- 梯度预测的符号与真实符号一致的比例达到 91%–97%
- 而探针暗示的变化方向,只有 17%–35% 是对的
这是一个非常悬殊的对比。探针分数在预测干预方向这件事上,几乎接近随机猜测的表现。
梯度预测符号与真实符号一致率 是衡量归因估计方向正确性的指标:对每个特征,分别计算基于梯度的归因估计值和实际干预后输出变化的方向,统计两者同号的频率。方向正确比幅度准确更基本——如果连正负号都反了,干预就会产生相反效果,在安全对齐中可能造成危险。论文报告 91%–97% 的一致率,说明梯度归因在方向判断上高度可靠。
探针归因 则用线性探针系数作为特征重要性的代理。在同样实验中,探针暗示的变化方向只有 17%–35% 与真实干预方向一致,接近随机水平。这直接说明,一个特征在线性探针上权重高,并不意味着放大或消融它会朝探针所编码的概念方向改变输出。
探针归因与干预归因的量级比中位数 是另一个关键指标:将探针归因值除以真实干预归因值,取所有特征的中位数。数十到数百的比值意味着探针系统性地高估了特征的干预效力,按探针排序会选出大量「看起来重要但干预无效」的特征。
选择策略的对比:归因选出的特征更"有用"
论文还比较了不同特征选择策略的实际效果。
用干预归因挑出的特征集合,在留出提示(held-out prompts)上产生的绝对平均消融效应,大于以下策略选出的集合:
- 相关性选择
- 秩检验选择
- 探针系数选择
这个结果从实用角度确认了:如果你打算用 SAE 特征做干预,那么按归因来选比按相关性来选更靠谱。
这对 SAE 可解释性研究意味着什么
这项工作触及了 SAE 研究中一个被长期忽视的假设:特征的可发现性与特征的可干预性是同一回事。 论文表明它们不是。
这不意味着 SAE 没用。它意味着,当研究者报告"我们找到了一个编码 X 概念的特征"时,这个声明需要被更精确地限定——它说的是观察层面的相关性,而非干预层面的因果效力。
论文给出的建设性方向是:将干预归因确立为选择 SAE 特征用于干预的原则性目标,且这个目标可以通过梯度估计。 这为后续研究提供了一个更清晰的评估框架:不要只问"这个特征激活得好不好",而要问"干预这个特征,模型会怎样"。
对于把 SAE 特征用于安全对齐、行为控制或模型编辑的实践者来说,这个区分尤其重要。你用来筛选特征的指标,决定了你后续干预的有效性上限。
安全对齐与模型编辑 是 SAE 特征干预最直接的应用场景。在安全对齐中,研究者可能希望消融「欺骗」「谄媚」等有害特征,或引导「诚实」「拒绝」等有益特征;在模型编辑中,则通过定位并修改特定特征来更新知识或行为。这些任务对干预方向尤其敏感:若按探针分数选择特征,由于方向一致率仅 17%–35%,很可能选到干预后效果相反或无效的特征,导致安全措施失效甚至产生反效果。
因此论文建议将干预归因作为特征选择的目标函数,并利用梯度进行高效估计。这一框架也提示评估 SAE 质量时应区分两个维度:发现层面的可读性与重建保真度,以及干预层面的因果效力。两者并不自动一致,需要分别测量。
对实践者而言,这意味着在部署 SAE 特征做控制前,应先做小步长干预验证,确认梯度归因估计与真实效果吻合,再据此排序和筛选特征,而不是直接采用相关性或探针分数。
相关推荐

AI Agent的本质:模型、工具与循环三要素
AI Agent通常由三个核心部分组成:决策模型、可调用的工具、以及执行循环。本文拆解Agent的基本构成,并探讨设计Agent时如何定义权限边界与停止条件,避免失控。

Claude Pro与Max对比:每月200美元的Max值不值?
Claude Pro与Max套餐深度对比:Max每月200美元不增加任何Pro无法触及的模型,只卖容量。5X/20X是Pro会话额度的倍数,从100到200美元容量变4倍。本文拆解两个限制罐子、Fable 5.1计费、API积分条件,并给出80美元升级分界线与按场景选购建议。

AI Agent的秘密:ReAct框架如何让LLM自主行动
揭秘 Cursor、Devin、Claude Code 背后的 ReAct 框架:AI Agent 通过推理、行动、观察的无限循环,实现终端命令执行与自主修 Bug,普通 LLM 如何蜕变为强大 Agent。