下一token预测+强化学习能通向通用智能吗?

NTP+RL能否通向AGI?最强机制论证及其三个未解缺口。
Reddit讨论要求用机制论证而非趋势外推回答:下一token预测(NTP)加强化学习(RL)能否产生开放式通用智能?NTP的最强论证是「压缩即理解」——最优预测器等价于最优压缩器,迫使模型内化数据规律。RL提供目标导向搜索能力,但标准RL框架不解释新目标如何自主生成。计算学习理论视角下,规模可能使假设空间覆盖广泛任务,但基准表现不等于通用性。文章指出三个明确缺口:目标生成缺失、具身与交互缺失、持续学习缺失。最诚实的结论是:NTP+RL原则上可逼近AGI,但三个机制缺口尚未被当前范式覆盖。
「我们正处在通往AGI的路上,唯一的问题是后AGI世界长什么样。」——Reddit上大量AI讨论都默认了这个前提。[D] 一位用户在r/ArtificialIntelligence发帖,把讨论拉回更靠前的一步:下一token预测(NTP)加上强化学习(RL),究竟有没有机制层面的理由产生开放式通用智能?
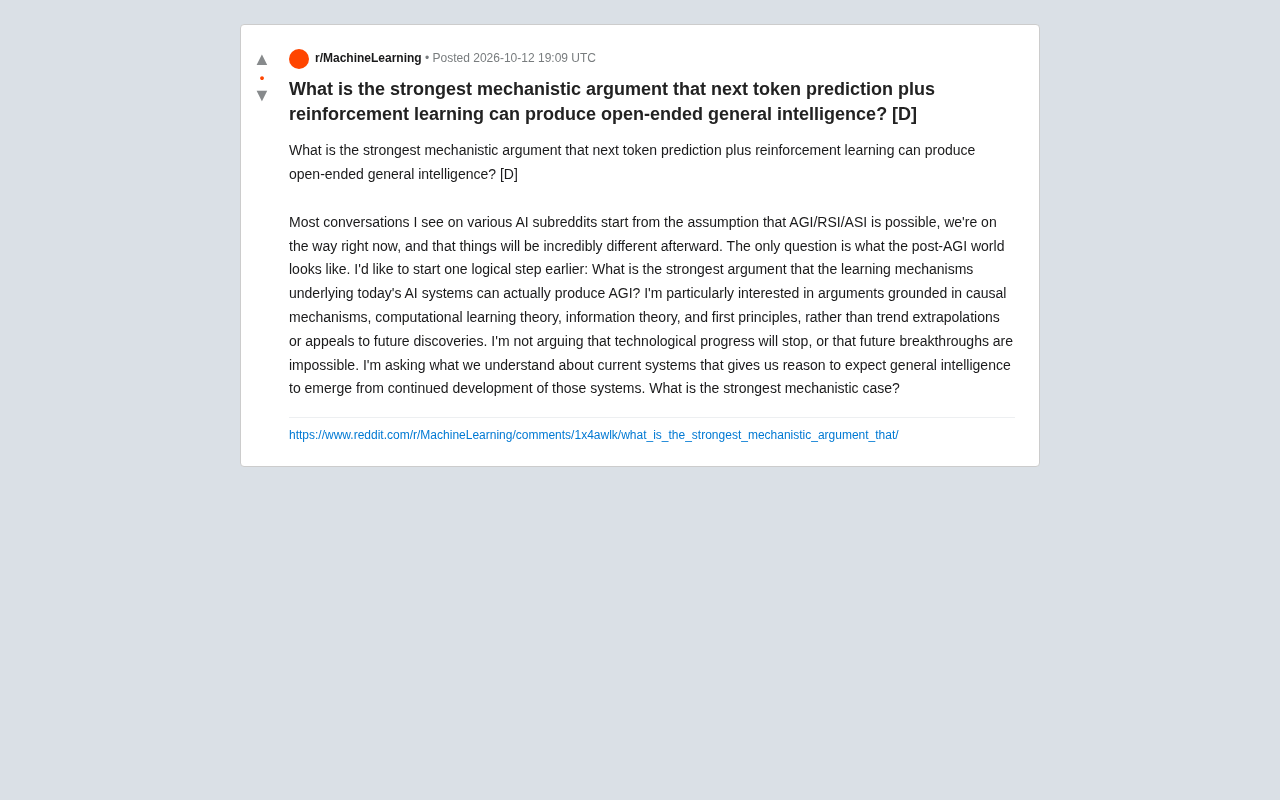
发帖人明确排除了两类论证:趋势外推和「未来会有新突破」的信念。他要的是基于因果机制、计算学习理论、信息论和第一性原理的硬核论证。以下是对这个问题的拆解,以及目前能给出的最强回答——和它的边界。
为什么这个问题值得较真
大多数AGI讨论跳过了机制论证,直接进入后果推演:对齐问题、经济冲击、权力集中。这种讨论模式暗含一个未经验证的假设——当前的训练范式在原理上足以通向通用智能。
如果不成立,那么所有后AGI推演都建立在沙地上。发帖人的问题实际上是:我们理解当前系统的哪些性质,让我们有理由期待通用智能从中涌现?这不是唱衰技术进步,而是要求把「信仰」替换为「机制」。
NTP的机制论证:压缩即理解
支持NTP能产生通用能力的最强论证来自压缩与预测的等价性。Solomonoff归纳推理和最小描述长度理论指出,最优预测器就是最优压缩器——要准确预测下一个token,模型必须内化生成数据背后的规律结构。
Ilya Sutskever多次表述过这个直觉:预测下一个token就是在压缩世界,而压缩需要理解。如果训练数据覆盖了足够广泛的自然与人类知识,最小化预测损失的过程会迫使模型学到跨领域的抽象表征。
这个论证的强度取决于一个关键前提:训练分布的广度。自然语言文本确实编码了大量人类认知成果,但文本只是世界的一个投影,不是世界本身。NTP能压缩文本中的规律,不等于能压缩物理世界、社会动态和具身交互的全部规律。
另一个机制性论据是上下文学习(in-context learning)的涌现。足够大的Transformer在预训练中获得了从少量示例中推断新任务的能力,这被一些研究者视为元学习的证据——模型学到的不是具体任务,而是「如何学习任务」的算法。
Solomonoff归纳推理由数学家Ray Solomonoff于1960年代提出,是算法信息论中关于归纳推理的形式化框架。其核心思想是:给定观测序列,最优预测应对所有能生成该序列的计算机程序按「程序长度」加权——越短的程序(即越简单的假设)权重越高。这一框架在数学上证明了最优预测器等价于寻找生成数据的最短程序,即最优压缩器。**最小描述长度(MDL)**原理由Rissanen进一步发展,将这一思想转化为可操作的模型选择准则:在拟合数据与模型复杂度之间取最优权衡。两者共同构成了「压缩即理解」的数学基础,也是理解NTP为何能学到世界规律的核心理论工具。
RL的角色:从模仿到目标导向
如果NTP提供的是世界的压缩表征,RL提供的则是在表征空间中进行目标导向搜索的能力。RLHF和后续的推理训练(如思维链强化)让模型不只是模仿训练数据,而是在奖励信号下探索策略空间。
这条路径的机制论证是:RL本质上是通用搜索过程。只要状态空间和动作空间足够表达目标任务,RL原则上可以找到解决方案。DeepMind的AlphaZero证明了在规则明确、奖励可定义的领域,RL能从零学出超越人类的策略。
但这里有一个被发帖人点破的关键缺口:开放式(open-ended)。AlphaZero的游戏空间是封闭的,奖励函数是固定的。真正通用智能的标志是能自主生成新目标、定义新问题,而不是在给定奖励下优化。RL的机制本身不提供目标生成的来源。
开放式(open-ended) 是进化生物学和人工智能中的一个核心概念,指系统能持续产生新颖且日益复杂的行为或目标,而非收敛到固定解。在AI语境中,开放式学习要求智能体不仅能解决给定问题,还能自主生成新问题、新目标和新技能。 Kenneth Stanley 等人的 NEAT 和 novelty search 工作表明,奖励函数固定的 RL 容易陷入局部最优或目标饱和,而真正的开放式系统需要内在动机机制(如好奇心、 empowerment)来驱动探索。这一概念与文章讨论的「目标生成缺失」直接相关:标准 RL 的奖励由外部给定,而开放式智能要求目标从系统内部涌现,这正是当前范式尚未解决的机制缺口。
计算学习理论的回应
从计算学习理论看,NTP+RL的组合可以理解为在两个层面上的学习:预训练阶段学习数据的生成分布,微调阶段学习任务的奖励分布。PAC学习框架下,泛化能力取决于假设空间的容量和训练样本的覆盖。
支持者会说:规模本身就是机制。当参数量和训练数据量跨过某个阈值,假设空间足以包含解决广泛任务所需的函数。GPT系列在多项基准上的表现被引为证据——同一套权重无需微调就能处理翻译、编程、数学、法律推理等异质任务。
反对者会指出:基准表现不等于通用性。这些任务仍然是分布内的,或者与训练分布有可计算的相似性。真正的开放式通用智能要求在完全新奇的领域快速适应,而当前证据并不充分。
PAC(Probably Approximately Correct)学习框架由 Leslie Valiant 于1984年提出,是计算学习理论的基础模型。它形式化地定义了「可学习」:一个概念类若存在算法,能在多项式时间内以高概率输出近似正确的假设,则称该概念类 PAC 可学习。PAC 框架下,泛化误差取决于假设空间的复杂度(如 VC 维)和训练样本量。文章引用的「规模本身就是机制」论证,本质上是在说:当参数量足够大时,假设空间足以覆盖广泛任务,且海量数据满足 PAC 的样本覆盖要求。但 PAC 框架假设训练与测试数据来自同一分布,这恰恰是「基准表现不等于通用性」的技术根源——分布外泛化在 PAC 框架下没有保证。
缺口与未解问题
综合Reddit讨论和现有文献,NTP+RL通向AGI的机制论证存在三个明确缺口:
目标生成的缺失。 RL优化给定奖励,但不解释新目标从何而来。人类智能的开放性部分来自内在动机、好奇心和自主目标设定,这些在标准RL框架中没有对应机制。
具身与交互的缺失。 纯文本训练无法获得物理直觉、社会反馈和实时交互中的因果知识。世界模型如果只从文本学,可能只是文本的世界模型。
持续学习的缺失。 当前范式是训练-部署两阶段,部署后权重冻结。通用智能需要在交互中持续更新,而不只是上下文中的临时适应。
发帖人问的是「最强论证」,诚实的最强版本大概是:NTP提供了通用表征的压缩基础,RL提供了在表征上做目标导向搜索的能力,两者组合原则上可以逼近通用智能,但目标生成、具身交互和持续学习三个机制缺口尚未被当前范式覆盖。 这不是否定进步,而是标出从「能」到「必然能」之间缺失的推理环节。
常见问题
NTP和自回归生成是一回事吗? 基本是。NTP是训练目标,自回归生成是推理方式,都基于「根据前文预测下一个token」的同一机制。
为什么RL对AGI重要? 纯NTP学到的是数据的分布,RL让模型能在奖励信号下主动探索策略空间,从模仿走向目标导向行为。
这个问题的争论焦点是什么? 核心分歧在于:通用智能要求的能力是NTP+RL训练分布的延伸,还是需要全新的学习机制。前者认为是规模问题,后者认为是范式问题。
相关推荐

黑人觅食者Alexis Nelson:从觅食到出书,快乐零食别死
黑人觅食者Alexis Nikole Nelson做客Talks at Google,分享从童年跟随母亲认识植物到出版食谱书《Happy Snacking, Don't Die!》的旅程,揭示美国觅食兴衰背后的种族与土地历史。

如何有效呈现你的想法:三种揭示式演讲方法
揭示式演讲是传递想法最直接的方式。本文解析奇妙漫步、动态演示和梦想图景三种演讲类型,结合David Gayo、Michael Pritchard、Sylvia Earle等经典案例,教你如何有效呈现想法。

Modern Web Guidance:让AI写原生声明式对话弹窗
Google Modern Web Guidance 让 AI 编程助手在生成代码时优先使用浏览器原生声明式 dialog 能力,替代重复的 JavaScript 事件监听,实测可显著减少样板代码。