先关系后实体:语言模型事实回忆的延迟提交机制
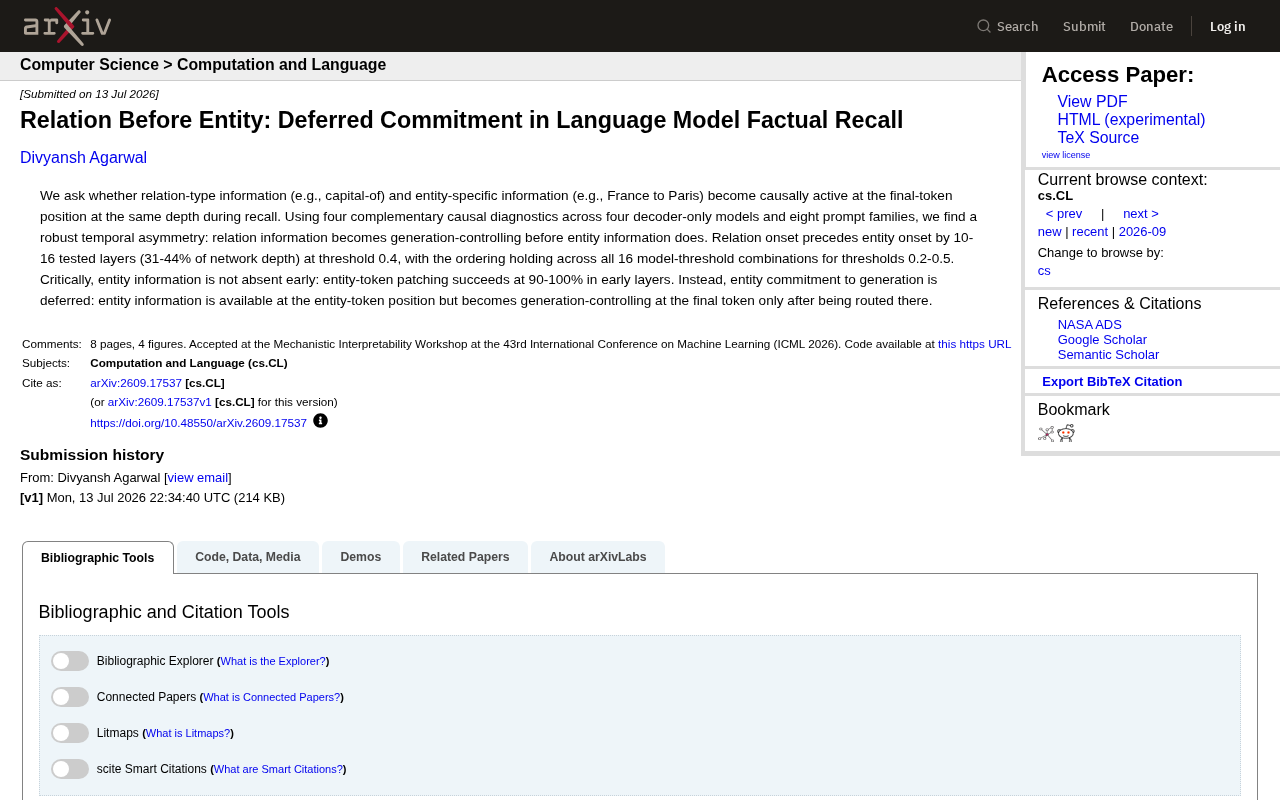
语言模型事实回忆时,关系类型信息比具体实体信息早10-16层成为生成控制因素,揭示出"先框架后内容"的分层时序机制。
这篇arXiv论文研究了语言模型在事实回忆时的内部时序结构,发现关系信息(如"首都关系")比实体信息(如"法国→巴黎")更早成为控制生成的因果因素,两者起始层相差10到16层,占网络总深度的31%至44%。这一不对称性在四个decoder-only模型、四种因果诊断方法和16组参数组合中均稳健成立。值得注意的是,实体信息在早期层就已可用(修补成功率高达90-100%),并非缺席,而是存在"延迟提交"现象:实体信息须经注意力机制路由到最终token位置后,才真正驱动输出。这一发现将"信息存储"与"信息调用"在网络深度上解耦,为机制可解释性和知识编辑研究提供了更细粒度的时序框架。
一个被忽视的问题:语言模型如何组织事实回忆
当我们向语言模型提问“法国的首都是哪里”,它会准确输出“巴黎”。这个看似简单的事实回忆过程,背后隐藏着一个尚未被充分理解的机制问题:模型在内部究竟是先确定“关系类型”(capital-of,即首都关系),还是先确定“实体信息”(France→Paris,即法国对应巴黎)?
这篇发表于 arXiv 的新研究(arXiv:2609.17537v1)正是围绕这个核心疑问展开。研究者提出了一个精确的问题表述:关系类型信息与实体特定信息,是否在最终 token 位置的同一网络深度上同时变得“因果活跃”(causally active)?答案是否定的——两者存在稳健的时间不对称性。
关系信息先行,实体信息滞后
研究的核心发现是一个明确的顺序:关系信息成为生成控制因素的时间,早于实体信息。也就是说,模型在决定“我要输出一个首都名”这件事上,比“具体是哪个首都”要更早形成决策。
从量化数据看,在阈值 0.4 的条件下,关系信息的起始(relation onset)比实体信息的起始(entity onset)提前了 10 到 16 个测试层,这相当于网络总深度的 31% 到 44%。这个差距不是个别现象——研究在 16 组模型-阈值组合中(阈值范围 0.2 至 0.5)都观察到了相同的排序,说明这是一个跨模型、跨设置的普遍规律。
为了验证这一结论的可靠性,研究者使用了四种互补的因果诊断方法,覆盖了四个仅解码器(decoder-only)架构的模型,以及八个不同的提示族(prompt families)。方法与场景的多样性,使得“关系先于实体”这一发现具备较强的说服力。
这里提到的"因果活跃"(causally active)以及四种因果诊断方法,核心工具是激活修补(activation patching),这是机制可解释性研究中的标准干预手段。其基本思路是:用"干净运行"(clean run)中某一层、某个位置的激活值,替换"被污染运行"(corrupted run)中的对应激活值,观察输出是否恢复正确。如果替换某层的关系相关激活就能让输出从错误变为正确,则说明该层是关系信息的因果关键位置。通过系统地扫描每一层和每个 token 位置,研究者可以绘制出信息"何时、何处"真正控制模型输出的热力图。阈值(0.2–0.5)则是判断某层修补效果是否"显著"的标准线,用于将连续的修补得分离散化为"已激活/未激活"的二值判断,从而定义"onset"(起始层)的位置。
实体信息并非缺席,而是被“延迟提交”
这项研究一个特别值得玩味的细节在于:关系信息领先,并不意味着早期层里没有实体信息。恰恰相反,实体信息在早期就已经存在。
研究通过实体 token 的激活修补(entity-token patching)实验发现,在网络的早期层,这种修补的成功率高达 90% 到 100%。换句话说,模型在早期就已经“知道”法国对应巴黎这个具体事实——实体信息在实体 token 的位置上是可用的。
关键区别在于提交(commitment)的时机。研究者用“延迟提交”(deferred commitment)来描述这一现象:实体信息虽然早已就位于实体 token 位置,但它只有在被“路由”(routed)到最终 token 位置之后,才真正成为控制生成的因素。这个路由过程发生得更晚,从而造成了实体信息在生成层面的滞后。
这一区分非常重要:它把“信息是否存在”与“信息是否驱动生成”分离开来。实体信息的可用性和它的生成控制力,是两个不同深度上发生的事件。
对模型可解释性研究的意义
这项工作对理解大型语言模型的内部计算过程提供了新的视角。传统上,我们容易把事实回忆看作一个整体动作,但这里揭示的是一种分层、有先后次序的信息整合流程:模型先锁定“回答的类型框架”,再将具体的实体内容路由到输出位置。
从机制可解释性(mechanistic interpretability)的角度,这种“关系先行、实体延迟”的结构,为定位模型内部的知识存储与调用路径提供了更细粒度的坐标。例如,如果实体信息在早期层就已可用,那么对事实错误的编辑或纠正,可能需要同时考虑信息的存储位置和它被路由提交的时机,而非仅仅修改某一层的表示。
需要说明的是,本文基于 arXiv 摘要撰写,完整的实验细节、四种诊断方法的具体实现以及在不同模型上的对比数据,仍需参考原论文。但仅从摘要呈现的核心结论看,“先关系后实体”的延迟提交机制,为语言模型事实回忆的时序结构提供了一个清晰而可验证的描述框架。
**知识编辑(knowledge editing)**是当前 LLM 研究的热点方向,目标是在不重新训练整个模型的前提下,精准修改模型储存的特定事实(如将"埃菲尔铁塔所在城市"从巴黎改为其他城市)。现有方法如 ROME、MEMIT 通常假设事实知识集中存储在某几层的 MLP 权重中,并针对性地修改这些权重。然而本文的发现提示,一条事实的"存储"(实体信息在实体 token 处的早期可用性)与其"调用提交"(被路由到最终 token 位置的时机)可能涉及不同的网络层和机制。这意味着仅修改存储层可能不足以彻底改变模型的输出行为,还需要同时干预信息路由的中间层,否则旧有的路由路径可能绕过编辑结果,导致知识编辑失效或产生意外副作用。
背景补充
**路由(routing)**在 Transformer 架构语境下,指的是信息从一个序列位置"流动"到另一个位置的过程,其物理载体是注意力机制(attention)。在自回归解码器中,只有最终 token(即待生成 token 的前一个位置)的残差流状态直接决定下一个词的概率分布。因此,即便实体 token(如"France")位置上的表示已经编码了"法国→巴黎"的对应关系,这个信息也必须通过后续层的注意力头被"写入"最终 token 的残差流,才能真正影响输出。"延迟提交"描述的正是这段从实体 token 到最终 token 位置的信息传递存在明显的层深延迟——实体信息的存在与它实际参与生成决策,在网络深度上被拆分成了两个独立事件。
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。