想做大模型开发岗?这6大核心技术才是求职关键
B站讲师从招聘市场出发,梳理大模型开发求职必须掌握的六大核心技术,并明确区分消费者工具与企业级开发能力的本质差异。
文章整理了一位B站AI讲师的观点:大模型相关岗位持续高速增长,本科学历即可满足大多数要求。他最核心的判断是,市面上大量大模型课程属于面向消费者的"工具课"(Ollama、Dify等),这类内容不支持分布式、无法满足企业高并发需求,不应成为求职冲刺期的学习重心。真正决定能否入职的是六大技术模块:RAG开发、Agent智能体开发、Workflow工作流开发(含动态路由)、大模型微调、蒸馏与量化,以及MoE架构与从零训练。讲师建议求职者直接对照招聘JD提取高频技术关键词,以完整项目验证能力。文章最后也指出,"企业绝不使用量化版"的判断略显绝对,实际成本敏感场景下量化模型仍有应用空间。
如果你想进入大模型开发这个赛道,第一个问题往往是:到底该学什么,才能拿到岗位?B站这位AI讲师从招聘市场的真实需求出发,给出了一份务实的技术清单。他的核心观点很直接——别把时间浪费在工具课上,真正决定你能否入职的是六大核心技术。
大模型岗位仍在高速扩张
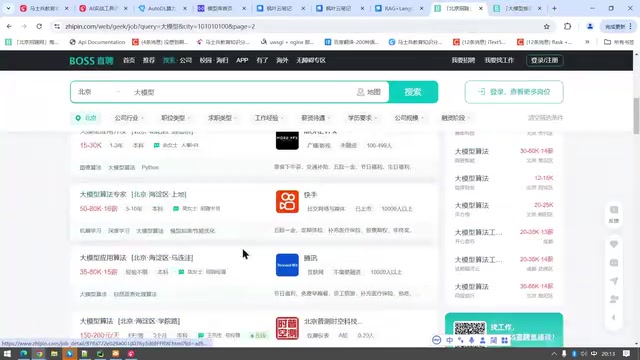
这位讲师建议求职者直接去BOSS直聘、猎聘等平台搜索关键词「大模型」,而不是「大模型算法」或「大模型开发」这类窄化的词。原因在于,所有开发岗和算法岗只要涉及大模型,都会被归入「大模型相关」这个大类下,用宽泛的关键词才能覆盖全部机会。
据他从年初开始持续跟踪,这类岗位「几乎每个星期都要增加」。更有意思的是学历门槛并不高——本科即可满足大部分岗位要求,且本科占比超过50%。他以小米的一个岗位为例,其中明确要求掌握 VLM(视觉语言模型)等技术,说明企业招聘的技术点是具体且可对照学习的。
消费者视角 vs 开发者视角
讲师首先辟了一个「谣」:互联网上海量的大模型公开课,本质上分为两大类——面向消费者和面向开发者,两者难度和目标完全不同。
面向消费者的内容通常不需要编程,通过点击按钮或拖拽就能完成大模型的调用,代表工具如 Ollama、Dify 等。这类工具对普通用户很友好,但他强调这并非开发岗的核心。
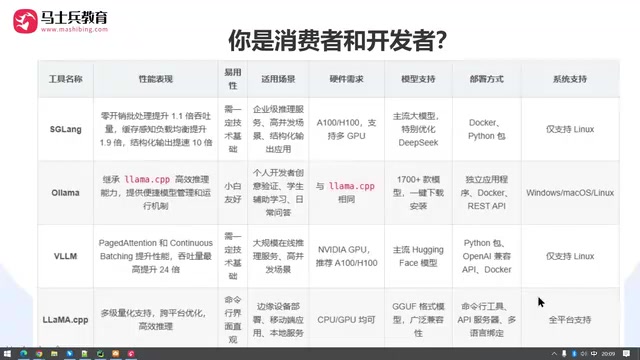
面向开发者的内容则完全不同,需要写代码、靠编程实现,强调的是灵活性、高并发、分布式、性能和可定制化。这几个关键词,恰恰是企业级应用与个人玩票之间的分水岭。
为什么企业不用量化版和 Ollama
讲师抛出一个鲜明观点:企业「绝对不可能」使用量化版本的大模型。他举例说,用 Ollama 部署一个量化版的 DeepSeek广告,对个人消费者没问题,但对企业而言意义不大——「我用 70B 的 DeepSeek 比你这个量化的还更好」。
此外 Ollama 最大的短板是不支持分布式,这在企业高并发、大规模部署场景下是硬伤。因此他建议:工具课「有空才学」,不要在求职冲刺期占用宝贵时间。
六大核心技术清单
讲师给出了想从事大模型开发岗必须掌握的六个技术模块,这也是文章最有价值的部分:
1. RAG 开发
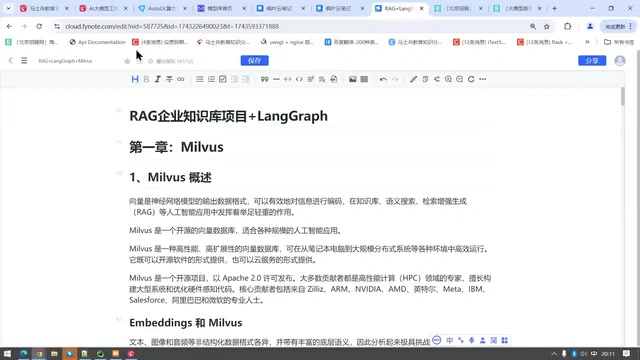
检索增强生成是企业级大模型应用的主流方案。RAG 开发中涉及的所有技术——从文档切分、向量检索到企业知识库构建,都需要掌握。他还准备了 RAG 企业知识库项目的 Markdown 文档作为配套资料。
RAG(Retrieval-Augmented Generation,检索增强生成)的核心思路是:不直接依赖大模型参数中存储的知识,而是在推理时先从外部知识库检索相关文档,再将检索结果拼入提示词,让模型基于真实资料生成回答。这样既能解决大模型知识截止日期的问题,也能大幅降低幻觉风险。
工程实现上,RAG 流水线通常包含以下环节:文档预处理与分块(Chunking)、用 Embedding 模型将文本转成向量、写入向量数据库(如 Milvus、Qdrant、Chroma)、用户提问时进行相似度检索、将 Top-K 召回片段注入 Prompt、最终由 LLM 生成答案。每个环节都有大量工程细节需要处理,例如如何切块才能保留语义完整性、如何做混合检索(向量检索 + BM25 关键词检索)、以及如何对召回结果做重排(Rerank)以提升精度。这也是为什么 RAG 开发能单独撑起一个求职方向的原因。
2. Agent 智能体开发
他特别指出,在真实招聘 JD 中频繁出现的正是「Agent」这个词。智能体开发所需的技术栈是求职的高频考点。
Agent(智能体)是指能够自主规划、调用工具并根据反馈迭代执行的大模型应用范式,区别于单轮问答或固定流水线。典型的 Agent 循环是 ReAct 模式:模型先 Reason(推理下一步该做什么),再 Act(调用工具或 API),观察返回结果后继续推理,直至完成目标。
开发层面,主流框架包括 LangChain 的 AgentExecutor、LangGraph(支持有状态的多步骤图结构)以及 AutoGen、CrewAI 等多 Agent 协作框架。企业场景中 Agent 常见的工具集有:搜索引擎调用、数据库查询、代码执行沙箱、REST API 调用等。掌握如何定义工具(Tool)、如何设计系统提示词约束模型行为、以及如何处理工具调用失败时的重试与降级逻辑,是 Agent 开发的核心工程能力。
3. Workflow 工作流开发
工作流中有一个重要难点叫动态路由。他特意提醒:这里的动态路由和传统微服务开发里的动态路由「完全是两码事」,作为科班程序员出身的他也强调不要混淆概念。
4. 大模型微调(Fine-tuning)
针对特定业务场景对模型进行微调,是让通用模型适配企业需求的关键能力。
5. 蒸馏与量化
模型蒸馏和量化技术,用于在保持效果的前提下压缩模型、降低部署成本。
模型蒸馏(Knowledge Distillation)是指用一个大型「教师模型」的输出(软标签或中间层特征)来训练一个小型「学生模型」,使学生模型在参数量大幅缩减的情况下尽量保留教师模型的能力。典型案例是 DeepSeek 发布的 R1 蒸馏系列,用 R1 的推理数据微调 Qwen、Llama 等小模型,得到效果远超同参数量基线的版本。
量化(Quantization)则是将模型权重从 FP32/BF16 精度压缩为 INT8、INT4 甚至更低比特,从而减少显存占用和推理延迟。常见方案包括 GPTQ(训练后量化)、AWQ(激活感知量化)和 GGUF(llama.cpp 使用的格式)。讲师指出企业不使用量化版有其合理性:在对精度敏感、有充足算力预算的场景下确实如此;但在边缘设备部署或成本极度受限的场景下,INT4/INT8 量化仍是主流选择,两者并不矛盾。
6. MOE 与从零训练
从零开始训练一个大模型,涉及 MOE(混合专家)等架构。这是六个模块中门槛最高的部分。
MoE(Mixture of Experts,混合专家架构)是一种稀疏激活的模型结构:模型由多个「专家」子网络组成,每次推理时由一个轻量的门控网络(Router)动态选择少数几个专家参与计算,而非激活全部参数。这样在保持较大模型容量(参数总量大)的同时,实际计算量(激活参数量)可以显著低于同等性能的稠密模型。GPT-4、Mixtral 8x7B、DeepSeek-V2/V3 均采用了 MoE 架构。
从零训练大模型涉及的工程挑战包括:数据清洗与配比(Tokenization、去重、质量过滤)、分布式训练框架(Megatron-LM、DeepSpeed,涵盖张量并行、流水线并行、数据并行)、混合精度训练(BF16 + 梯度缩放)以及训练稳定性监控(Loss spike 处理、梯度裁剪)。这部分技能门槛最高,通常出现在大厂或大模型创业公司的研究员岗位,对于初级开发者而言了解架构原理比能独立实现更为现实。
给求职者的实战建议
把讲师的观点整理成一条清晰路径:先明确岗位类型,再对照 JD 学核心技术,最后用完整项目验证能力。他提到的携程 AI 助手完整实战项目、RAG 企业知识库、LangGraph 文档等,本质上都是围绕这六大模块的落地演练。
对于正在准备大模型开发岗的求职者,最实用的动作是:打开招聘平台随便点开几个 JD,把出现的技术关键词记录下来,你会发现它们高度集中在 RAG、Agent、微调、量化这几个方向。工具类内容(Ollama、Dify)可以了解,但不该成为学习重心。
需要提醒的是,本文观点来自单一 UP 主的经验分享,其对「企业绝不使用量化版」的判断略显绝对——实际业务中,成本敏感场景下量化模型仍有应用空间。读者应结合自身目标岗位的具体要求做取舍。
相关推荐

AI编程为何离不开Git?从版本回退到AI辅助命令全解析
Git是AI编程的必备工具。本文解析Git分布式版本控制在AI编程中的价值,包括应对AI幻觉的版本回退、分支管理等核心操作,以及如何用豆包、AI输入法等工具快速生成Git命令,帮助新手零基础入门。

拒绝AI胡编:一款"说不了谎"的求职信生成器是如何炼成的
一位开发者因AI求职信工具凭空捏造其Kubernetes经验和管理经历而屡遭拒信,于是打造了CoverCraft——通过代码计算评分、GitHub提交记录背书、对抗性审查与人工审批四重机制,构建一款"无法说谎"的AI求职信生成器。本文解析其对抗AI幻觉的工程设计。
Perplexity携手美国运通:为小企业主打造即用型AI技能库
Perplexity携手美国运通:为小企业主打造即用型AI技能库
Perplexity 联合美国运通推出面向小企业卡会员的即用型 AI 技能库,内置现金流预测、营销活动生成等预构建工作流,用户无需编写提示词即可让 AI 处理日常业务任务。