小米MiMo-V2.6双模实测:Flash惊喜,Pro成谜
小米MiMo-V2.6实测:Flash性价比惊艳,Pro表现两极分化,极低缓存定价是最大杀器。
小米发布的MiMo-V2.6 Flash与Pro两款开源模型在实测中表现分化明显。Flash版本在常规榜单中超越DeepSeek 4.1 Flash,长程任务和价格竞争力均表现出色,是Flash级别的有力选手。而官方主推、号称对标Kimi K3的Pro模型却多次不敌自家Flash,甚至在复杂全栈任务中出现404错误,令人困惑。两款模型共同的短板是世界知识不足,动画SVG中太阳月亮运行轨迹错误是典型体现。但MiMo真正的杀手锏在于定价策略:缓存命中价格极低,在高缓存命中率的Agent场景下,Flash成本不到千问3.8的一半,Pro的总成本甚至低于DeepSeek Flash高峰期价格,对重度Agent用户极具吸引力。
小米正式发布 MiMo-V2.6,Flash 和 Pro 两款模型权重同步开源。官方在 AA 榜单上放出成绩,宣称 2.6 Pro 超过 Kimi K3 和千问 3.8 Max,坐上当前最强开源模型的位置。这套打法很典型的小米味道——硬钢竞品,后发制人。但真正的看点,是官方报告里那张定价对比图:在同等智能水平下,两款新模型的价格仅为海外模型的 1/20 到 1/60。
本文基于 B站 UP主对 MiMo-V2.6 Flash 与 Pro 的实测评测整理,核心结论是:Flash 版本惊喜十足,Pro 版本则让人又爱又恨。
常规榜单:Pro 竟然打不过自家 Flash
在常规测试榜单里,2.6 Flash 排在第三名,比 DeepSeek广告 4.1 Flash 高出一分,稳稳站在 Flash 级别第一梯队。但让人大跌眼镜的是,官方主推、号称对标 Kimi K3 的 Pro 模型,居然没能打过自家的 Flash。
这就带来一个直接的疑问:如果 Pro 真如官方所说对标 Kimi K3,那它理应在常规榜单上碾压全场,而不是屈居自家 Flash 之下。这个反常现象贯穿了后续几乎所有测试,成为整期评测的核心悬念。
从定价上看,无论性能还是价格,MiMo 明显是冲着 DeepSeek 而非 Kimi 去的。因此评测直接安排 MiMo 与 DeepSeek 来一场正面厮杀,用同样的提示词、同样的任务,看清真实水平。
Flash 与 Pro 是目前大模型厂商常见的产品分级命名惯例,通常 Flash(或 Mini、Lite)定位为轻量快速、低成本的小参数版本,Pro(或 Plus、Max)则是性能优先的旗舰版本,参数量更大、推理能力更强,但价格也更高。理论上 Pro 应在几乎所有任务上优于 Flash。MiMo-V2.6 中 Pro 在多项测试里反而落后于 Flash,暗示两者在架构或训练策略上可能存在非对称权衡——Pro 或许针对特定场景(如视觉交互、Agent 缓存场景)做了定向优化,而非追求全面超越,这也解释了为何官方将 Pro 定位为对标 Kimi K3 而非 DeepSeek Flash 的竞品。
动画 SVG 测试:世界知识短板暴露
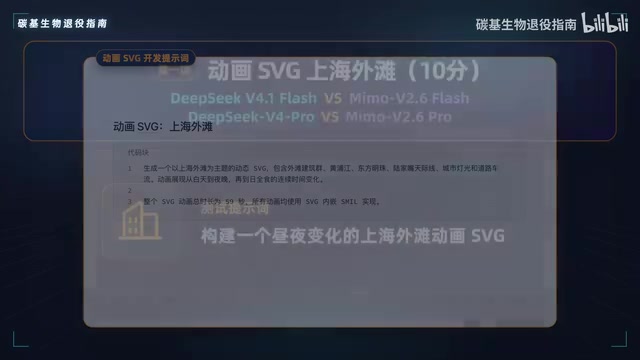
第一项是动画 SVG「上海外滩」,四个模型使用完全相同的提示词,要求生成一段包含昼夜变化的外滩动画。
两个 Flash 模型对比中,MiMo 把外滩两岸的建筑都画在了同一侧,太阳升起和落下没有自然的运动弧度,基本是直上直下,不符合自然规律,天空光线层次也稍逊。最终 DeepSeek(小鲸鱼)7 分,MiMo 6 分,略胜一筹。
Pro 模型的对比反而有意思。由于 DeepSeek 上一代 V4 版本整体审美偏弱,MiMo 这边效果明显更好:两侧建筑形象,钟楼、外滩三件套、电视塔一应俱全,云彩效果也不错。但致命缺点是太阳和月亮的运行轨迹完全错误。两款 MiMo 模型的世界知识都存在缺陷,这一项只给到 8 分。
长程任务:Pro 的 404 与单薄实现
第二项直接上强度——一个「修真奶茶铺」小说图文阅读网站,属于复杂长程任务。模型要处理约一季的原始素材,写入数据库、构建前后端,最终交付一个能运行的全站应用。
Flash 层面,MiMo Flash 凭借绝对的速度和价格优势战胜 DeepSeek,分数上也高出一分。这进一步印证了 Flash 版本的成色。
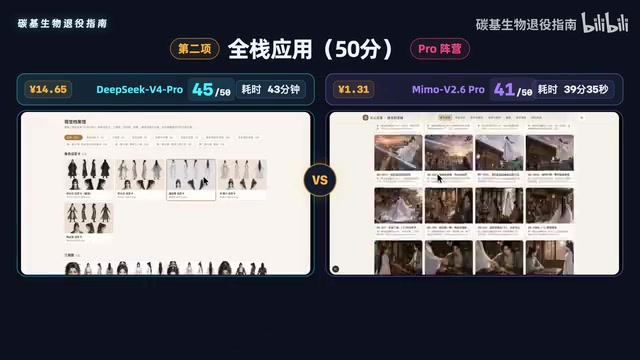
到了 Pro 层面,DeepSeek 拿到 15 分(原文数据),而号称对标 Kimi K3 的 2.6 Pro 竟然出现 404 错误,整体实现比自家 Flash 还要单薄,只能给到 41 分(原文数据),且耗时是 Flash 的两倍,唯一亮眼的只剩价格。Pro 模型的表现在此再次令人困惑。
长程任务(Long-horizon Task) 是评测大模型实际工程能力的重要维度,区别于单轮问答或简单代码补全。此类任务要求模型在一次对话或自主执行流程中,持续规划、分解子任务、调用工具、处理中间结果,并最终交付一个完整可运行的复杂产物。「修真奶茶铺」全站生成属于典型的长程任务:模型需要理解原始故事素材、设计数据库 Schema、编写后端 API、构建前端页面并保证各模块协同运行。长程任务对模型的指令遵循一致性、上下文窗口利用效率以及错误自纠能力要求极高,是区分"能用"与"真好用"的核心试金石,也是当前主流模型普遍存在明显短板的领域。
元素沙盒:Pro 的视觉表现力扳回一城
第三项元素沙盒测试中,两个 Flash 模型在 3D 建模、动效、粒子特效上各有所长,但整体都偏呆板。DeepSeek 的光柱没做出尖锐感,只是一根直柱;MiMo 用燃烧表现效果,但大地震机连震动都没有。两边半斤八两,各 6 分。值得肯定的是,MiMo 的翻译完成得很好,没有遗漏。
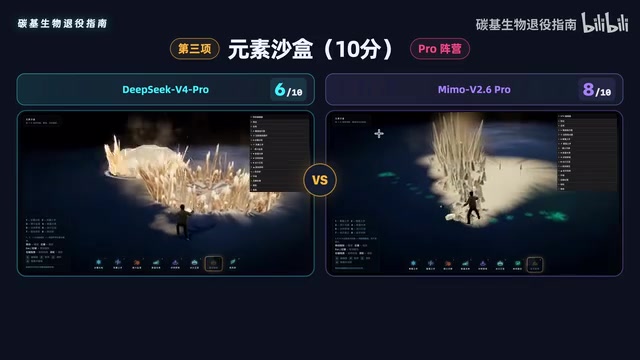
Pro 层面 MiMo 的视觉表现力更强,两个游戏技能差异明显。DeepSeek Pro 本身也不错,但有一半菜单栏没有翻译,综合只能拿 6 分,MiMo Pro 拿到 8 分。可以看出,Pro 版本并非全无亮点,在偏视觉和交互的任务上反而更能发挥。
价格才是真杀器:缓存命中定价极致实惠
整套测试下来,小米和 DeepSeek 这两组模型算得上棋逢对手、各有千秋。但真正的差距体现在花费上——MiMo 花的钱比 DeepSeek 低太多。
MiMo 最大的亮点是缓存命中定价极其实惠,尤其是 Pro 模型的缓存价格。这套打法酷似早期的 DeepSeek:靠极低价缓存吸引用户入坑,对重度跑 Agent 的玩家极具吸引力。
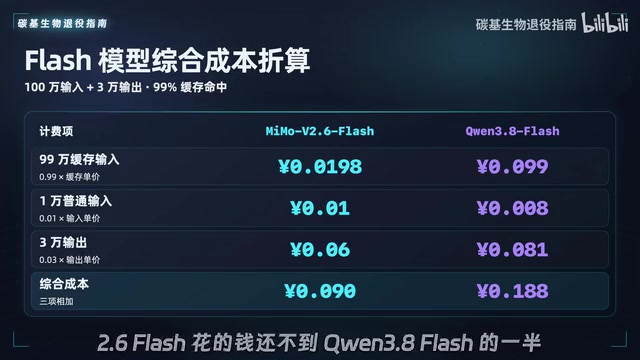
以一个真实任务算账:百万输入、三万输出、99% 缓存命中。这类任务下,2.6 Flash 花的钱还不到千问 3.8 Flash 的一半。要知道在 MiMo 2.6 发布前,千问 3.8 已是市面上公认最便宜的 Flash 模型。
同样条件下算 2.6 Pro 的账,由于缓存价格极低,总成本竟比 DeepSeek Flash 高峰期价格还要低。换句话说,在白天工作时段跑小米的 Pro 模型,花的钱还不到 DeepSeek Flash 的八成。这才是 MiMo Pro 最大的隐藏优势。
缓存命中(Cache Hit) 是大模型 API 计费中的关键概念。当用户多次发送包含相同前缀内容的请求时(如固定的系统提示词、长篇文档、代码库等),模型服务商会将首次处理的 KV 缓存保留一段时间。后续请求命中缓存的部分无需重新计算,因此按更低的"缓存命中价格"计费,只有新增的输入 token 才按全价收取。对于 Agent 场景,每轮对话都会携带完整的历史上下文和工具描述,输入 token 量极大,且大量内容在多轮之间保持不变,缓存命中率往往高达 90% 以上。这意味着缓存价格的高低,对重度 Agent 用户的实际成本影响远超模型标称的输入单价,是选型时最值得关注的隐藏变量。
结论:Flash 惊喜,Pro 复杂
整体来看,2.6 Flash 确实让人惊喜——价格极其能打,性能稳稳扎在 Flash 级别第一梯队。而 Pro 模型的感受则比较复杂:有时连自家 Flash 都打不过,但在部分任务上又特别出彩,加上极致的缓存定价,仍有不可忽视的价值。
以上测试与体验仅代表评测者个人观点,仅供参考。对于重度 Agent 用户,MiMo 极低的缓存价格或许比榜单排名更值得关注。
相关推荐
Google AI全能变现手册:Gemini生态12个接单实操玩法
谷歌AI生态被低估?B站UP主Neo拆解Gemini、Deep Research、Notebook、Flow等12个谷歌AI工具的实操变现路径,涵盖卖认知、卖手艺、卖视频、卖工具、卖效率五大方向,附真实报价与接单玩法。
Gemini Canvas 完整教程:从文档到网站与应用的生产工具
Gemini Canvas 完整用法教程:从单个提示生成可编辑文档、可分享网站、无代码应用、数据仪表盘到音频播客,附四种进阶工作流组合与真实使用限制说明。
Grok 4.7 vs MiMo V2.6 Pro/Flash 三模型实测对比
Grok 4.7 与小米 MiMo V2.6 Pro/Flash 三模型横向实测:涵盖 3D 建模、游戏交互、Web 页面、折纸与写作任务。Grok 4.7 Token 消耗大速度慢,MiMo Flash 意外强于 Pro,性价比突出。