小模型语法控制:SMC让语言学习对话更精准

用SMC与轻量势函数引导小模型生成目标语法,效果超越大140倍模型。
文章介绍了一项面向语言学习应用的语法可控对话生成研究。由于设备端小型语言模型难以稳定生成目标语法结构,而大型前沿模型虽可通过提示实现却资源消耗巨大,研究团队采用序列蒙特卡洛(SMC)方法,在生成过程中引入少量手工设计的势函数对候选序列重加权,引导小模型对话走向专家设定的语法目标。实验显示,该方法使小模型语法覆盖近乎完美,并超越参数量大140倍的先进模型。团队进一步利用前沿模型进行代码合成,自动生成新势函数,将方法扩展至数百个语法技能,且无需额外训练或监督数据,为离线、资源受限环境下的个性化语法教学提供了新路径。
引言
在语言学习应用中,为学习者提供符合其语法水平的交互式对话至关重要。然而,在设备端运行的小型语言模型往往难以稳定生成目标语法结构,而大型前沿模型虽能通过提示实现,却资源消耗巨大。最近一项研究提出使用序列蒙特卡洛(SMC)方法,引导小模型的对话生成走向专家设定的语法目标,仅需少量手工势函数即可实现近乎完美的语法覆盖,甚至让小模型超越比自身大140倍的先进模型。
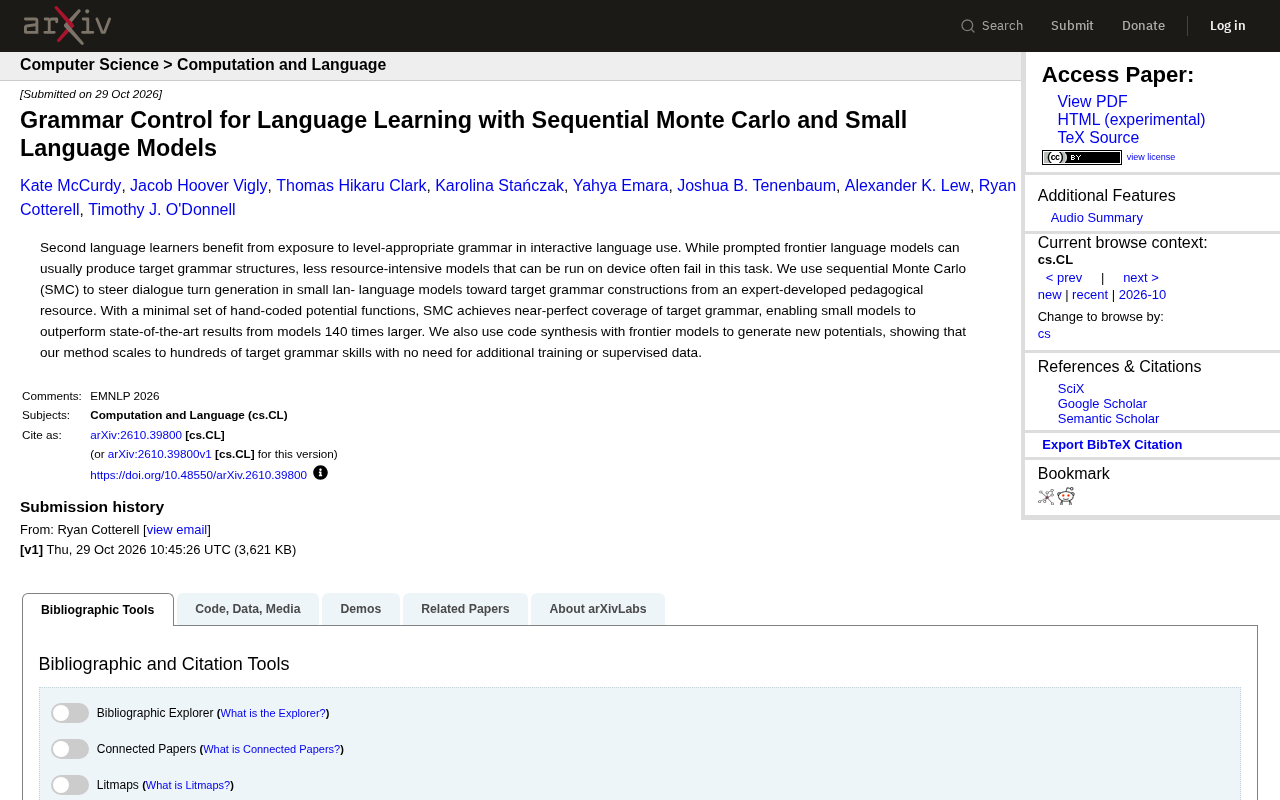
问题背景:小模型语法控制之难
第二语言学习者需要接触与其水平匹配的语法结构,但小模型在交互中常偏离目标。前沿模型虽可通过提示生成特定语法,但难以在资源受限的设备上部署。研究团队从专家教学资源中提取目标语法构式,尝试用SMC引导对话轮次生成。
SMC方法:轻量势函数引导生成
SMC是一种序贯重要性采样技术,通过在生成过程中引入势函数来重加权候选序列。研究中仅使用少量手工设计的势函数,便显著提升了小模型对目标语法的覆盖率。实验表明,该方法使小模型在语法覆盖上达到近乎完美,并超越了参数量大140倍的先进模型的表现。
序列蒙特卡洛(SMC) 是一类基于序贯重要性采样(Sequential Importance Sampling)的推理算法,最初用于贝叶斯滤波与状态空间模型,后被引入自然语言生成领域。其核心思想是:在逐步生成 token 或对话轮次的过程中,维护一组带权重的候选序列(粒子),每步根据势函数对粒子重新加权并重采样,使高权重粒子(更符合目标约束的序列)获得更多延续机会。与一次性采样或束搜索不同,SMC 能在生成中途动态纠偏,因此特别适合“必须出现某些结构”这类硬约束场景。
势函数(potential function) 是 SMC 中定义“当前部分序列离目标有多近”的打分函数,可取任意形式,例如统计目标语法构式是否已出现、出现频次或结构匹配度。势函数值越高,对应粒子权重越大。由于势函数无需可微、也无需训练,只需能用代码计算,因此研究中的手工势函数实现成本极低,这也是该方法能在设备端轻量部署的关键。
扩展性:代码合成生成新势函数
为验证方法可扩展性,团队利用前沿模型进行代码合成,自动生成新的势函数,从而覆盖数百个目标语法技能,且无需额外训练或监督数据。这为大规模个性化语法教学提供了可能。
代码合成(code synthesis) 指让大语言模型根据自然语言描述自动编写可执行程序,在这里即“为某个目标语法技能生成对应的势函数代码”。相比人工逐个设计势函数,代码合成把“定义约束”转化为“描述约束”,大幅降低了扩展到数百个语法技能的人力成本。生成的势函数只需通过简单测试即可接入 SMC 流程,整个过程不涉及对小型模型的再训练或额外标注数据,因而保持了方法的轻量与可插拔特性。
意义与展望
该研究为资源受限环境下的语法可控生成开辟了新路径。通过SMC与小型模型的结合,有望在离线学习工具中实现精准的语法训练,推动自适应语言学习的发展。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。

Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。