小目标看不清?视觉语言模型缩放策略实测

在线视觉语言模型默认缩图会丢失小物体细节,分块与两步缩放可有效补救。
文章系统梳理了在线视觉语言模型在处理大图时的精度损失问题:服务端默认缩放或拒绝大图,导致小物体在进入模型前就被降采样,模型可读的最小文字尺寸从不超过6像素恶化到10至13像素。实测七个模型后发现,将图片切成最多九块可显著提升Claude和Gemini的准确率(11.1至14.5个百分点),并让GPT-6.1 Sol免于拒绝、准确率从50.7%升至83.7%;两步缩放则以约40%的图像token达到接近分块的效果。文章还揭示不同模型的失败模式差异:Gemini更易自信答错,Claude更倾向承认看不清。基于模型不确定性的触发式分块,被证明是兼顾成本与效果的最优折中。
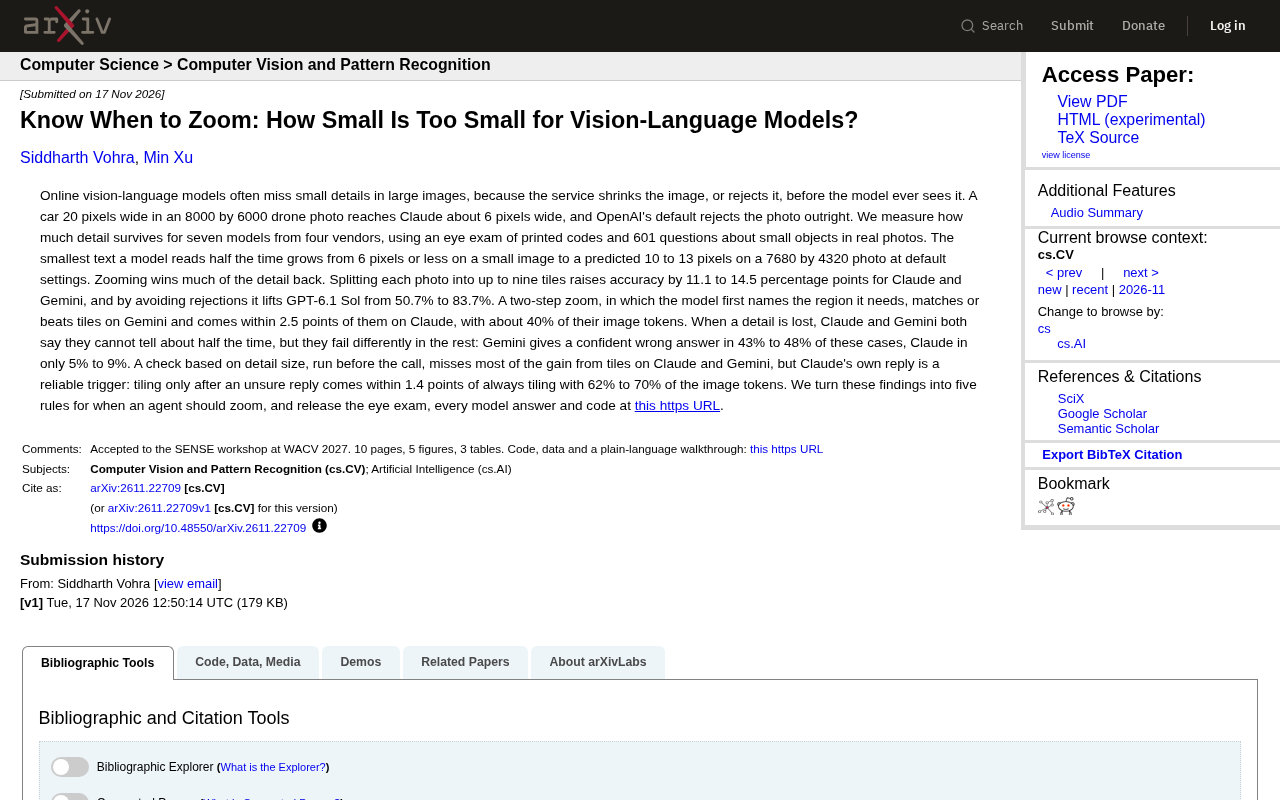
当你把一张8000×6000的无人机照片传给在线视觉语言模型时,图片里的汽车可能只有20像素宽。但模型真正看到的,可能只剩6像素——甚至更糟,照片直接被拒绝。这是当前多模态服务的一个普遍困境:在模型处理之前,图片已经被服务端缩小或过滤了。
一项系统性的实测揭示了这个问题有多严重。研究者用“视力表”式的印刷编码和601个关于真实照片中小物体的问答,测了来自四家厂商的七个模型,发现模型能读出的最小文字尺寸,在小图上是不超过6像素,而在7680×4320的大图上默认设置下会恶化到10到13像素。换句话说,同样大小的物体,在大图里更容易被模型“看不清”。
默认缩图:看不见的精度损失
在线视觉语言模型的图片处理管线并不透明。用户上传的图片在到达模型之前,往往会被服务端缩放或拒绝。研究给出的例子很直观:一张8000×6000的无人机照片中,一辆20像素宽的汽车传到Claude时只剩约6像素,而OpenAI的默认设置直接拒绝了这张照片。
这意味着,很多“模型答不对”的情况,其实不是模型能力不足,而是信息在预处理阶段就丢了。研究用印刷编码测试了七个模型的“视力极限”:在小图上,模型能稳定读出的最小文字尺寸不超过6像素;而在大图默认设置下,这个阈值预测会升到10到13像素。
视觉语言模型的图像预处理并非简单的格式转换。主流服务通常会对上传图片做两类操作:一是等比缩放至模型支持的最大分辨率(如将长边限制在1024或2048像素),二是基于文件大小或像素总量做拒绝判定。这两类操作的共同后果是:原始图像中的高频细节——文字、小物体、细纹理——在进入模型视觉编码器之前就被降采样抹除了。更隐蔽的是,不同厂商的缩放算法、目标分辨率和拒绝阈值并不公开,开发者只能通过实测反推。这就是为什么同一张图在不同平台上表现迥异,也是“模型能力”与“服务管线”需要分开评估的原因。
分块与两步缩放:把细节找回来
好消息是,缩放策略能挽回大部分细节。一种直接的方法是把每张照片切成最多九块(tiles)分别送进模型。实测显示,这种做法对Claude和Gemini的准确率提升了11.1到14.5个百分点。对GPT-6.1 Sol来说,分块的主要收益来自避免拒绝:准确率从50.7%升到83.7%。
另一种更省token的策略是“两步缩放”:模型先说出它需要看的区域,再针对该区域放大。在Gemini上,两步缩放匹配甚至超过了分块方案;在Claude上,它与分块方案的差距在2.5个百分点以内,而消耗的图像token只有分块的约40%。
这提示了一个实用方向:不是所有场景都需要无脑分块,先让模型“指哪打哪”可能更经济。
分块(tiling)之所以有效,是因为它绕过了全局缩放的分辨率上限:把一张大图切成多块后,每块在送入模型时都能以接近原始像素密度被编码,相当于变相提高了有效分辨率。但分块并非没有代价——每块都会消耗独立的图像token,块数越多,上下文预算和推理成本越高,块与块之间的边界信息也可能丢失。两步缩放则是一种“先粗后精”的检索式策略:第一轮用缩略图让模型定位感兴趣区域,第二轮只对该区域做高分辨率裁剪。它的前提是模型具备可靠的区域定位能力,否则第一步的定位误差会被第二步放大。两种策略本质上是在分辨率、token成本与定位可靠性之间做不同的权衡。
模型失败模式大不同:诚实说不知道 vs 自信答错
当细节确实丢失时,不同模型的表现差异明显。Claude和Gemini都有约一半的时间会说“无法判断”,但在剩下的情况下,两者的失败方式截然不同:Gemini有43%到48%的概率给出自信的错误答案,而Claude只有5%到9%。
这个差异对实际应用很关键。一个会说“看不清”的模型,至少给用户留下了人工复核的空间;而一个自信编造的模型,可能让错误悄悄流入下游流程。选择模型时,这种“失败时的诚实度”值得纳入考量。
“自信答错”在评测中通常对应校准(calibration)概念:模型对自身回答正确性的置信度是否与真实准确率匹配。一个校准良好的模型在信息不足时应该输出低置信度或明确拒答,而校准差的模型会把猜测包装成确定结论。视觉语言模型的校准问题比纯文本模型更突出,因为细节缺失往往是“局部且不易察觉”的——模型看到了整体场景,却误以为自己看清了微小目标。这种失败在医疗影像、工业质检、遥感判读等下游场景中尤其危险,因为人工复核通常只针对模型标记为不确定的样本。因此,拒答率与误答率应当作为一对联合指标来评估,而非只看准确率。
何时该缩放:触发策略比阈值更有效
研究者还测试了如何决定“什么时候需要缩放”。一种思路是在调用前根据细节尺寸做检查,但这种方法在Claude和Gemini上会错过分块带来的大部分收益。
更可靠的触发信号来自模型自己的回复:只有当模型表示不确定时再启用分块,在Claude上只比“总是分块”低1.4个百分点,却只消耗62%到70%的图像token。这说明,让模型先表态、再决定是否放大,是一个兼顾成本和效果的折中方案。
五条规则与开放资源
基于这些发现,研究者总结出五条规则,指导智能体何时应该缩放图像。同时,他们将“视力表”测试、所有模型的回答以及代码开源在 https://siddvoh.com/know-when-to-zoom ,为后续研究和工程实践提供了可复现的基础。
对于构建多模态应用的开发者来说,这项工作的核心提醒是:在上传图片之前,先想清楚细节会不会在预处理中丢失。如果会,分块或两步缩放是有效的补救手段;而如果预算有限,基于模型不确定性的触发式缩放,可能是性价比最高的选择。
模型不是万能的,但知道它什么时候“看不清”,以及如何让它看得更清,是把视觉语言模型用好的关键。
相关推荐
计算机科学家为何认为超级智能不会成真
计算机科学家Cal Newport从工程角度反驳超级智能叙事:递归自我改进受限于数据瓶颈与算力约束,超级智能未必可计算,LLM智能体的失控源于架构而非对齐难题。他警告,追逐ASI本身就是一种过失。
Holiday Extras员工把AI助手当“狗”养:Brian与Beast的真实工作日常
Holiday Extras员工将AI助手命名为Beast,每天早晚对话、提前准备会议数据、监控任务进展。本文还原一个真实用户如何把AI嵌入日常工作流,并给出低门槛启动建议。
十亿美元级合作:美国电池市场迎来转机?
Sila与Panasonic Energy签署十亿美元级硅碳负极供应协议,本文分析该交易对美国下一代电池市场、供应链本土化及商业化前景的影响。