信任AI写的代码:一个Rust包管理器的五天极限测试

27年经验工程师用Claude生成jpm,再用五天166个项目测试证明其可信。
一位27年经验的软件工程师用Claude在一个下午生成Rust包管理器jpm,随后花五天对166个真实项目进行安装、构建和测试比对,合并261个PR完成硬化。文章强调AI能生成代码,但人的价值在于判断哪些测试能证明什么、何时坚持、何时认输。Claude两次反对作者决策:TLS自实现被作者用Wycheproof等测试说服,HTTP/2则被数据证明是错的,3671行代码全部删除。jpm二进制压到2MB,CI冷安装nuxt中位数1.22秒领先bun和pnpm,并修复了.npmrc泄露token等安全问题。作者主张AI生成后必须用测试证明修复,接受AI提交的PR但要求附带测试。
一位拥有27年经验的软件工程师,让Claude在一下午写出一个Rust包管理器,然后用五天时间说服自己可以信任它。jpm的故事不是关于AI能写出什么,而是关于如何验证AI写出的东西。
一个下午的vibe coding
jpm是一个能在npm、pnpm、yarn和bun项目中工作的JavaScript包管理器。它的作者没有写也没有读过一行代码,甚至让AI自己写TLS、crypto和http模块来缩小体积。最初版本只花了一个下午就完成,用作者自己的话说,"一个真正的vibe coded项目"。
作者背景值得关注:他主要使用C#、Elixir和JavaScript这类高层语言,除了小时候用C帮父亲调试磁盘控制器,几乎没有低层语言经验。所以用Rust构建一个6万行以上的项目,在他看来"短时间内不可能自己完成"。他从Node.js 0.8(2012年)就开始专业使用Node.js,对npm、pnpm和bun的工作方式了如指掌。
触发这个项目的,是一期Syntax播客。主持人Wes、Scott和CJ在节目中聊到Pooya用JavaScript写的upm——一个快速且小巧的包管理器。作者当时的想法是:既然这么多工具都用Rust重写,也许可以做一个更小更快的。
为什么是jpm
播客中讨论的核心问题恰好是当下每个工程师都在问的:AI能构建真实软件,还是只能做demo?大部分听众相信AI可以一键生成任何东西。作者给出的判断是:"剧透一下,它能。但如果没有人的指导和软件工程理解,结果就是不好。"
这个判断贯穿了整个项目。Claude在约45分钟内产出了一个可工作的版本,但依赖大量第三方Rust crate,二进制体积庞大,且只在一个很小的package.json文件上测试过。作者随后让它分析体积来源,到当晚结束时,已经有了自定义的HTTP、JSON、crypto和TLS模块,以及一个明显更小的二进制文件。
五天硬化:验证才是真的工作
vibe coding项目往往忽略的部分——真实环境的测试。作者让Claude写了一个脚本,对100个、后来增加到166个大型公开项目进行安装和构建,然后用这些项目原本使用的包管理器执行同样的操作进行对比,包括尽可能运行它们的测试套件。同时在Windows命令行、PowerShell和mac上执行同样的流程。
五天后,结果是261个合并的PR和一个经过硬化测试的包管理器。
作者对方向的把控体现在一系列具体决策上:Claude说更快的锁文件格式只能省几毫秒,作者仍然要求做;Claude想让全局存储作为可选功能,作者反问"如果99%的包都能用,为什么要可选",于是它成了默认行为;作者坚持不自动运行依赖的install脚本,除非明确列出——他的理由是,现在AI做了大部分工作,审批一个包的脚本前,可以先让AI审查有没有问题。
两次坚持与一次认错
Claude有两次明确反对作者的决定,但两次作者都坚持了。
第一次是TLS。为了缩小二进制,作者想自己实现TLS和crypto。Claude说"这是你永远不该自己写的代码"。作者反驳这是过时的工程思维:在Rust里,Heartbleed那类内存漏洞不存在,而且可以像任何代码一样重度测试。Claude同意自己高估了风险,并列出了能证明的测试套件:Wycheproof、NIST vectors、x509-limbo、BoGo。
但作者也坦承疑虑:"Claude喜欢拍马屁,它说自己高估了风险,也可能只是在配合我。"不过它通过了包括来自其他项目真实bug转化而来的测试。作者说,不管是谁写的,他现在会信任它更多。
第二次是HTTP/2。Claude先用curl测试,说不值得做,因为jpm整个安装流程走HTTP/1.1已经比curl的HTTP/2下载还快。作者还是坚持:curl要处理所有情况,我们只需要对一个registry发很多GET请求,要打败bun就得跳出常规。Claude两小时后写出了可工作的客户端。
这次作者错了。实测量显示:在家用连接上HTTP/2快约17%,但在GitHub runner上持平或更差,冷启动nuxt安装时最多慢2倍,大tarball上多用8%到15%的CPU,还给二进制增加了60KB。所以3671行代码被全部删除。
反向的例子也有。jpm可以帮用户安装Node,作者想给Node签名检查加一个开关,觉得它会拖慢安装。Claude测出只有15到19毫秒,并指出"开关意味着没人会打开它"。最终签名检查默认开启,作者对此表示满意。
Wycheproof 是 Google 开源的一组密码学测试向量,专门用于暴露加密库实现中的边缘错误,比如无效曲线点、畸形签名或极端长度的输入。它覆盖 AES、ECDH、RSA、Ed25519 等常见算法,每个测试用例都标注了预期结果。之所以重要,是因为密码学代码最容易在“看起来不可能”的输入上出错,而这些错误往往不会被常规单元测试发现。配合 NIST 官方测试向量、x509-limbo(X.509 证书解析测试集)和 BoGo(BoringSSL 的 TLS 互操作测试套件),可以较系统地验证一个自实现的 TLS/crypto 栈是否在协议层和实现层都站得住脚。作者正是用这四类测试来回应 Claude 对“自己写 TLS 风险太高”的担忧。
凭什么信任没人打字的代码
短答案是:Wycheproof、node-semver、pnpm、yarn和bun自己的测试,以及166个真实仓库。过程中发现的bug包括:node-semver自己的测试发现25处jpm的判断不一致,比如把^9007199254740991.0.0当作合法范围;npm-package-arg的测试最初154个只通过117个;一次安全扫描发现克隆仓库的.npmrc能把registry token通过它自己的代理发出去,概念验证捕获到了Bearer USER-SECRET-TOKEN;在真实仓库上,jpm与pnpm的依赖链接差异从1320降到183,与npm的差异从614降到14;macOS上在测试前根本编译不过。
作者并不认为这证明了代码没有bug:"在这个行业做了这么多年,我知道无论多少测试,没有东西是没有bug的。"他的计划是在自己所有项目中继续使用jpm,接受修复PR包括AI提交的,但要求它们必须用测试证明在修复什么。
node-semver 是 npm 生态中负责解析和比较语义化版本范围的库,^、~、>= 等写法以及预发布版本的处理规则都由它定义。由于几乎所有包管理器都要判断“某个依赖版本是否满足范围”,node-semver 的测试集就成了事实上的兼容性标准。jpm 在接入该测试集后发现 25 处判断不一致,例如把 ^9007199254740991.0.0 当作合法范围——这暴露的是数值上限和溢出处理的差异。npm-package-arg 则负责解析 package.json 中各种依赖写法(git URL、tarball、别名等),它的测试通过率从 117/154 起步,说明包名与依赖说明符的解析远比表面看起来复杂。复用这些既有测试集,等于把社区多年积累的边缘案例直接变成验收标准。
当前状态与短板
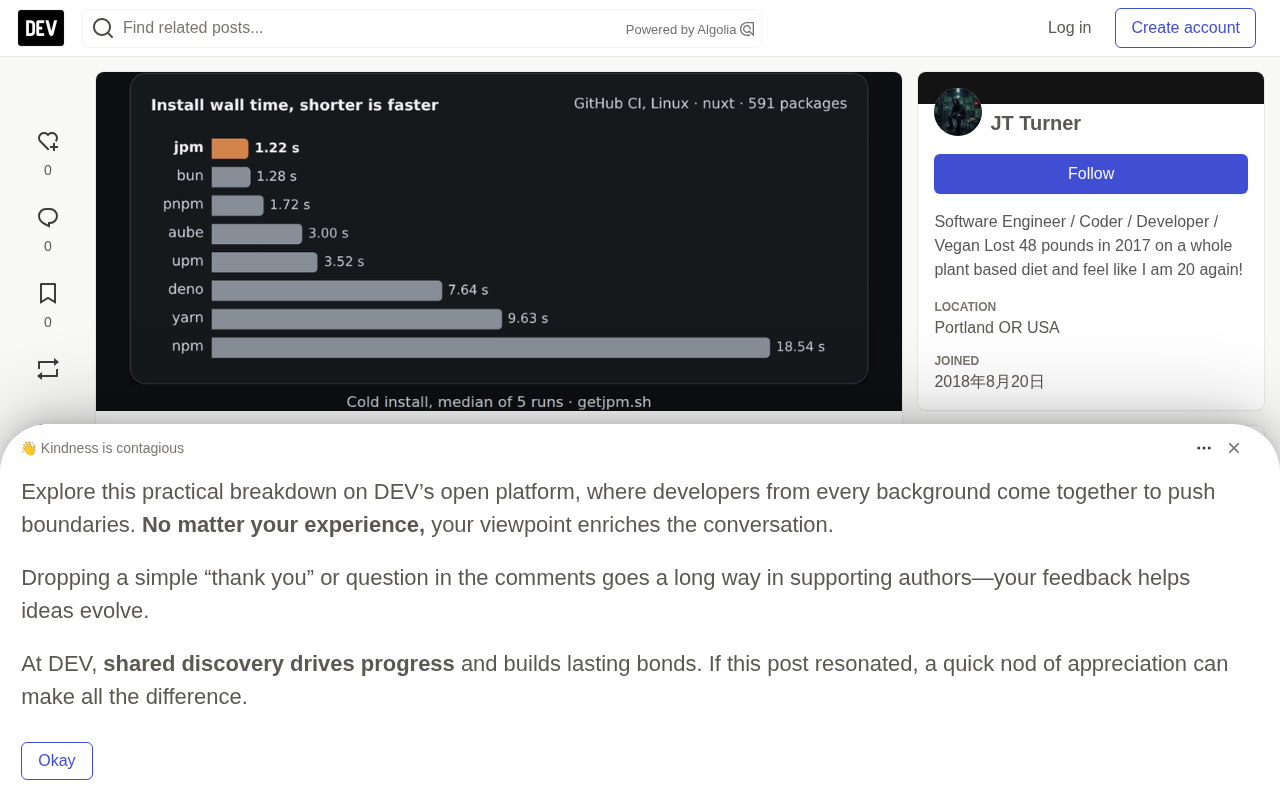
jpm的二进制被压到2MB,速度不是永远最快但处于第一梯队,安全性是卖点之一:不审批就不运行脚本、包发布时间不足一天不升级到最新版、以及围绕.npmrc的安全加固。在GitHub Actions runner上冷启动安装nuxt(591个包)的中位数:jpm 1.22秒,bun 1.28秒,pnpm 1.72秒,npm 18.54秒。
作者对benchmark的局限很坦率:只测了三个仓库,Windows上nuxt被Defender扫描拖累,macOS上bun和aube在热安装上更快。
冷启动安装与热安装是包管理器 benchmark 中两个容易混淆的场景。冷启动指清空缓存后从零下载并解压所有依赖,更接近 CI runner 或新机器上的真实体验;热安装则依赖本地全局存储或缓存,很多包已经存在,测的是链接和校验开销。作者选择在 GitHub Actions runner 上测冷启动 nuxt(591 个包),正是因为 CI 环境最接近“无缓存”且可重复。Windows 上 Defender 实时扫描会显著拖慢文件写入,macOS 上 bun 和 aube 在热安装上更快,都说明单一数字不能代表所有工作负载。把 jpm 的 1.22 秒与 bun 的 1.28 秒、pnpm 的 1.72 秒放在同一张表里时,必须同时说明测试平台、缓存状态和仓库规模,否则结论会被误读。
对AI编程的真实启示
jpm的故事提供了一组清晰的分工样本。AI负责生成和方向性探索,人的价值集中在判断哪些测试能证明什么、什么时候坚持、什么时候认输。作者没有写代码,但他做了大量微小决策,并用测试数据推翻了自己的判断。
这或许比"AI能不能写代码"更值得讨论:当生成成本趋近于零,验证成本就成了决定工程质量的关键变量。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。