修复数字孪生而非检测器:路边LiDAR仿真到现实检测

UrbanTwin挑战赛冠军方案揭示:Sim-to-Real性能提升主要来自修正数字孪生与真实站点的系统性差异,而非改进检测器。
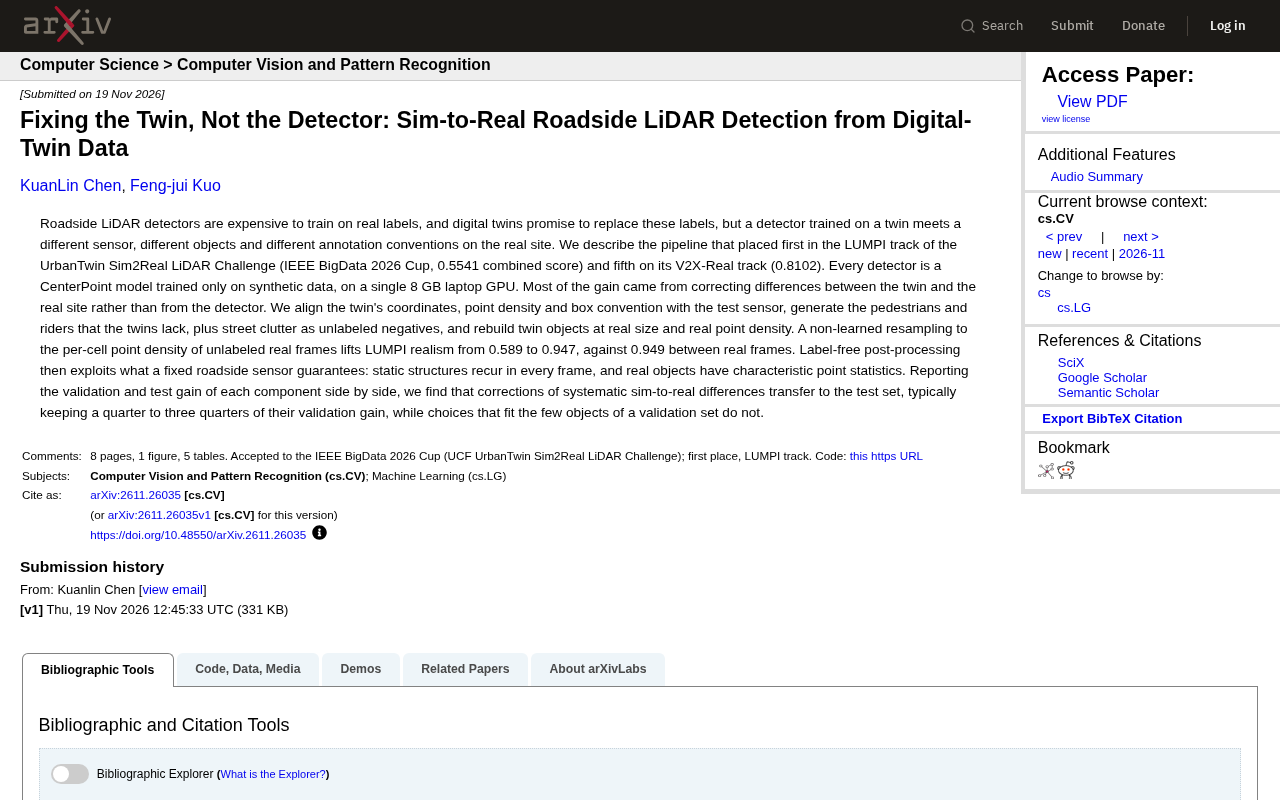
本文介绍了IEEE BigData 2026 Cup UrbanTwin Sim2Real LiDAR挑战赛中的获奖方案。该团队在LUMPI赛道以0.5541得分夺冠,在V2X-Real赛道获得第五名。所有检测器均采用CenterPoint模型,完全在合成数据上训练,仅使用一块8 GB笔记本GPU。核心发现是:大部分性能增益来自修正数字孪生与真实站点之间的系统性差异(如坐标系、点密度、标注约定),而非检测器架构本身。团队采用非学习式重采样将孪生点云密度对齐真实分布,使LUMPI真实性指标从0.589提升至0.947;并利用固定路边传感器的物理先验进行无标签后处理。研究还发现,针对系统性偏差的修正增益可迁移至测试集,而在小规模验证集上拟合的选择则无法迁移。
在自动驾驶与智慧交通领域,路边LiDAR检测器的训练长期受困于真实标注数据的高昂成本。数字孪生技术被寄予厚望,试图用虚拟世界替代真实标签。然而,一个在孪生环境中训练的检测器,一旦部署到真实路口,面对的是不同的传感器、不同的物体分布以及不同的标注习惯。这种仿真到现实(Sim-to-Real)的鸿沟,究竟该如何跨越?
在IEEE BigData 2026 Cup举办的UrbanTwin Sim2Real LiDAR挑战赛中,一支团队给出了他们的答案:修复孪生,而不是检测器。他们在LUMPI赛道中以0.5541的综合得分获得第一名,在V2X-Real赛道中以0.8102获得第五名。所有检测器均采用CenterPoint模型,完全在合成数据上训练,且仅使用一块8 GB的笔记本GPU。这一结果揭示了Sim-to-Real落地的关键所在。
核心发现:增益来自孪生对齐,而非模型本身
据该团队在论文中的描述,大部分性能提升并非来自检测器架构的改进,而是来自修正数字孪生与真实站点之间的差异。他们系统性地对齐了孪生环境的坐标系、点密度和边界框约定,使其与测试传感器匹配;同时生成了孪生数据中缺失的行人与骑行者目标,并将街道杂物作为未标注的负样本加入训练。此外,他们还按照真实尺寸和真实点密度重建了孪生中的物体。
这一思路与传统的“调模型”路径形成鲜明对比。当仿真数据与真实数据存在系统性偏差时,单纯增加模型复杂度或训练轮次,效果往往有限。该团队的工作表明,数据层面的对齐才是Sim-to-Real性能提升的主要杠杆。
数字孪生是物理实体(如真实路口)在虚拟空间中的高保真镜像,通常通过三维建模、传感器仿真和物理渲染构建。在自动驾驶领域,数字孪生被用于生成大量带标注的训练数据,以替代昂贵的人工标注。然而,孪生环境与真实世界之间往往存在系统性偏差,包括传感器参数(如激光雷达的线束分布、安装高度与角度)、场景内容(如行人、骑行者的出现频率)以及标注规范(如边界框的尺寸定义与朝向约定)等方面的不一致。这些偏差构成了Sim-to-Real鸿沟的主要来源。该团队的工作正是通过系统性地识别并修正这些偏差,使孪生数据在统计特性上逼近真实数据,从而提升下游检测器的泛化能力。
非学习式重采样:让孪生点云逼近真实分布
在点云密度这一关键维度上,团队采用了一种非学习的重采样方法,将孪生点云调整到未标注真实帧的逐单元点密度。这一操作将LUMPI数据集的真实性指标从0.589提升到了0.947,而真实帧之间的该指标为0.949。这意味着,经过重采样后的孪生数据,在点密度分布上已经与真实数据几乎无法区分。
这种非学习式的处理方式值得关注。它不依赖任何可训练参数,而是直接利用未标注真实帧的统计特性进行分布匹配。对于资源受限的场景——例如仅有一块8 GB GPU的笔记本——这种轻量级方案具有显著的实用价值。
点云密度指单位空间内激光雷达返回点的数量,受传感器线数、扫描模式、物体距离与反射率等因素影响。在Sim-to-Real场景中,孪生点云的密度分布若与真实传感器不一致,会导致检测器学习到错误的几何特征。非学习式重采样通过统计未标注真实帧的逐单元点密度,对孪生点云进行下采样或上采样,使其分布匹配真实数据,而不引入任何可训练参数。这种方法计算开销低,且不依赖真实标签,特别适合资源受限的部署环境。
无标签后处理:利用固定 roadside 传感器的物理先验
真实路口的LiDAR传感器位置固定,这一物理约束带来了两个可以利用的先验知识:静态结构在每一帧中都会重复出现,而真实物体具有特征性的点统计规律。团队据此设计了无标签后处理策略,进一步挖掘未标注真实数据中的信息。
这种后处理不依赖任何真实标签,而是利用传感器部署方式的确定性来过滤和修正检测结果。对于路边感知场景而言,这是一个被低估的免费信号。
无标签后处理指在模型推理阶段,不依赖任何真实标注,仅利用数据本身的统计规律或物理约束对检测结果进行修正。在路边固定传感器场景中,静态背景(如路面、护栏、建筑物)在连续帧中高度重复,可通过帧间一致性过滤虚假检测;同时,真实物体(如车辆、行人)的点云在高度、密度和反射强度上具有特征性分布,可用于剔除低置信度的误检。这种后处理策略无需额外训练,且能泛化到不同站点,是仿真数据训练模型部署到真实场景时的有效补充。
验证集增益与测试集增益的差异:哪些修正真正可迁移?
该研究最有价值的分析之一,是并排报告了每个组件在验证集和测试集上的增益。他们发现:针对系统性Sim-to-Real差异的修正,能够迁移到测试集,通常保留验证集增益的四分之一到四分之三;而那些在少量验证集物体上拟合出来的选择,则无法迁移。
这一发现对Sim-to-Real研究具有方法论意义。它提示研究者,应当优先关注那些修正系统性偏差的组件,而非针对小规模验证集调优的启发式规则。前者具有跨数据集的泛化能力,后者则容易过拟合。
对Sim-to-Real实践的启示
这项工作传递出一个清晰的信号:在数字孪生驱动的感知系统开发中,孪生环境的保真度对齐比检测器架构的选择更为关键。当仿真与现实的差距被系统性地缩小后,一个标准的CenterPoint模型在消费级GPU上也能取得有竞争力的结果。
对于工业界而言,这意味着Sim-to-Real的投入重心应当前移到数据管线的构建上——坐标系对齐、点密度匹配、标注约定统一、缺失类别补全。这些工作虽然不如模型创新那样引人注目,却可能是决定仿真数据能否真正替代真实标签的关键。
相关推荐
DevWorkflow 5.0:用AI五步法从想法到上线
DevWorkflow 5.0 是 Claude Code 插件,用五步流程让 AI 辅助开发从想法到上线。每个决定先问你,避免 AI 擅自加表加字段、文档代码不一致、测试未写就合并。支持多平台多语言,个人开发者和小团队适用。
Hermes Agent的.md文件如何工作?核心机制解析
解析 Hermes Agent 的 .hermes 目录机制:user.md 存个人信息、memory.md 记录值得记住的细节、soul.md 定义 Agent 性格。了解这套纯 Markdown 文件如何让 Agent 跨会话保持一致行为。
联合国“杀手机器人”谈判再陷僵局:自主武器监管为何难破冰
联合国日内瓦会议就自主武器(“杀手机器人”)规则展开谈判,一周磋商收效甚微,代表仅同意“开始讨论选项”。本文分析谈判僵局背后的定义分歧、安全诉求冲突与多边机制局限。