学AI两年却失去动力:AI编程时代还要不要继续学?

AI替代编码后,学AI的价值应从实现转向判断与编排。
一位Reddit网友在系统学习ML/DL、转向NLP与LLM后,因AI包办编码而动力严重下滑,朋友劝他转行。文章认为其挫败感源于把「写代码」当成学习终点,而机器学习真正的核心能力是问题定义、实验设计与结果解读等判断力,这些无法被自动补全替代。朋友对行业冲击的判断在重复性开发场景下成立,但软件工程师角色正在分化,系统设计与AI集成岗位需求反而上升。文章给出三条路径:转向模型评估与可靠性、把AI嵌入垂直业务、做AI工具的使用者与编排者;并建议从「学完再做」改为项目驱动学习,两年积累留下的是模型直觉而非代码量。
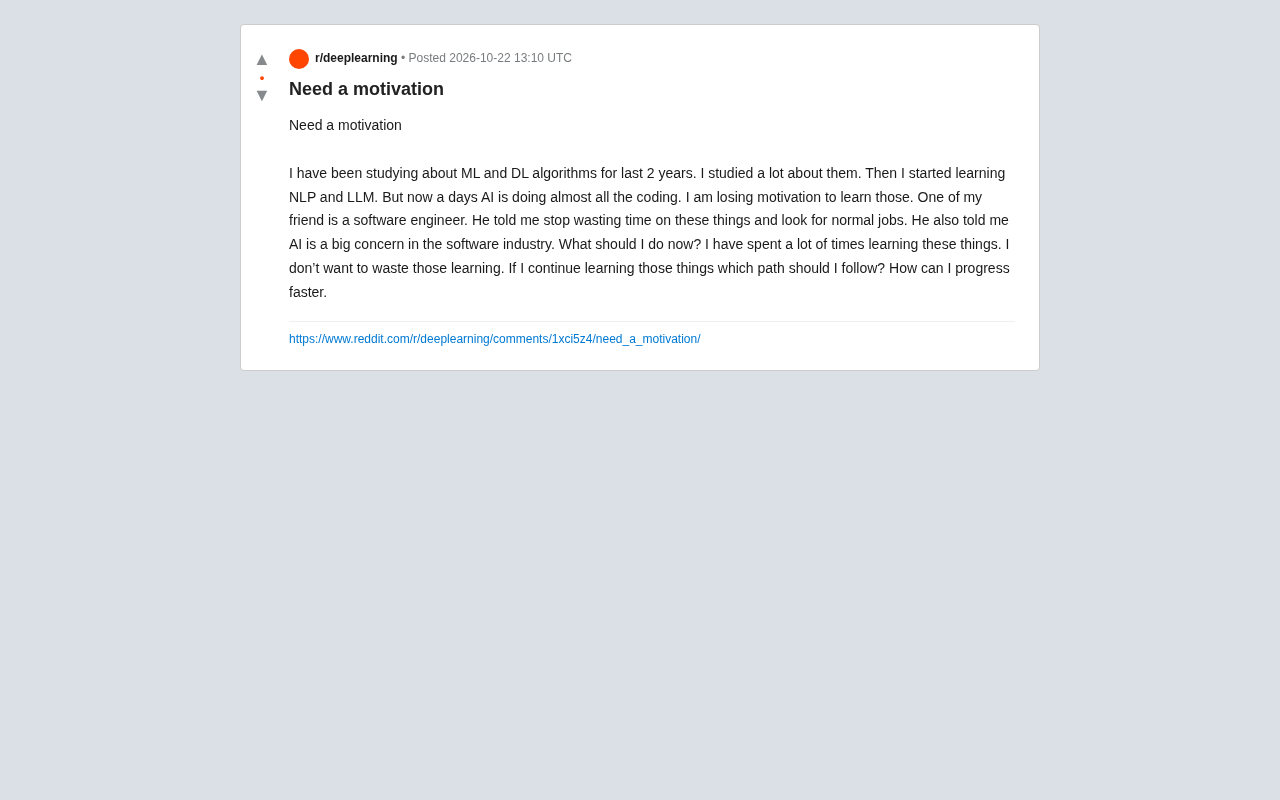
一位Reddit网友发帖求助:过去两年系统学习了机器学习和深度学习算法,随后转向NLP与LLM,但如今AI几乎包办了所有编码工作,动力严重下滑。一位做软件工程师的朋友劝他别再浪费时间,去找份普通工作,还说AI是整个软件行业的大隐患。他已经投入大量时间,不想让这些积累白费,于是追问:如果继续学,该走哪条路?怎么才能进步得更快?
这条帖子之所以引发共鸣,是因为它戳中了很多人的真实处境——不是不想学,而是看不清投入的回报。下面从动机、路径和效率三个层面拆解。
动机流失的根源:把「写代码」当成了学习的终点
这位网友的挫败感来自一个隐含假设:学AI的价值等于亲手写出代码。当AI能自动生成代码,这个等式就崩塌了。
但机器学习训练的核心能力从来不是敲代码的速度。理解偏差-方差权衡、判断一个损失函数是否合理、识别数据泄漏、评估模型在分布外数据上的表现——这些判断力无法被自动补全工具替代。AI能写出一段能跑的PyTorch训练循环,却很难替你判断这个实验设计是否回答了你真正想问的问题。
换句话说,编码正在贬值,但问题定义、实验设计和结果解读在升值。把学习重心从「实现」转向「判断」,动力就有了新的落点。
偏差-方差权衡是理解模型泛化能力的核心框架。偏差指模型因假设过于简单而系统性地偏离真实规律(欠拟合),方差指模型对训练数据波动过于敏感导致换一批数据就性能骤降(过拟合)。实践中,正则化、增加数据量、调整模型复杂度都是在两者之间做取舍。会用自动补全工具写出训练代码,并不等于能判断当前模型是欠拟合还是过拟合、该加数据还是该减特征——这类诊断恰恰是AI难以替代的部分。
数据泄漏指训练过程中混入了预测时不可能获得的信息,例如用未来数据预测过去、在划分训练集之前做了全局标准化、或用目标变量的衍生特征做输入。它会让离线指标虚高、上线后断崖式下跌。识别泄漏需要对数据管线和业务时序有清晰认知,是评估模型可信度的基本功。
朋友的建议对不对?拆开来看
朋友说「AI是软件行业的大隐患」,这个判断在部分场景下成立:重复性的CRUD开发、模板化的前端页面、简单的脚本任务,确实在快速被压缩。如果一个人的技能栈只有这些,焦虑是合理的。
但「去找普通工作」这个结论跳过了中间选项。软件工程师这个角色本身在分化:一端是执行型编码,另一端是系统设计、AI集成与效果评估。后者不仅没有被削弱,反而因为AI工具的普及而需求上升——企业需要能判断AI输出对不对、能把模型接进业务流程的人。
据该帖子中朋友的表述,AI对软件行业的冲击是真实的,但把它理解为「整个行业没戏了」,是把结构性变化误读成了全面衰退。
继续学的三条现实路径
路径一:从调包转向评估与可靠性
LLM应用最大的痛点不是能不能跑,而是输出是否可信。学习如何设计评测集、如何做幻觉检测、如何构建回归测试来监控模型行为变化,这类技能在工程团队里极度稀缺。方向具体,且与已有NLP基础直接衔接。
幻觉检测指识别大模型生成内容中看似流畅但与事实或给定上下文不符的部分。常见手段包括:基于检索证据做归因校验(检查每句结论是否有源文档支撑)、用另一个模型做一致性投票、以及规则与分类器结合的事实核查。
回归测试监控模型行为的思路来自传统软件测试:为模型建立一组带预期输出的固定评测集,每次更换提示词、模型版本或检索配置后重跑,观察通过率是否下降。这与传统单元测试的差别在于输出是概率性的,因此通常采用打分阈值、语义相似度或LLM-as-judge等方式判定,并对多次采样结果做统计比较。
路径二:把AI能力嵌进具体业务
纯算法岗位竞争激烈,但懂AI又懂某个垂直领域的人很少。金融风控、医疗文本、法律合同审查、工业质检——这些场景需要有人把模型能力和业务约束对齐。已有的ML/DL积累在这里是壁垒,不是沉没成本。
路径三:做AI工具的使用者与编排者
学习重点从训练模型转向编排模型:多模型路由、RAG系统设计、Agent工作流、成本与延迟优化。这类工作上手快、反馈直接,也更容易在短期内看到成果,对恢复动力有帮助。
RAG(检索增强生成) 指在模型生成回答前,先从外部知识库检索相关片段并注入上下文,从而缓解模型知识过时和幻觉问题。一个RAG系统通常包含文档切分、向量化嵌入、相似度检索、重排序和提示拼装几个环节,每一环的取舍都会影响最终效果。
Agent工作流指让模型在多步任务中自主决定调用哪些工具、按什么顺序执行,并根据中间结果调整后续动作。相比单次问答,它需要处理工具调用格式、状态传递、失败重试和终止条件等问题,成本与延迟控制也随之成为设计重点。多模型路由则是按任务难度或成本预算,把请求分发给不同规模或不同厂商的模型。
如何进步更快:从「学完再做」切到「做中学」
这位网友提到两年都在「学算法」,这本身可能是动力流失的原因之一——长期输入没有输出,成就感无从建立。
更快的路径是选定一个具体的小项目,比如用现有LLM搭一个能解决自己日常问题的工具,在做的过程中遇到卡点再回头补理论。项目驱动学习的反馈周期是几天而不是几个月,动机自然能维持。
另一个提速点是对标输出。把自己的实验记录、评测结果公开写出来,接受外部反馈,比独自刷课程进步快得多,也能积累可被验证的能力凭证。
项目驱动学习的有效性在于它制造了真实的约束与反馈:目标具体、成败可验证、遇到问题时的学习带有明确目的,记忆和理解都更牢固。相比之下,先系统刷完课程再动手,容易陷入「知识很全但不会用」的状态,且长期缺少正反馈会消耗动力。对已有理论基础的人,更合理的做法是先设定一个可在数天内交付的最小可用版本,再围绕暴露出的短板回补理论。
沉没成本的正确算法
「不想让过去的投入白费」是帖子里最真实的一句。但两年学习ML/DL留下的不是代码量,而是对模型行为的基本直觉——这种直觉在任何与AI相关的工作里都能复用。
真正需要警惕的不是AI替代编码,而是把学习定义得太窄。方向调一下,两年的积累就是起点,而不是包袱。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。