压缩的代价:事实幻觉背后的率失真极限
信息论证明:语言模型幻觉有一部分是压缩存储的必然代价,与覆盖率无关。
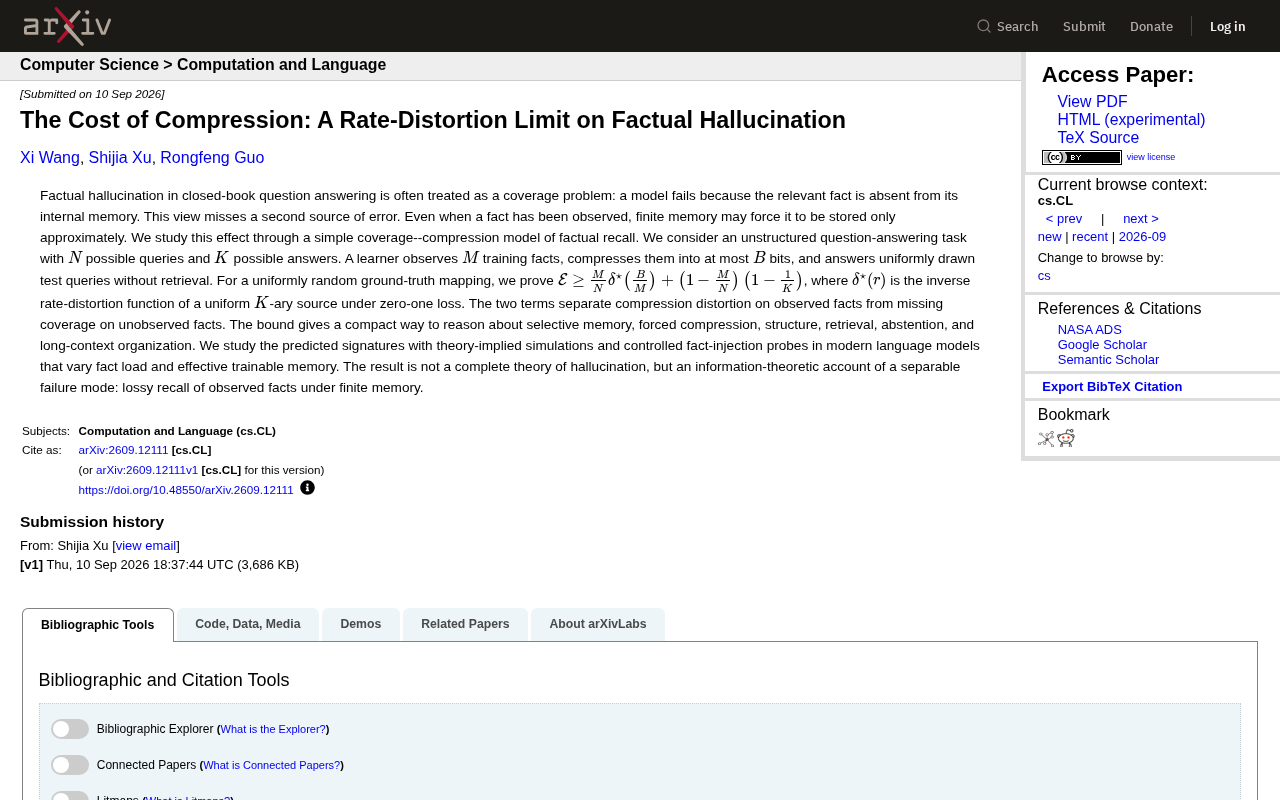
这篇论文用率失真理论为语言模型的事实性幻觉提供了一个新视角:幻觉不只来自"没见过的知识",还来自"见过但存不准"的压缩失真。作者构建了"覆盖—压缩"框架,将错误率下界拆分为两个独立项——压缩失真项与覆盖缺口项,并引入均匀K元信源的逆率失真函数精确刻画前者。当模型的可用比特数 $B$ 固定而需存储的事实数 $M$ 增大时,每条事实分到的比特减少,失真必然上升,这从信息论层面解释了"堆数据未必线性提升准确率"的现象。论文还通过受控事实注入实验验证了压缩失真信号的独立存在,并为RAG、弃答、选择性记忆等实践手段提供了理论支撑。
幻觉不只是"没学过",还可能是"记不清"
大语言模型的事实性幻觉(factual hallucination)长期被视为一个覆盖率问题:模型答错,是因为相关事实根本不在它的内部记忆中。这种解释直觉且常见,但它忽略了另一个更微妙的错误来源。
arXiv 上一篇新论文《The Cost of Compression: A Rate-Distortion Limit on Factual Hallucination》指出,即便一个事实曾经被模型"见过",有限的记忆容量也可能迫使它只能被近似地存储。换句话说,模型不是没学到,而是学到之后被"压缩变形"了。这是一种可分离、可量化的失效模式,作者用信息论的语言给出了它的下界。
覆盖—压缩模型:把幻觉拆成两部分
论文构建了一个极简但有解析意义的框架,称为"覆盖—压缩"(coverage–compression)模型。它把闭卷问答任务抽象成如下设定:
- 总共有 $N$ 个可能的查询(query)
- 每个查询对应 $K$ 个可能的答案(answer)
- 学习者观察到 $M$ 条训练事实
- 这些事实被压缩进至多 $B$ 个比特
- 测试时模型在不借助任何检索(retrieval)的情况下回答均匀抽取的查询
在真实映射为均匀随机的假设下,作者证明了错误率的下界:
$$\mathcal{E} \geq \frac{M}{N}\delta^\star!\left(\frac{B}{M}\right) + \left(1-\frac{M}{N}\right)\left(1-\frac{1}{K}\right)$$
这个不等式的优雅之处在于它把误差干净地拆成了两项。
第一项:观察过的事实上的压缩失真
$\frac{M}{N}\delta^\star(B/M)$ 描述的是模型已经见过、但因记忆受限而存不准确的那部分事实。其中 $\delta^\star(r)$ 是均匀 $K$ 元信源在零一损失下的逆率失真函数(inverse rate-distortion function)。它精确刻画了:当你只有 $B/M$ 比特来存储每条事实时,注定会产生多少失真。这正是把率失真理论(rate-distortion theory)引入幻觉分析的核心贡献——即使数据完美,比特不够也会导致"记忆错乱"。
第二项:未观察事实上的覆盖缺口
$(1-\frac{M}{N})(1-\frac{1}{K})$ 对应传统意义上的覆盖率问题:那些根本没在训练中出现过的事实。模型对它们只能瞎猜,猜中的概率是 $1/K$,因此贡献了 $(1-1/K)$ 的错误率,再乘以未覆盖查询的比例 $(1-M/N)$。
这种分解让"没学过"和"学过但记不清"第一次被明确区分开来。
一个下界能推理出什么
作者强调,这个界限提供了一种紧凑的方式来推理一系列现实中的工程手段与现象:
- 选择性记忆(selective memory):模型可以主动放弃存储低频事实,把有限比特留给高价值信息
- 强制压缩(forced compression):当 $B$ 固定而 $M$ 增大时,每条事实分到的比特下降,失真上升——这解释了为何"喂更多数据"未必线性提升准确率
- 结构(structure):真实世界的事实并非均匀随机,利用结构可以降低有效存储成本
- 检索(retrieval):外部检索相当于绕过内部压缩瓶颈,直接把 $B$ 的限制解除
- 弃答(abstention):模型选择"我不知道"可以避开压缩失真带来的自信错误
- 长上下文组织(long-context organization):如何在上下文窗口中组织信息以减少有效记忆负担
换个角度看,这个下界给了模型设计者一个诊断工具:当准确率上不去时,究竟是覆盖不足(该加数据或加检索),还是压缩失真(该扩容或改结构)?
从理论到实验:事实注入探针
论文并未停留在纯理论。作者用两类方式验证了理论预测的"信号"(signatures):
第一类是理论驱动的模拟(theory-implied simulations),直接在受控假设下检验下界的形状是否与预测吻合。
第二类更贴近实践——在现代语言模型上做"受控事实注入探针"(controlled fact-injection probes)。研究者系统性地改变两个变量:事实负载(fact load,即 $M$)和有效可训练记忆(effective trainable memory,即 $B$)。通过观察错误率随这两个量的变化,验证了压缩失真项确实是一种独立于覆盖率的、可观测的失效模式。
它不是幻觉的完整理论
作者对论文的定位相当克制:这不是一套关于幻觉的完整理论。现实中的幻觉成因复杂,涉及训练动力学、提示词、推理链条、对齐目标等诸多因素,本文只处理了其中一个被清晰隔离出来的机制——有限记忆下对已观察事实的有损回忆(lossy recall)。
但正是这种"隔离"带来了价值。它把一个原本笼统的问题,还原成一个有信息论下界、可测量、可推理的子问题。对于关心模型可靠性的研究者和工程师而言,理解"压缩本身就要付出错误代价"这一点,可能会改变对扩容、检索增强和弃答策略的取舍判断。
对实践的启示
如果压缩失真确实是幻觉的一个独立来源,那么单纯堆参数、堆数据未必是最优解。检索增强生成(RAG)之所以有效,在这个框架下有了更清晰的解释:它把事实存储外置,从根本上避开了内部比特预算的率失真极限。而对于必须依赖参数化记忆的场景,合理利用事实间的结构、优先分配比特给高价值事实、以及在不确定时主动弃答,都成了有理论支撑的降错手段。
这篇论文的意义或许在于:它让我们不再把幻觉当作一个模糊的"模型缺陷",而是当作一个可以用信息论精确记账的成本问题。
相关推荐
MIT衍生公司将塑料废料变身高韧性建筑材料
MIT衍生初创公司Atlas Building Composites将塑料废料转化为高韧性建筑与基础设施部件,探索塑料回收的高价值产业化出路。本文解析其技术路径与产业意义。
CCPS采样法:保留推理多样性,无需微调提升LLM表现
arXiv新论文提出Chopthin-Consensus Power Sampling(CCPS),通过保留推理多样性的重采样与语义多数选择机制,在不进行任何训练的情况下提升大语言模型推理准确率,最高绝对增益达10.6个百分点。
HardFlow算法:让生成式AI满足安全关键场景的硬约束
HardFlow是一种新算法,旨在让生成式AI在安全关键场景中严格遵守硬约束条件,同时保持高质量输出。本文解析其核心思路、技术难点与在机器人、工程设计等领域的应用前景。