厌倦了AI腔调:大模型千篇一律的语气从何而来
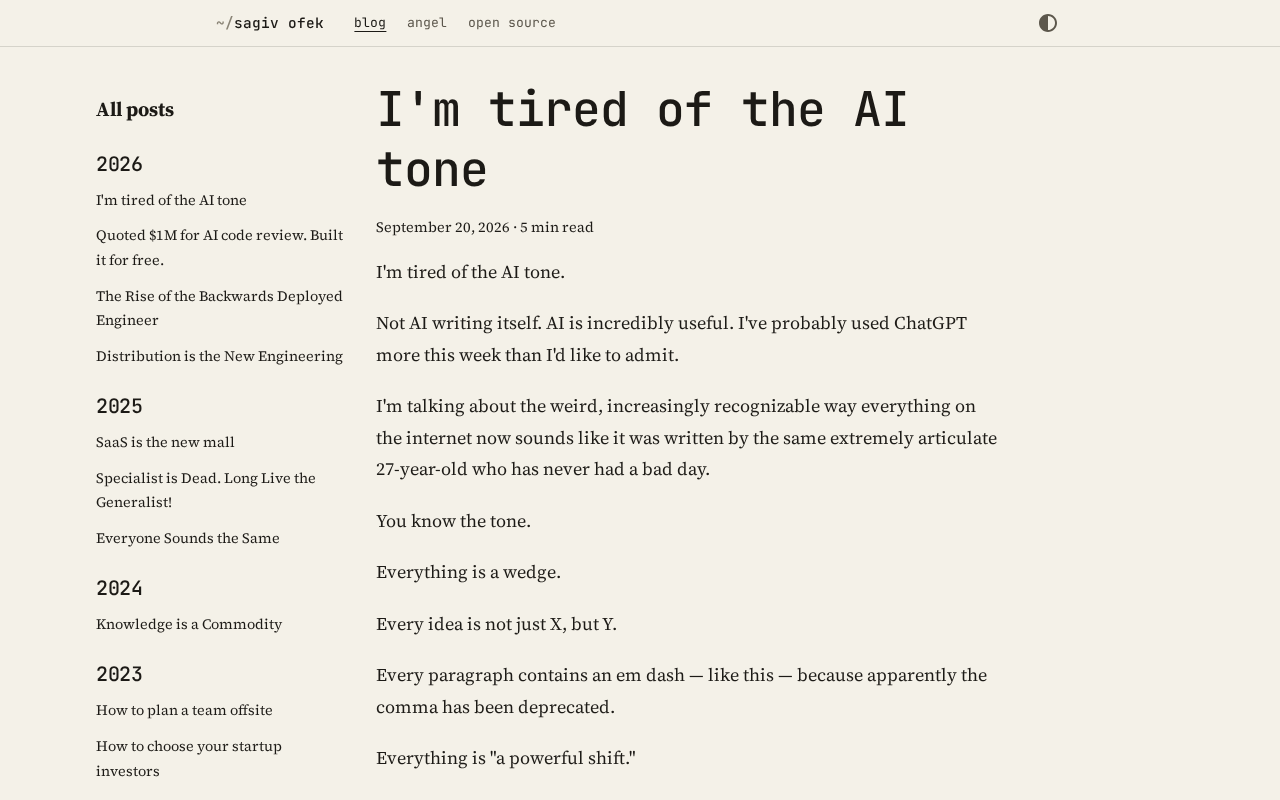
AI腔调源于RLHF对齐训练,正让公共写作趋于同质化,但用户可通过提示词和微调加以缓解。
大语言模型普遍呈现出一种可辨识的"AI腔调"——过度热情的开场、僵硬的分点结构与反复出现的套话短语。这种同质化并非偶然,而是RLHF对齐训练的直接产物:模型被优化为输出最安全、最讨平均标注员喜欢的表达,久而久之形成了一套固定的语言模板。随着AI生成内容渗透进写作的方方面面,公共语言正在向一个"中间地带"收敛,个性与多样性随之稀释,文本的可信度也随之打折。好消息是,通过在提示词中明确限定语气、提供风格样例、要求多轮改写,乃至对模型进行微调,用户已能在相当程度上减轻这种"AI味"。厂商端也开始重视语气可调节性,个性化表达正成为下一阶段的竞争方向。
当所有AI都开始用同一种语气说话
如果你频繁使用ChatGPT、Claude或其他大语言模型,很可能已经患上了一种"审美疲劳"——无论问什么问题,得到的回答总带着一种熟悉的、可预测的腔调。热情洋溢的开场白、结构工整的分点罗列、礼貌到近乎讨好的措辞,以及那句永远绕不开的"有意思的是"。这种被越来越多用户吐槽的"AI腔调"(AI Tone),正成为大模型体验中一个绕不开的话题。
Hacker News上一篇题为《I'm Tired of the AI Tone》的讨论引发了共鸣。尽管原帖篇幅不长,但它触碰到了一个真实存在的痛点:当生成式AI逐渐渗透进邮件、文档、客服甚至社交媒体,这种同质化的语气正在悄然改变我们阅读和写作的习惯。
什么是"AI腔调"
所谓AI腔调,并不是指某个具体的错误,而是一整套可辨识的语言模式的集合。它通常表现为几个特征。
过度的热情与礼貌
AI回答往往以"这是一个很棒的问题!"或"我很乐意帮你"开头,结尾则常常附上"如果你还有其他问题,随时告诉我"。这种一致的友好在单次对话中或许令人愉悦,但当它出现在每一次交互中时,就显得机械而空洞。
结构化到僵硬的表达
大模型偏爱分点、加粗关键词、使用小标题。这种结构确实有助于信息传递,但也让所有内容读起来像同一份模板。真正的人类写作会根据语境调整节奏,而AI则倾向于把一切都塞进整齐的框架里。
泛滥的套话
"有意思的是""说到底""在当今快速变化的世界中"——这些短语几乎成了AI文本的指纹。它们本身没有错,但高频重复让文字失去了个性。
这种腔调是怎么形成的
AI腔调并非偶然,而是训练机制的直接产物。
主流大模型在预训练之后会经过一个关键阶段——基于人类反馈的强化学习(RLHF)。在这一过程中,标注人员会对模型的回答进行打分,倾向于选择那些礼貌、安全、结构清晰的输出。日积月累,模型学会了用最不容易"出错"的方式说话:多用免责声明、避免过于武断、保持热情友好。
这套优化目标带来的副作用,就是语气的高度同质化。模型不是在追求"有个性的表达",而是在追求"平均意义上最讨人喜欢的表达"。当所有厂商都采用相似的对齐策略时,不同产品之间的语气差异也随之被抹平。
此外,训练数据本身也起了作用。大量的网络文本、客服对话、教程文档塑造了模型对"正式"和"有帮助"的理解,而这些语料往往就带有那种标准化的商务腔调。
RLHF(基于人类反馈的强化学习,Reinforcement Learning from Human Feedback)的具体流程值得进一步说明。在这一训练阶段,研究人员首先让模型针对同一问题生成多个不同回答,再由人工标注员对这些回答进行两两比较和排序。基于标注结果,系统训练出一个"奖励模型"(Reward Model),用以预测哪种输出更受人类青睐。随后,原始语言模型通过强化学习算法(通常是PPO)不断调整参数,使自己的输出向奖励模型认可的方向靠拢。这一机制的关键问题在于:标注员的偏好本身就存在系统性偏差——他们往往对礼貌、结构清晰、回避风险的回答打分更高,而对简洁有力但可能显得"态度强硬"的回答心存疑虑。模型最终学到的,是如何取悦评分者的平均口味,而非如何真正有效地沟通。
为什么这件事值得认真对待
有人会说,语气不过是小事,只要内容正确就够了。但AI腔调的蔓延带来的影响比表面更深。
当越来越多的文本由AI生成或润色,公共写作正在向一个统一的"中间地带"收敛。个人博客、产品文案、学术摘要开始读起来像是出自同一支笔。这种同质化不仅让阅读变得乏味,也可能稀释语言表达的多样性——而多样性恰恰是人类沟通中最有价值的部分。
更实际的问题是可信度。当读者一眼就能认出"这是AI写的",文本的说服力和真诚感会打折扣。对于依赖内容建立信任的创作者和企业来说,摆脱可识别的AI腔调已经成为一种刚需。
如何减轻AI腔调
虽然腔调根植于模型训练,但用户端仍有不少办法加以缓解。
最直接的方式是在提示词中明确要求。告诉模型"用简洁直白的语气""不要用分点""避免套话和免责声明",往往能显著改变输出风格。给出具体的写作样例、指定目标读者、限定字数,都能引导模型跳出默认模板。
更进一步,可以要求模型模仿特定作者或风格,或者让它先生成初稿再进行多轮改写去除AI痕迹。对于追求个性化的场景,微调(fine-tuning)自己的专属模型也是一条路径,尽管成本更高。
从行业角度看,一些厂商已经意识到这个问题,开始提供可调节的"语气"或"人格"选项。未来的模型或许能在保持有用性的同时,展现出更丰富、更自然的表达方式。
微调(fine-tuning)是一种在预训练大模型基础上、用特定数据集继续训练以定制模型行为的技术。对于希望打造品牌专属语气的企业或创作者,这条路径意味着收集能代表目标风格的文本样本(如公司历史文案、特定作者的文章集),然后以此对模型进行有监督的额外训练,使模型"记住"这种风格偏好。相比纯靠提示词引导,微调的效果更稳定、更省token,但代价是需要一定量的高质量样本数据、计算资源以及技术门槛。目前,OpenAI、Anthropic等主流平台均提供微调API,使这一方式对中小团队也逐渐变得可行。
结语
《I'm Tired of the AI Tone》之所以能引起讨论,是因为它说出了许多人的隐隐不适:我们在享受AI便利的同时,也在不知不觉中被它的语言习惯所同化。AI腔调是对齐优化的产物,短期内难以彻底消失,但通过更聪明的提示、更审慎的使用,以及厂商在个性化上的持续投入,我们仍有机会让机器的表达重新变得多样而生动。毕竟,语言的魅力从来不在于"标准",而在于差异。
相关推荐
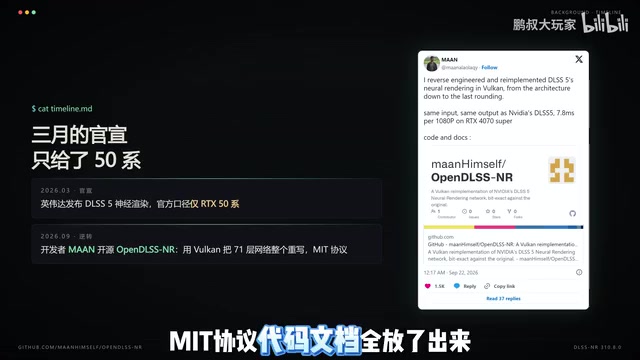
开源复刻DLSS 5:OpenDLSS NR让RTX40系甚至浏览器都能跑
开发者MAAN用Vulkan开源复刻英伟达DLSS 5,项目OpenDLSS NR实现逐字节一致的神经渲染网络,RTX40系显卡甚至浏览器都能运行。本文解析复刻精度、性能数据与落地门槛。
168人俘虏印加皇帝:卡哈马卡伏击战的权力逻辑
1532年皮萨罗率168人在卡哈马卡俘虏印加皇帝阿塔瓦尔帕。本文还原这场悬殊对决背后的征服剧本、心理威慑与擒贼先擒王的权力逻辑。
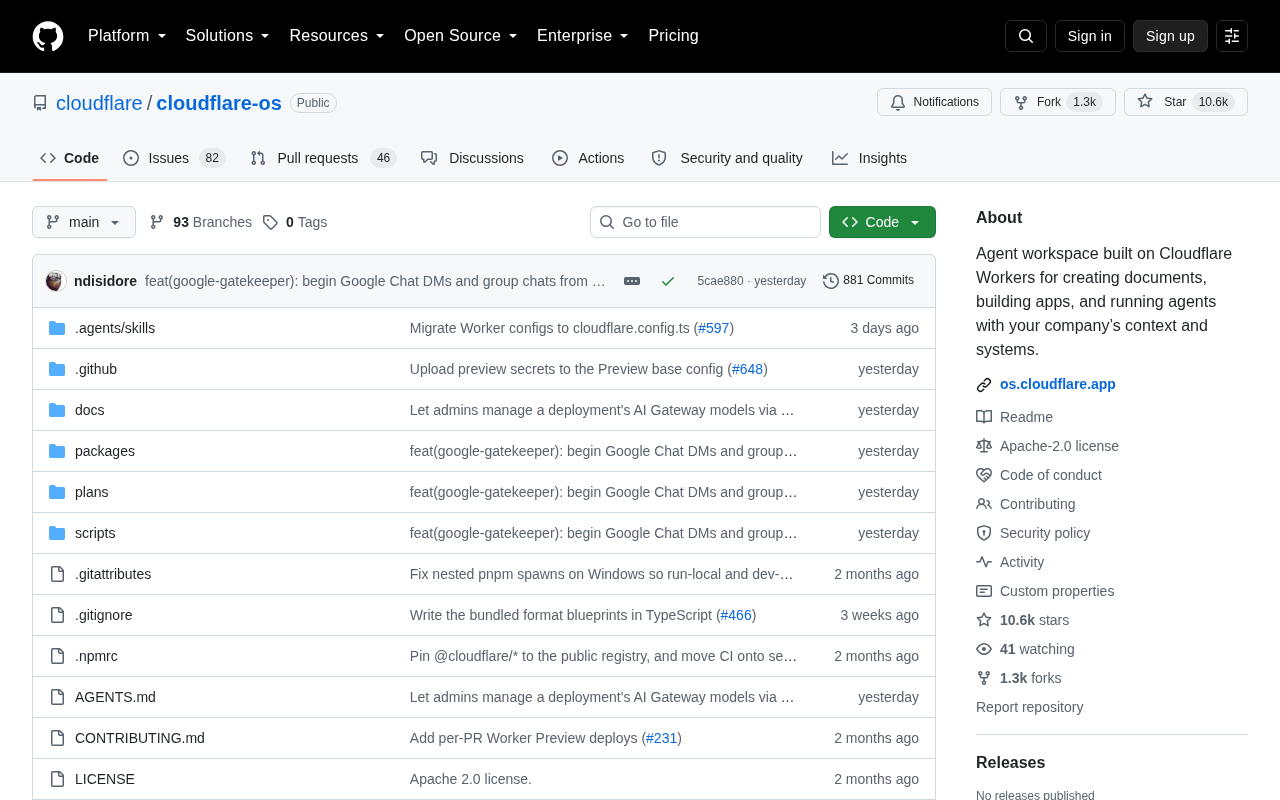
Cloudflare OS:构建在 Workers 上的 AI Agent 工作空间
Cloudflare 开源 cloudflare-os,一套构建在 Workers 上的 AI Agent 工作空间,支持创建文档、构建应用、运行智能体并整合企业上下文与系统。项目已获超 1 万 GitHub 星标,本文解析其定位、技术底座与开发者价值。