一次讲清AI Agent的12个核心原理:从Message到多智能体
拆解AI Agent的12个底层原理,说明Agent本质是简单技术细节的代码拼装。
文章以零门槛方式系统梳理了AI Agent背后的12个核心原理,指出Agent一年多来底层逻辑并无根本变化。内容从交互起点讲起:大模型唯一通道是Message数组,且完全无状态、没有记忆,每次请求都需重新打包历史。接着介绍控制AI行为的提示词工程手段——System Prompt设定角色、思维链提升推理准确率、Few-shot锁定输出格式、预填窗掐掉开头废话、停止序列防止模型自行脑补。随后说明工具调用只是开发者套的协议、RAG本质是开卷考试而非知识注入。最后讲解ReAct循环如何实现自主决策、幻觉为何只能压制无法根除,以及多Agent编排的分工协作模式。结论是Agent并非高深技术,而是简单逻辑用代码拼接成的系统工程。
AI Agent(智能体)的概念被炒得火热,但很多人在技术名词里绕不出来。其实,Agent的底层逻辑在过去一年多并没有根本性变化,那些看似复杂的框架,拆开来看无非是几个基础原理的组合。本文根据B站UP主的系统梳理,用零门槛的方式把这12个核心原理串起来,帮你真正理解AI是怎么替我们干活的。
一、交互的起点:Message数据结构与无状态本质
1. Message:AI唯一的交流通道
我们和AI聊天感觉像有来有回,但大模型底层并没有所谓的“对话通道”。所有交互只走一个通道:Message数组。每次请求并不是只发当前这句话,而是把历史记录打包成一个列表(数组)发过去。大模型做的事类似做阅读理解——读完这一整组消息,推测接着往下写什么最合适。
底层这个数组用JSON格式封装,清楚标明哪句是用户说的(role: user),哪句是AI回复的(role: assistant)。如果发一个空数组过去,大模型不会编出任何一个字。这正是所有Agent最基础的起点。
2. 无状态:AI根本没有记忆
一个颠覆认知的真相是:大模型没有任何记忆,每次请求都是完全清空、重新开始,技术上叫“无状态”。上一秒刚让它写邮件,下一秒说“太长了缩短一点”,在它眼里你都是全新陌生人。
那它怎么知道要缩短什么?是系统在后台做小动作:把上一轮的问题、AI的回复,加上“缩短一点”这句新指令,全部重新打包塞进一个全新的payload一次性发给模型。这个装历史记录的容量就是上下文窗口。窗口太小聊两句就忘,全塞进去又贵又容易“看花眼”,如何平衡是Agent开发的基本功。
二、控制AI行为:System Prompt与提示词工程
3. System Prompt:给AI戴上人设面具
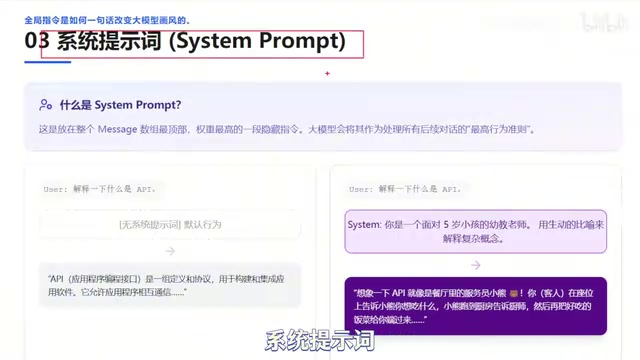
怎么让AI扮演特定角色?靠系统提示词(system prompt)。它写在Message数组最顶部、权限最高,像最高行为准则,让模型处理后续所有对话时都带着这个面具思考。
对比很直观:直接问“解释一下什么是API”,模型给出教科书式定义,枯燥乏味。如果在请求开头塞进一段system prompt——“你是一个面对五岁小孩的幼师,请用生动的比喻解释复杂概念”——同样的问题,画风立刻变成“想象一下API就像餐厅里的服务员小熊”。做客服Agent还是写作助手,这是锁死AI行为风格的第一步。
4. 思维链(CoT):让AI学会打草稿
大模型底层没有计算器,算数学题本质是用概率“瞎蒙”下一个数字,直接问六位数乘七位数几乎必错。但神奇的是,加一句“请一步一步计算”,准确率能飙升到90%以上。
原理在于:模型靠前面的历史对话推测后续内容。当它一步步列出中间推理过程(拆分数字、个位相乘),这些正确的中间步骤就变成了后续预测答案的上下文——它在给自己提供线索。就像人做复杂算术,硬想容易错,拿草稿纸列步骤结果一般不会错。这就是思维链(Chain of Thought,CoT)。
5. 少样本提示(Few-shot):用例子锁死输出格式
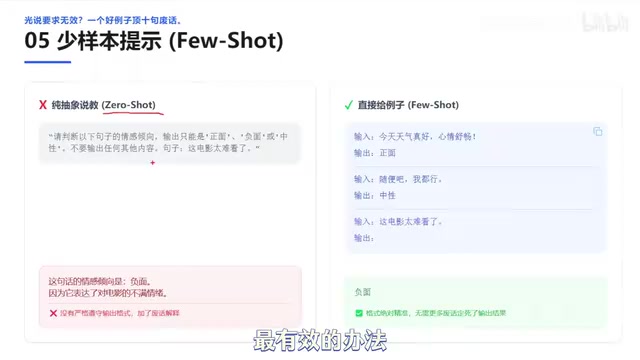
做Agent时常见崩溃场景:要求情绪判断系统只输出“正面/负面/中性”三个词(zero-shot零样本提示),模型却回一大堆解释,在代码里就是bug。讲道理没用,最有效的办法是直接给两三个具体例子:
输入:今天天气真好心情舒畅 → 输出:正面 输入:随便把我都行 → 输出:中性 输入:这电影太难看了 → 输出:(空着)
模型一看瞬间懂了,完全模仿格式只输出“负面”。一个真实例子顶得上十行抽象要求,这就是少样本提示(few-shot)。
6. 预填窗(Pre-fill):掐掉开头的废话
即便用了few-shot,有些模型还是太有礼貌,一开口就是“好的,这是您要的JSON数据”,程序解析直接报错。预填窗的思路很巧妙:在模型开口之前替它把开头写好。想让它返回JSON,就在AI回答的起始位置预填一个左大括号。大括号已经在这儿了,模型没法从头说“好的”,只能顺着语义往下写键值对,最后补上右大括号,输出干净利落,全是可解析的JSON。这个技巧在构建稳定Agent时不可或缺。
7. 停止序列:该闭嘴时立刻闭嘴
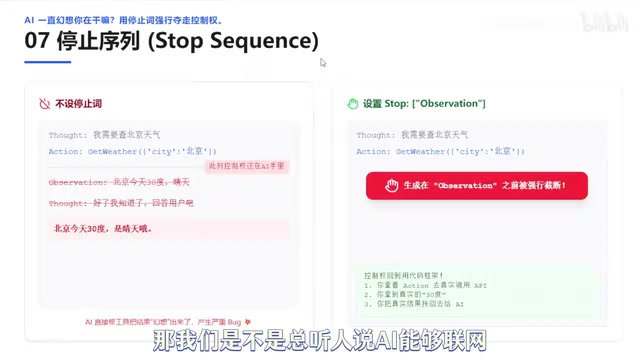
AI脑补能力极强。让它查北京天气,它输出“Action: GetWeather”后如果不喊停,会自己假装成天气工具,顺手写下“Observation: 北京今天晴天30度”——代码还没来得及联网,它已经把结果幻想了,这在Agent系统里是灾难性bug。
解决办法是设置停止序列(stop sequence),比如单词“Observation”:写到这个词必须立刻停,后面一个字不许写。控制权回到代码手里,拿着命令去真实接口查到数据,再把真结果拼进历史对话重新塞给模型。这一收一放的控制权交接,全靠停止序列踩刹车。
三、工具调用与外部知识:Agent的能力边界
8. 工具调用:AI其实不会用任何工具
总听人说AI能联网、查数据库、调用工具,真相是:AI底层既不能上网,也操作不了任何软件,唯一会做的就是根据概率吐字符串。所谓调用工具,是开发者在外面套的一层协议。
完整流程是:模型输出一段JSON格式的调用指令后任务就结束了;Agent框架截获并解析这串JSON,发现它要北京天气,于是后台替它调用真实第三方API;拿到真实数据(30度晴天)后,再拼回给模型,模型才能继续组织语言回复你。工具调用的本质,是让模型输出规范化的调用指令,代码负责执行和回填。
9. RAG:给AI做一场开卷考试
怎么让模型知道公司私有数据(员工手册、报销流程、产品文档)?重新训练太贵。主流方案是RAG(检索增强生成),但它并不是把资料灌进模型脑子里,本质是给AI做开卷考试。
员工问“公司报销额度是多少”,系统不会直接把问题发给模型:程序先到向量数据库里检索,通过关键词或语义匹配找到条款片段(普通员工每月报销额度1000元),再把这段参考材料跟问题拼成全新的长Prompt:“请严格根据以下参考资料回答问题……”模型一看是开卷考试,笃定地回答“根据公司规定是1000元”。它没有记住私有数据,只是在递来的试卷上限读限抄。
四、自主运转:ReAct循环与多智能体编排
10. ReAct:思考、行动、观察的循环
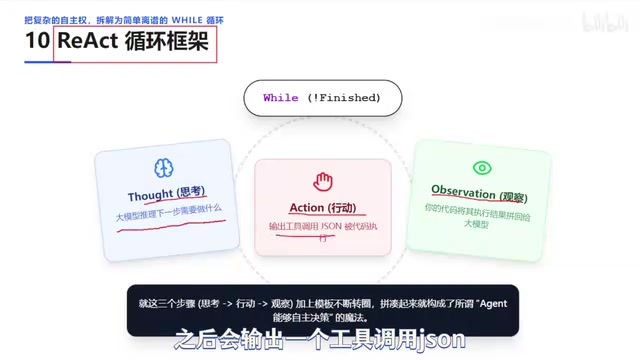
怎么把动作连贯起来让AI自主规划?代码层面只是一个经典的外部循环,模型按模板重复三个动作,即ReAct模式:
- Thought(思考):根据当前问题推理下一步做什么。
- Action(行动):决定后输出工具调用JSON,交给代码真实执行。
- Observation(观察):代码把执行结果拼回给模型,模型据此开始下一轮思考。
任务没完成,while循环就一直转,直到模型在思考阶段判定搞定才退出。所谓Agent的自主决策,本质就是用一个代码结构循环套上“思考-行动-观察”的模板不断转圈。
11. 幻觉:无法消灭,只能压制
循环转圈时最头疼的是幻觉。问“鲁迅和周树人打过架吗”,模型可能一本正经编出“他们曾在上海打过一架”。因为大模型本质是自回归生成机制,脑子里没有“我知道/我不知道”的概念,永远根据前面的字猜测下一个最可能的词,被逼着做文字接龙,自然会编出通顺但错误的内容。
幻觉是底层机制,无法百分百消灭,但可以压制:用RAG检索真实材料,并在系统提示词里严格约束“必须根据给出的事实回答,找不到依据就说不知道”;高风险决策节点上必须加人工核查,不能完全放权。
12. 多Agent编排:包工头与打工人的分工
把单个Agent调教好后,最后一步是让它们群策群力。多Agent编排很像职场分工:设一个“包工头”Agent接收复杂任务(如策划北京旅行),它自己不干具体活,而是拆解分发——查机票交给机票Agent调用航班API,订房间交给酒店Agent查房价,写攻略交给行程Agent组合行程。子Agent完成后汇报,包工头汇总,最后把完整攻略呈现给用户。这种协同让每个Agent专注垂直领域,大幅提升复杂业务系统的稳定性和效率。
写在最后
从最基础的Message数据结构与上下文记忆,到提示词工程(System Prompt、CoT、Few-shot、Pre-fill、停止序列),再到工具调用协议、RAG、ReAct循环和多智能体协同——所谓的AI Agent并不是什么高深技术,本质上是一个个逻辑简单的技术细节,在外部用程序代码拼接起来的系统工程。理解这套底层逻辑,不管你是自己写提示词调教,还是做项目架构,心里都能更有底。
背景补充
Message数组中的每条消息都通过role字段区分说话者,最常见的三种角色是:system(系统提示词,设定AI的行为准则)、user(用户输入)、assistant(AI的历史回复)。在工具调用场景中还会出现tool角色,用来承载外部工具返回的结果。不同厂商的API在字段命名上略有差异(如OpenAI用content,Anthropic支持content blocks),但核心结构一致:一个有序列表,加上每条消息的角色标签。理解这一点很关键——所谓“多轮对话”在模型看来只是这个列表更长而已,并不存在会话对象或连接状态。开发者需要自己维护这个列表的增删与截断,这正是Agent框架要解决的第一件事。
思维链在工程上还有两个延伸值得了解。其一是“零样本CoT”,即不提供示例、仅靠一句“Let's think step by step”就能显著提升推理表现,这说明分步推理能力在大模型中已部分内化。其二是“自洽性(Self-Consistency)”,即对同一问题采样多条不同的推理路径,再对最终答案投票取多数,用采样成本换取准确率。此外,CoT输出会占用上下文窗口,推理步骤越长token消耗越大;在Agent中通常把思考过程放在特定标签内(如<thought>),便于后续解析时与真正的行动指令区分开。
RAG中的“向量数据库”值得展开。文本先经过嵌入模型(embedding model)转换成高维向量,语义相近的文本在向量空间中距离更近。检索时把用户问题也转成向量,做近似最近邻搜索(如余弦相似度),取回最相似的若干片段。实际系统常采用混合检索:关键词检索(BM25)保证专有名词命中,向量检索保证语义召回,两者结果融合排序。检索到的片段还需经过重排(rerank)和截断,因为上下文窗口有限,塞入过多无关材料反而会稀释关键信息、诱发模型“看花眼”。分块策略(chunk size与重叠度)也直接影响召回质量,是RAG调优的主要抓手之一。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。