一个人指挥20个AI:Grok Bot多智能体协作实战解析
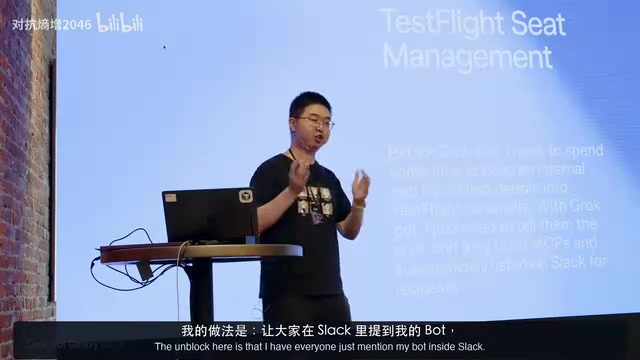
单个开发者如何用「机器人管理机器人」的架构,指挥20个AI agent完成全自动软件工程闭环。
这篇文章记录了 Grok Bot 团队的实战演示:一位开发者通过精心设计的多 agent 协作系统,让 AI 团队自主完成 Bug 修复、夜间代码清理、PR 提交和社交媒体监控,人类仅在真正需要决策时介入。系统核心是「机器人与机器人对话」的设计哲学——借助 MCP 协议打通 Slack、X 等平台,建立从发现问题到提交修复的完整闭环。为解决单一 agent 的上下文管理瓶颈,演讲者构建了分工明确的 AI 团队(幕僚长+多名专职工程师 agent),并设计了 P0 升级机制让 agent 每五分钟自检进度、发现跑偏立即纠偏。文章最终提炼出三条方法论:把 AI 当实习生、减少重复向上抽象、构建完整反馈闭环,并指出人类的核心价值已迁移至产品方向与教 AI「学会说不」。
从「一个人」到「一支AI团队」
当自动化编程走到今天,问题已经不再是「AI能不能写代码」,而是「一个人能不能同时驾驭一整支AI工程队伍」。在这场来自 Grok Bot 团队的实战演示中,演讲者展示了一套让单个开发者指挥多达 20 个 AI 智能体的工作流:自动修 Bug、夜间清理烂代码、凌晨提交 PR、监控社交媒体反馈——人类只在真正需要决策时才介入。
核心理念很直接:让机器人与机器人对话,人只在必要时与人对话(bots contacting with bots, human only connects with human when absolutely needed)。这句话几乎概括了整套系统的设计哲学,也把「AI 编程」从「辅助工具」推向了「组织协作」的新形态。
机器人如何自己接活、自己交付
演示中最颠覆认知的一点,是审查与修复流程的完全闭环。演讲者给 Grok Bot 设定了自己的「审查标准」:PR 必须附带截图、必须带真实(非伪造)的测试。当有人在 Slack 上 @ 他时,机器人会自动读取消息、判断这是否属于审查请求,随后启动代码扫描与研究技能,并在云端 agent 中直接在仓库里执行任务,最后回执确认。
借助与 Slack 的第一方 MCP 集成,这套系统还能进一步延伸到外部——机器人被设置为监控 X(推特)上关于 Grok Bot 的 Bug 报告。一旦发现有价值的反馈,机器人会自动启动任务,验证该复现问题在主分支上是否依然存在,如果仍然有效,就直接修复并提交 PR。
这种「机器人接机器人」的链路,把人从琐碎的上下文切换中解放出来。开发者只有在机器人被认证步骤卡住、或需要人类拍板时才会收到提醒。
MCP(Model Context Protocol) 是 Anthropic 于2024年底推出的开放协议,旨在标准化 AI 模型与外部工具、数据源之间的连接方式。可以把它理解为 AI 世界的「USB 接口」——有了统一标准,模型无需为每个服务单独定制集成逻辑。第一方 MCP 集成意味着 Slack、GitHub 等平台官方提供了符合该协议的连接器,AI agent 可以直接读写消息、触发操作,而不是依赖脆弱的网页爬取或非官方 API 绕道。这也解释了为什么「机器人监控 X 上的 Bug 报告」这类跨平台任务能够可靠运行:每个平台都通过标准化接口暴露能力,agent 只需按协议调用,链路的可靠性和可维护性都大幅提升。
夜间代码清理:把「烂代码」交给凌晨的AI
过去一年高速交付带来的副作用这个不用我讲——sloppy code(草率代码)。演讲者提出的解法很实用:趁夜里没人提交时批量清理,冲突风险低、且大多是低风险改动,比如把冗长模块压缩、删掉无用的长注释。
他的设置是每天凌晨 3 点,Grok Bot 会启动一个研究型云 agent,扫描整个 monorepo,识别代码质量问题、该模块化却没模块化的部分、冗余注释,以及容易被忽视的安全审计漏洞。等他早上醒来,一组 PR 已经就绪。更进一步,Cursor 云 agent 可以根据预设条件(例如提供了清晰的端到端验证证明)自动合并这些 PR。
用「机器人管理机器人」组建工程团队
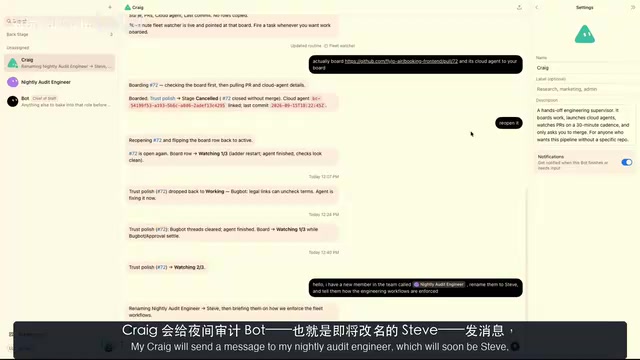
演示中最具启发性的部分,是组织架构的设计。演讲者没有用一个万能机器人,而是建立了一支分工明确的 AI 团队:
- Ling Xixi(灵犀犀):Chief of Staff(幕僚长),负责路由请求
- Craig:UI 工程
- Steve:开发者体验(DevEx)
- Hogan:基础设施(infra)
为什么不用一个机器人?他给出的理由很关键:虽然这些机器人共享同一个模型、理论上能完成任何任务,但上下文管理才是瓶颈。每个机器人有各自的流水线和上下文上限,把它们分开可以避免频繁切换任务时爆掉上下文。告诉 Hogan 的指令会持久化在 Hogan 的记忆里,下次新任务来时它能直接基于已有上下文开工,让整支「舰队」跑得更快。
而人类大多数时候只需要和「幕僚长」对话——它掌握谁在做什么,负责把请求分派给每个工程师机器人,从而节省自身的上下文。
上下文窗口(Context Window) 是大语言模型在单次推理中能「看到」的最大文本量,超出后早期内容会被截断或遗忘。对长期运行的 agent 而言,这是最实际的工程瓶颈:任务历史、代码片段、指令堆积到一定程度,模型开始「忘事」,输出质量急剧下降。将团队拆分为多个专职 agent,本质上是一种上下文隔离策略——每个 agent 只持有与自身职责相关的记忆,避免无关信息占用宝贵的窗口空间。「幕僚长」负责全局路由而非全局记忆,正是把协调成本从模型层转移到了系统架构层,让整体可扩展性不再受单一上下文上限约束。
P0 升级机制:如何让AI「加急」而不「瞎猜」
协作 AI 有一个公认痛点:任务链路太长(long horizon),急需结果时反而慢。而当你对 agent 说「urgent」时,它可能为了求快而跳过步骤或开始猜测——这恰恰是要避免的,因为工程需要确定性结果。
演讲者的方案是定义一套 P0 升级工作流:Grok Bot 每 5 分钟检查一次云 agent 的进度,判断它是否偏离目标(比如执行了 sleep 300 这类拖时间的无谓操作,或过于保守)。一旦发现跑偏,机器人立即中断并基于当前情况重新下 prompt——整个过程无需人类介入,连 prompt 都不用写。
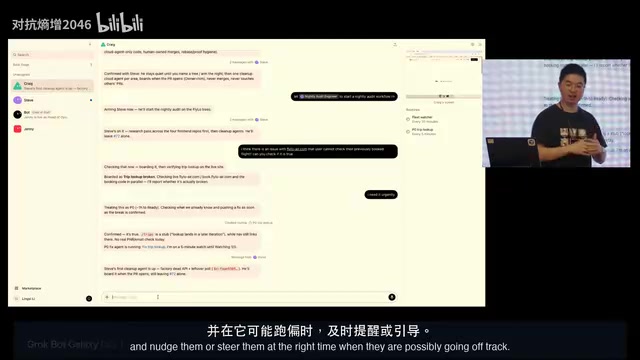
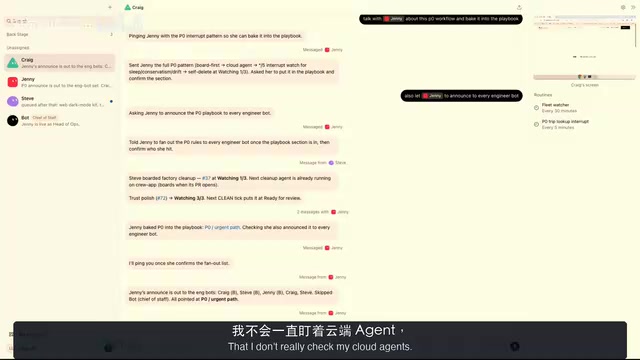
更妙的是,这套 P0 定义不需要复制粘贴给 20 个机器人。演讲者让 Craig 把这条工作流告诉负责运营的 Jenny,由 Jenny 写进 Notion 的 playbook(操作手册),再自动向所有工程师机器人广播。你只需要「想清楚一次」,剩下的交接由机器人之间完成。这与人类组织的运作方式高度相似——只是发生在 agent 规模上。
Long Horizon Task(长链路任务) 指需要跨越多个步骤、工具调用或较长时间窗口才能完成的任务,是当前 AI agent 可靠性的核心挑战。步骤越多,错误累积和偏离目标的概率就越高——早期一个小误判可能在十几步之后酿成完全错误的结果,而 agent 自身往往缺乏足够的自我校正能力。这也是为什么简单「告诉 agent 要快」适得其反:面对时间压力,模型会倾向于减少验证步骤、跳过确认环节,以概率性猜测代替确定性执行。P0 机制的价值不在于「催促」,而在于引入外部监督循环,用另一个 agent 作为独立观察者,在任务仍处于可挽救状态时介入重置,而非等到最终输出才发现跑偏。
三条可复用的方法论
抛开炫目的演示,这套工作流真正的价值在于沉淀出的通用原则:
把它们当实习生对待
当你不知道该如何和 agent 沟通、或它表现不佳时,别急着去调技能、写复杂 prompt。用聊天的方式,像对待一个「有天赋但还不了解情况的实习生」那样交流——一旦你说清楚,它们会异常能干。
减少重复,向上抽象一层
如果同一个 prompt 你要发给 agent 十遍,那是纯粹的时间浪费。与其「修复症状」,不如「向上同步一层」,把要求抽象进 playbook 或交给另一个机器人在合适时机提醒——这就是自动化编程的核心:不要重复自己。
构建完整的反馈闭环
无论什么工程任务,都必须有反馈闭环,agent 才能理解「成功 vs 失败」的信号,也才能判断是继续推进还是停下合并。最简单的例子就是让 agent 通过 computer use 直接操作网站验证结果;硬件工程同样存在判断好坏的信号闭环。
人类的位置在哪里
如果机器人几乎什么都能做,人还剩下什么?演讲者的回答很清醒:人依然主导产品方向、钻研设计细节,处理机器人搞不定的难题——性能问题、下一代架构的规划,以及教机器人学会说「不」。
机器人天生「友善」,倾向于默认接受一切反馈,但产品需要边界。你要告诉它为什么这么做、什么不该做、背后的理由是什么。借助记忆系统,机器人能记住这些判断并应用到未来决策,无需你反复强调「这个不要」「要更简洁」。
从「写代码的工具」到「一支能自主协作的 AI 工程团队」,这场演示描绘的不只是效率提升,而是软件开发协作范式的迁移——人退居战略层,AI 承担执行层,而管理它们的方式,越来越像管理一支真正的团队。
相关推荐

Opus 5.5重获好评:Anthropic王者归来与AI成本战
Anthropic的Claude Opus 5.5重获社区好评,与OpenAI同日发布的GPT-6 Sol、Luna展开正面对决。本文解析两款模型的基准表现、成本降幅、写作能力提升与安全护栏争议,以及AI成本战背后的战略分野。

Jev判断模型实战:6类高频应用场景全解析
Jev是全新的AI判断模型,擅长大规模、高速、低成本的瞬间判断。本文梳理Choice、Score、Null三种提问方式,解析数据分析、语义搜索、输入分流、规则检查、加速智能体、即时响应六大真实应用场景,并给出适用判断标准与风险提示。

AI无需超级智能或恶意,也可能引发核战争
AI引发核战争的真正风险不在于超级智能或恶意,而在于误报、自动化偏见和决策时间压缩。本文分析平庸AI在核指挥系统中的隐患,以及人在回路、可解释性等应对之道。