一个小模型搞定四种中亚语言:EmbeddingGemma多语言嵌入微调实践

小嵌入模型经合成数据微调,统一支持四种中亚语言,检索首位命中率大幅提升。
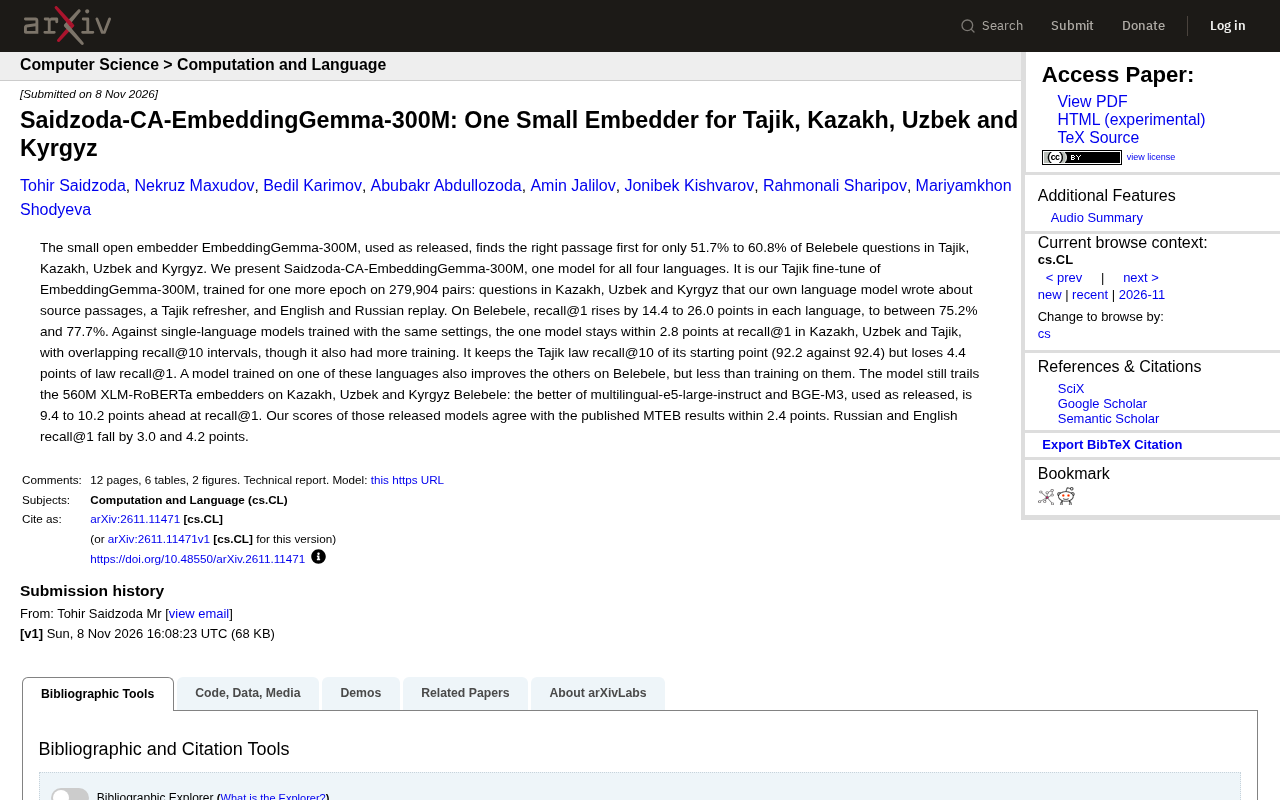
本文介绍 Saidzoda-CA-EmbeddingGemma-300M 的微调工作:在 EmbeddingGemma-300M 基础上,用 279,904 个合成问题-段落对(含哈萨克语、乌兹别克语、吉尔吉斯语新数据,塔吉克语复习数据和英俄回放数据)继续训练一个 epoch,得到一个模型同时服务四种中亚语言。在 Belebele 数据集上,四种语言的 recall@1 从 51.7%-60.8% 提升至 75.2%-77.7%,涨幅 14.4 至 26.0 个百分点。统一模型与单语言模型在哈、乌、塔三语上 recall@1 差距不超过 2.8 个百分点,但塔吉克语法律 recall@1 下降 4.4 个百分点。与 560M 级 XLM-RoBERTa 嵌入模型相比仍有 9.4-10.2 个百分点的 recall@1 差距,且英语、俄语能力分别回退 4.2 和 3.0 个百分点。
小嵌入模型的中亚语言困境
EmbeddingGemma-300M 是一个开源的小型嵌入模型,在英文等主流语言上表现不错。但如果我们直接拿它来检索塔吉克语、哈萨克语、乌兹别克语和吉尔吉斯语,效果就有点不够看了。据原发布数据,在 Belebele 阅读理解数据集上,未经微调的 EmbeddingGemma-300M 对四种语言的问题,只有 51.7% 到 60.8% 的概率能把正确段落排在第一(recall@1)。这意味着,超过四成的问题,用户得往下翻才能找到答案。
对于中亚语言这类低资源语种,这是一个很现实的痛点:通用嵌入模型没有足够的机会去学习这些语言的语义表示。而单独为每种语言训练一个嵌入模型,成本高、维护难,还容易顾此失彼。
嵌入模型(Embedding Model) 是一类将文本映射为稠密向量的神经网络模型,其输出的向量可以用于语义检索、聚类、分类等下游任务。在检索场景中,系统通常先用嵌入模型将问题和候选段落分别编码为向量,再通过向量相似度(如余弦相似度)排序,返回最相关的段落。EmbeddingGemma-300M 是 Google 发布的小型开源嵌入模型,参数量约 3 亿,支持多语言但训练数据以高资源语言为主。recall@1 是检索评估指标,指正确段落排在第一位的结果所占比例;recall@10 则指正确段落出现在前 10 位的结果比例。低资源语言(如塔吉克语、哈萨克语等)因缺乏大规模语料,通用嵌入模型难以学到充分的语义表示,这是本文微调工作的出发点。
一个模型,四种语言:Saidzoda 的微调策略
这项工作的核心思路是:在已有的塔吉克语微调模型基础上,再训练一个 epoch,用合成的多语言数据把哈萨克语、乌兹别克语和吉尔吉斯语“拉”进来。训练集包含 279,904 个问题-段落对,其构成相当讲究:
- 哈萨克语、乌兹别克语、吉尔吉斯语的问题,由作者自己的语言模型针对源段落生成;
- 一部分塔吉克语数据作为“复习”,防止灾难性遗忘;
- 英语和俄语数据作为“回放”,维持模型在通用语言上的能力。
最终得到的模型叫 Saidzoda-CA-EmbeddingGemma-300M。它不是四个独立的模型,而是一个模型同时服务四种语言,这在小嵌入模型里是一个比较务实的设计。
灾难性遗忘(Catastrophic Forgetting) 指神经网络在学习新任务或新数据时,急剧丢失先前已学知识的现象。在持续微调嵌入模型时,如果仅用新语言数据训练,模型对原语言(如塔吉克语)的表示能力可能大幅退化。本文的应对策略是在训练集中混入塔吉克语“复习”数据和英语、俄语“回放”数据,使模型在更新参数时仍能见到旧分布的样本,从而缓解遗忘。回放(Replay) 是持续学习中的经典方法,通过保留或重放旧任务样本维持模型在多语言上的均衡表现。此外,文中提到的“合成数据”指用语言模型自动生成的问题-段落对,用于弥补低资源语言标注数据不足的问题。
效果提升:recall@1 跨语言大幅上涨
在 Belebele 数据集上,这个统一模型的提升是显著的。四种语言的 recall@1 各自上涨了 14.4 到 26.0 个百分点,最终落在 75.2% 到 77.7% 之间。也就是说,之前一半多一点的首位命中率,现在接近四分之三。
与“同样设置下单独训练的单一语言模型”相比,这个统一模型在哈萨克语、乌兹别克语和塔吉克语的 recall@1 上差距不超过 2.8 个百分点,recall@10 的置信区间还有重叠。不过作者也坦诚:统一模型用了更多的训练数据(因为它要覆盖四种语言),所以这个对比并非完全公平。但至少说明,多语言联合训练没有明显拖后腿。
Belebele 是一个多语言阅读理解数据集,覆盖 122 种语言,每个问题配有四个候选段落,任务是从中选出与问题最相关的段落。在嵌入检索评估中,通常将问题和候选段落分别编码,计算相似度并排序,用 recall@1 衡量正确段落是否排在首位。Belebele 的题目设计贴近真实阅读场景,且覆盖大量低资源语言,因此常被用于检验多语言嵌入模型的跨语言检索能力。本文使用该数据集评估塔吉克语、哈萨克语、乌兹别克语和吉尔吉斯语四种语言的 recall@1 和 recall@10,以量化微调前后的性能变化。
权衡与短板:塔吉克语法条检索的得与失
统一模型延续了起始模型在塔吉克语法律检索上的 recall@10(92.2 对 92.4,基本持平),但 recall@1 掉了 4.4 个百分点。这是一个值得注意的 trade-off:模型在扩大语言覆盖的同时,对塔吉克语法律文本的精细排序能力有所牺牲。对于法律检索这类高精度场景,可能需要额外的校准或领域适应。
另一个有趣的发现是:用其中一种语言训练出的模型,也能提升其他语言的 Belebele 表现,但提升幅度不如直接训练目标语言。这暗示中亚语言之间存在一定的可迁移性,但还不足以完全替代针对性训练。
对比大模型:仍有差距,但路径清晰
统一模型在哈萨克语、乌兹别克语和吉尔吉斯语的 Belebele 上,仍然落后于 560M 的 XLM-RoBERTa 嵌入模型。具体来说,多语言-e5-large-instruct 和 BGE-M3 中表现更好的那个,在 recall@1 上领先 9.4 到 10.2 个百分点。作者对这两个发布模型的复现分数与已发表的 MTEB 结果误差在 2.4 个百分点以内,说明对比是可靠的。
此外,统一模型在俄语和英语上的 recall@1 分别下降了 3.0 和 4.2 个百分点。这是多语言微调的常见代价——新语言能力提升,原语言能力轻微回退。好在回放数据起到了一定缓冲作用,下降幅度不算剧烈。
XLM-RoBERTa 是 Facebook AI 发布的多语言预训练语言模型,基于 RoBERTa 架构,在 100 种语言的大规模语料上训练,参数量有基础版(约 2.7 亿)和大版(约 5.6 亿)。在嵌入检索场景中,XLM-RoBERTa 常被用作编码器骨干,经对比学习微调后成为多语言嵌入模型。BGE-M3 是智源研究院发布的多语言嵌入模型,支持稠密、稀疏和多向量三种检索模式,参数量约 5.7 亿。multilingual-e5-large-instruct 是微软 E5 系列的多语言指令微调版本,参数量约 5.6 亿。这些模型因参数量更大、多语言训练数据更充分,在低资源语言检索上通常优于 300M 级别的小模型,但部署成本也更高。本文的对比旨在衡量小模型在成本与性能之间的取舍。
对低资源语言嵌入实践的启示
这项工作给低资源语言的检索系统提供了一个可复用的模板:用合成数据生成目标语言的问题-段落对,在已有微调模型上做轻量继续训练,并用回放数据防止遗忘。300M 的模型尺寸意味着部署成本低,适合在资源有限的环境中落地。
当然,它不是一个“全面超越大模型”的方案。在精度敏感的场景,560M 级别的多语言嵌入模型仍是更稳妥的选择。但如果你需要在四种中亚语言上快速获得可用的检索能力,同时控制模型体积和推理成本,Saidzoda-CA-EmbeddingGemma-300M 提供了一个有数据支撑的起点。
后续值得关注的方向包括:如何缩小与 XLM-RoBERTa 嵌入模型的差距,以及如何在扩大语言覆盖的同时保住塔吉克语法律 recall@1 的精度。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。