一台游戏主机搞定三个本地AI场景:代码助手、知识库、批量处理实测
用一台游戏主机本地部署 Strata,跑通代码助手、私有知识库与批量处理三大场景。
文章介绍 B 站 UP 主用一台游戏主机本地部署 Strata 模型,跑通三个高频场景:通过兼容 OpenAI API 的本地接口,VS Code 加 Continue 插件改地址即可获得断网可用的代码助手;将公司文档导入本地知识库,借助 26 万 token 上下文实现整本手册问答;夜间批量处理上百个文件,不受调用次数与限流约束。作者对比云端与本地的数据路径和成本结构,指出本地部署一次投入、第二年起纯赚、速度稳定,代价是 Strata 严格单实例、不适合多人共享,但单人使用足够。
云端AI用起来方便,但数据出了门就由不得自己。B站UP主「Strata本地部署评测4」用一台游戏主机跑通了三个高频场景:断网可用的代码助手、公司内网的私人知识库、以及通宵批量文档处理。这套方案不依赖任何在线服务,唯一让渡的是并发能力——Strata严格单实例运行,一个人用足够。
场景一:断网也能跑的代码助手
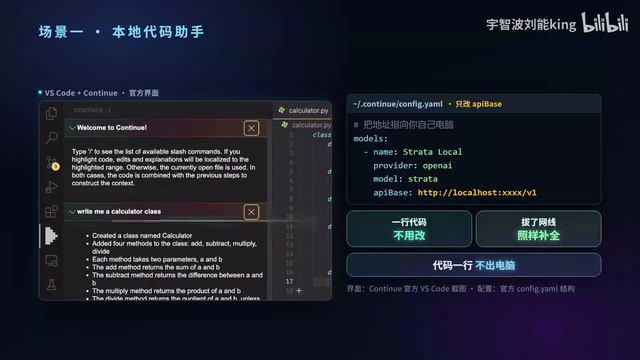
最实用的是本地代码助手。Strata自带一个本地接口,兼容OpenAI API格式。你继续用VS Code加Continue插件,把接口地址改成电脑本地的地址,代码一行不用改,编程助手就从云端变成本地部署。断网状态下照样能用,代码不出你的电脑。
UP主特别点出一个云端方案做不到的优势:模型跑在你自己的机器上,环境和你完全一致。你问它「这段代码能不能跑」,它给出的判断基于真实的本机环境,不会出现「在我电脑上能跑」的尴尬。对于经常在隔离网络或内网环境开发的工程师,这个特性比模型参数更值钱。
OpenAI API 格式已经成为大模型工具链的事实标准:只要服务端暴露 /v1/chat/completions 这类端点并接受相同的请求体结构,任何兼容该格式的客户端都能直接对接。这意味着换模型、换部署位置时,插件、SDK、脚本通常不需要改动代码,只需替换 base_url 和模型名。Continue 就是一类遵循此协议的 VS Code 编程助手插件,它把补全、对话、代码解释等请求发往配置好的端点。Strata 在本地复刻这套接口,等于把自己伪装成一个「OpenAI 服务」,从而无缝接入现有生态——这是本地部署能低成本落地的重要前提。
场景二:公司文档变成可问答的知识库
第二个场景是私人知识库。公司有产品手册、技术文档、内部规章,以前查一个条款要翻半天。把这些文档全部导入本地知识库工具,后端接上Strata,就变成一个「问一句话就能找到答案」的内部知识库。上传文档、建完索引即可使用。
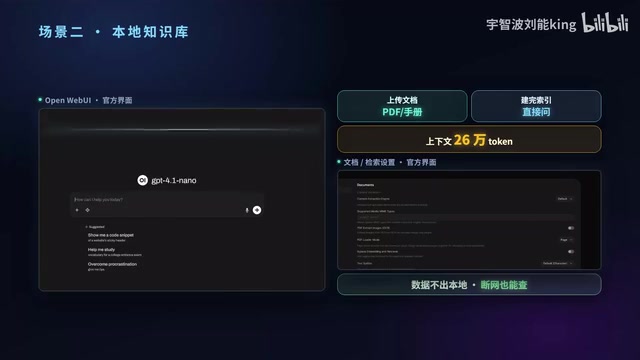
26万token的上下文窗口是关键支撑——整本技术手册可以一次性读完,然后基于手册内容回答客户问题。数据不出本地,断网也能查,适合对信息流转有严格限制的团队。
知识库问答通常走检索增强生成(RAG)路线:先把文档切分成片段,用嵌入模型转成向量存入向量库并建立索引;提问时先检索出最相关的若干片段,再连同问题一起交给大模型组织答案。这里有两个容易混淆的「上下文」概念——检索阶段决定喂给模型哪些材料,而模型的上下文窗口(如文中 26 万 token)决定一次能装下多少材料。窗口越大,越可以少切分、整本送入,减少检索遗漏,但也会推高显存占用和推理时间。数据全程留在本地,正是 RAG 与私有部署结合的核心卖点。
场景三:睡一觉,100个文件处理完
批量任务是本地部署最容易被低估的价值。晚上睡前丢100个文件进去,让它翻译、摘要、提取关键信息,第二天早上直接看结果。没有调用次数限制,没有余额不足,没有「请求过多请稍后再试」。
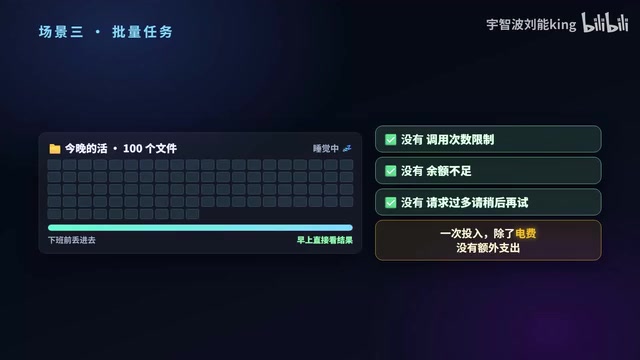
UP主把这类需求单独拎出来,是因为它戳中了云端API的痛点:批量任务在云端往往受限于配额和限流,而本地部署一次投入之后,除了电费没有额外支出。第二年开始纯赚,这是他给出的成本判断。
隐私敏感任务:从「用户」变「主人」
还有一类场景值得单独说:合同审核、财务报表查看、内部会议纪要处理。这些内容不敢直接发给ChatGPT,但在本地环境里可以放心处理,关机即清空。UP主的原话很直白——在云端AI面前你是用户,在本地AI面前你是主人。
云端与本地:两条数据路径的取舍
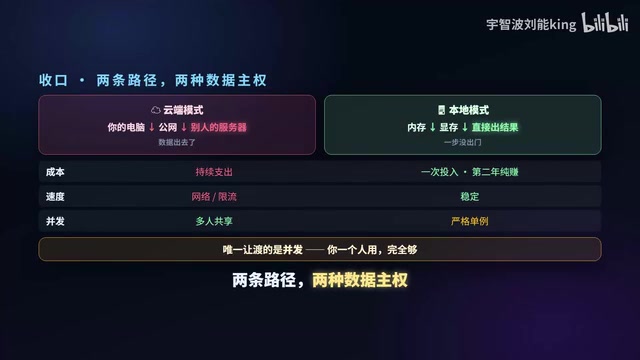
UP主用一张对比图收束三个场景。云端模式下,数据从你的电脑出发,经过网络到达别人的服务器;本地模式下,数据从内存直通显存,直接出结果。两条路径对应两种数据主权。
成本结构上,云端是持续支出,本地是一次投入、第二年开始纯赚。速度上,云端受网络和限流影响,本地稳定。唯一让渡的是并发能力——Strata严格单实例,不适合多人共享,一个人用完全够。
这套方案并非没有门槛,安装和运行过程中会遇到各种坑。UP主表示会在下期一次性填完所有安装与运行的坑,同时向评论区征集大家最需要本地AI解决的场景。正如标题所说,这是抛砖引玉——三个场景跑通只是起点,真正的价值在于大家一起把本地AI的使用边界往外推。
云端 API 的限流通常按每分钟请求数(RPM)和每分钟 token 数(TPM)两个维度约束,批量任务很容易撞上配额天花板,表现为排队、退避重试甚至报错。本地推理没有这类配额,但受限于单机算力:Strata 严格单实例运行,意味着请求只能串行处理,多人同时使用会互相排队。因此本地部署的吞吐上限由显卡的显存带宽和模型规模决定,而不是由服务商的策略决定。理解这一点,才能判断哪些场景适合本地——重隐私、低频次、可离线、单人使用,而非高并发共享服务。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。

Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。