抑制"过度思考"词汇:logit惩罚如何提升Qwen模型准确率

对约50个"过度思考"词施加logit惩罚,Qwen模型数学准确率显著提升且推理更省token。
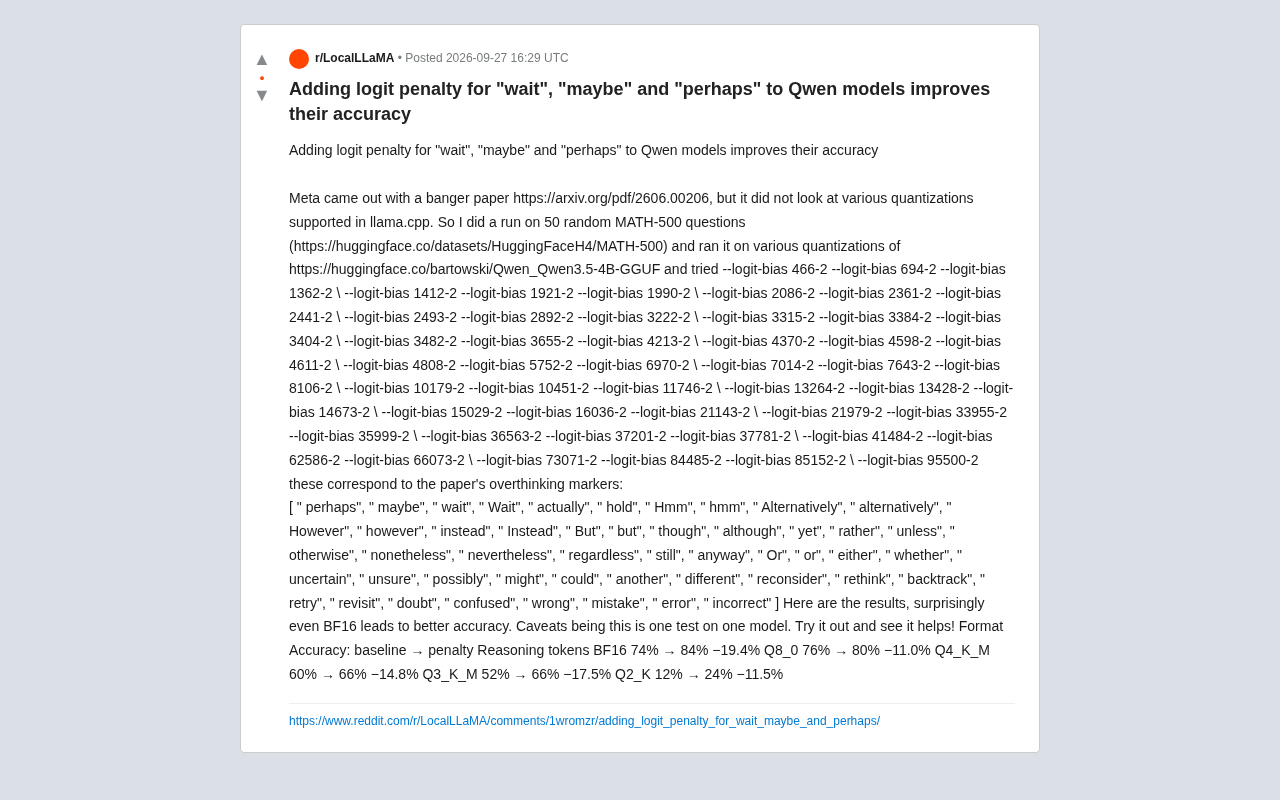
一位研究者受Meta论文启发,在llama.cpp中对"wait""maybe""however"等约50个犹豫、回溯类token施加-2的logit偏置,在MATH-500数据集的50道题上测试Qwen3.5-4B的五种量化精度。结果显示,从全精度BF16到极限压缩的Q2_K,准确率全线提升(BF16从74%升至84%,Q3_K_M从52%升至66%),同时推理token数量下降11%-19%。这表明模型的大量犹豫性推理并未贡献正确答案,反而将自身引入错误路径。该方法无需重新训练,仅在推理时加参数即可实现,对本地部署和算力受限场景尤具吸引力。但实验样本仅50题、单次运行,结论仍属启发性发现,跨模型、跨任务的普适性有待验证。
一个反直觉的发现
大语言模型在推理时经常陷入"过度思考"(overthinking)——反复说"wait"、"maybe"、"perhaps"、"however",不断回溯、质疑自己已经得出的正确答案,最终反而偏离正解。一位 Reddit 用户基于 Meta 的一篇论文(arXiv:2606.00206),做了一个简单却有趣的实验:直接对这些"过度思考标记词"施加 logit 惩罚,结果模型准确率显著提升。
这个思路的核心逻辑很直接:如果这些犹豫、反复、自我怀疑的词汇往往伴随着推理跑偏,那么在解码阶段降低它们出现的概率,或许能让模型更"果断"地走向答案。
实验是怎么做的
实验者从 MATH-500 数据集(HuggingFace 的数学推理评测集)中随机抽取 50 道题目,在 Qwen3.5-4B 的多个量化版本上运行。测试模型来自 bartowski 的 GGUF 量化包,覆盖从全精度 BF16 到极致压缩的 Q2_K 共五种精度。
关键操作是通过 llama.cpp 的 --logit-bias 参数,对约 50 个 token 施加 -2 的偏置。这些 token 对应论文中列出的"过度思考标记词",包括:
- 犹豫类:perhaps、maybe、possibly、might、could
- 停顿/回溯类:wait、Wait、hold、hmm、Hmm、reconsider、rethink、backtrack、retry、revisit
- 转折类:however、But、although、yet、instead、Alternatively
- 自我否定类:wrong、mistake、error、incorrect、doubt、confused、uncertain、unsure
换句话说,就是把这些容易触发"再想想"的词,在生成时的权重人为压低。
Logit 偏置(logit bias) 是大语言模型解码阶段的一种干预手段。模型在每一步生成时,会为词表中所有 token 计算一个原始分数(logit),再经过 softmax 转换成概率分布,最终按概率采样输出。--logit-bias 参数允许用户在 softmax 之前,对指定 token 的 logit 值直接加减一个固定数值。施加 -2 意味着目标 token 的原始分数被压低约 2 个单位,对应概率大约下降到原来的 1/7(e^-2 ≈ 0.135),但不会完全封死该 token 的出现——这与"完全禁止"(设置 -inf)是不同的操作。这种方法无需修改模型权重,只在推理时生效,因此可以随时开关,几乎没有额外计算开销。
GGUF 量化格式是 llama.cpp 项目引入的模型存储规范,通过降低参数的数值精度来压缩模型体积与内存占用:BF16 每个参数占 16 位,Q8_0 约 8 位,Q4_K_M 约 4 位,Q3_K_M 约 3 位,Q2_K 约 2 位。精度越低,推理速度越快、内存越省,但模型表达能力通常随之下降,推理稳定性也更差。
结果:从 BF16 到 Q2_K 全面改善
实验结果颇为出人意料——不仅低精度量化模型受益,连全精度 BF16 都获得了明显的准确率提升。
| 精度格式 | 基线准确率 | 加惩罚后 | 推理 token 变化 |
|---|---|---|---|
| BF16 | 74% | 84% | −19.4% |
| Q8_0 | 76% | 80% | −11.0% |
| Q4_K_M | 60% | 66% | −14.8% |
| Q3_K_M | 52% | 66% | −17.5% |
| Q2_K | 12% | 24% | −11.5% |
两个信号值得关注。其一,准确率普遍上升,其中 Q3_K_M 从 52% 跃升到 66%,提升幅度最大;连原本表现极差的 Q2_K 也从 12% 翻倍到 24%。其二,推理 token 数量全线下降 11% 到 19% 不等——模型不仅答对得更多,还答得更"省",这意味着更短的推理链、更低的推理成本。
这两个指标同向改善,恰好印证了"过度思考"假设:模型在犹豫词上消耗的 token,很多时候并没有带来正确答案,反而把自己绕晕了。
为什么会有效
从机制上理解,推理模型(reasoning model)在训练中学会了用长链条思考来提升表现,但这种能力是把双刃剑。当模型对一个已经正确的中间结论产生"wait, maybe I'm wrong"式的自我怀疑时,它可能推翻正解、走向错误分支。
对这些标记词施加负偏置,相当于给模型的推理过程加了一道"果断性"约束,减少无谓的回溯与反复验证。对量化程度越高、本身推理越不稳定的模型,这种"纠偏"效果往往越明显——因为低精度模型更容易在犹豫中失控。
这里涉及推理模型训练方式的一个深层矛盾。以 DeepSeek广告-R1、Qwen3 系列为代表的推理模型,通常通过强化学习(RLVR)或链式思考监督微调来鼓励模型生成较长的"思考过程"。训练信号会奖励那些最终给出正确答案的轨迹,这无意中让模型学会了用反复验证来"保险"——即使第一次推导已经正确,也倾向于再走一遍验证流程。Meta 的原始论文(arXiv:2606.00206,题目为《Thinking LLMs》)将这类行为归纳为过度思考,发现特定词汇(尤其是回溯类词汇)出现时,后续推理路径出错的概率显著高于基线。从信息论角度看,这些犹豫词触发了模型进入"重新评估"模式,而在数学推理任务中,这种模式对已收敛的中间结果往往弊大于利。
需要保持的谨慎
实验者本人也明确列出了警告(caveat):这只是单个模型、单次测试、50 道题的结果,样本量小,存在随机波动的可能。它更像是一个值得进一步验证的启发性发现,而非可以直接推广到所有模型和任务的定论。
几个尚待厘清的问题:
- 这套惩罚词表针对数学推理任务,在开放式问答、代码生成等场景是否同样有效?
- 过度压制"however""but"这类转折词,会不会在某些确实需要多角度权衡的题目上适得其反?
- 不同模型家族(如非 Qwen 系)的 token 映射不同,惩罚方案需要重新校准。
尽管如此,这个实验的价值在于提供了一种几乎零成本的推理优化手段——不需要重新训练,只需在推理时加几行参数,就有机会榨出额外的准确率。对本地部署、算力受限的场景尤其有吸引力。想验证的用户可以直接在自己的 llama.cpp 环境里复现这套 --logit-bias 配置,看看是否对自己的用例有帮助。
相关推荐

Anthropic新政:辱骂Claude或将面临封号
Anthropic据称将于2026年11月12日推出新政策,对辱骂Claude的行为实施封号。本文分析该政策背后的产品滥用防护、模型对齐与AI福祉等多重动机及其对用户的实际影响。

GPT-6引爆生成式UI后,下一层缺口是生成式工作流
GPT-6 的 Intelligent UI 让生成式 UI 走向主流,但界面之下的执行层同样关键。本文解析"生成式工作流"(Generative Workflow)这一新抽象,以及开源项目 FlowX 如何让智能体技能变成可执行、可编辑、可演化的工作流。

我给四个AI编程智能体各100美元预算:谁能造出PDF编辑器?
一位开发者给四个AI编程智能体各100美元预算,让它们各自构建PDF编辑器。本文分析这场实验的设计巧思,探讨预算约束下AI编程工具的真实交付能力与落地价值。