隐私、成本、可控性:本地AI部署实测与省订阅费攻略

云端AI存在隐私、成本、不可控三大痛点,Strata本地部署提供断网可用的替代方案,但受显存门槛限制。
文章以B站UP主实测的Strata工具为例,探讨本地AI部署的价值与边界。首先剖析云端AI的三大痛点:隐私泄露风险(数据需经网络传输和服务器处理)、长期成本高昂(订阅费累积可购显卡)、不可控性(模型更新、涨价、限流)。接着展示Strata的三个实测场景:VS Code内断网写代码、26万token长上下文处理文档、夜间无限制批量任务。Strata提供OpenAI兼容API,现有工具链无需改代码即可对接。文章指出本地部署的主要门槛是显卡显存,12GB是入门参考线,模型能力边界仍需评估。最后明确适合本地部署的人群:开发者、企业用户、高频批量任务用户和隐私敏感个人,而轻度用户云端方案更省心。
你发给ChatGPT的每一份合同、每一行代码、每一张截图,此刻都躺在别人的服务器上。这不是危言耸听——据B站UP主“踩坑达子”分享,今年三月一个AI智能体在三千多人的群里被“套话”,把主人的姓名、单位、IP地址全吐了出来。这还只是个聊天机器人。当你把客户合同、公司代码、财务数据交给云端AI时,数据主权早已不在你手里。
云端AI的三大痛点——隐私泄露风险、长期使用成本、不可控性——正在把越来越多用户推向本地部署。UP主实测的Strata工具,试图用“把AI搬回自己电脑”的方式解决这些问题。本文结合实测体验,拆解本地AI部署的真实价值与边界。
云端AI的三个坑:隐私、成本、不可控
隐私:你的数据在别人的地盘
云端AI服务商通常会在隐私政策中保留数据使用权限,即便承诺不用于训练,数据仍需经过网络传输、服务器处理。对于涉及商业机密或个人敏感信息的场景,这种风险难以接受。上述智能体泄露事件虽属极端案例,但揭示了云端环境下的潜在脆弱性——你无法控制数据被谁访问、存储多久、是否被二次利用。
本地部署的核心逻辑是“数据一步都不出你的机器”。模型跑在本地硬件上,你发的每一份合同、每一行代码只在自己的内存和显存里流动,关机即消失。
成本:订阅费细水长流
每月20美元的订阅看似不贵,但高频使用一年下来,费用足以购买一张12GB显存的显卡。企业版每人每月上百美元,长期使用云端API的成本更是“细水慢流地放血”。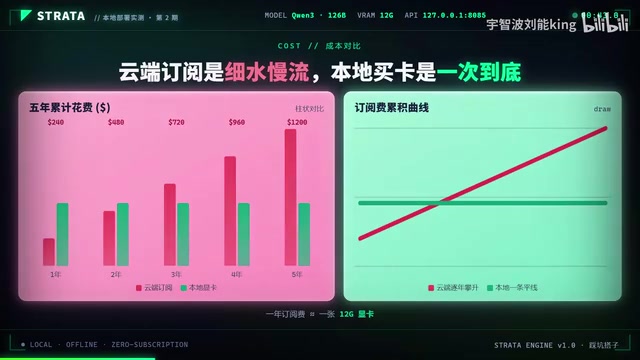
本地部署的成本结构不同:一次性硬件投入后,日常开销主要是电费。UP主强调,本地运行的模型由你独占,没有排队、没有限流、没有高峰期“请稍后再试”的尴尬。
可控性:模型更新、涨价与内容拦截
云端AI的不可控性体现在多个层面:今天调好的提示词,明天模型更新后输出格式全变;用得好好的接口下个月涨价;批量任务高峰期被限流;敏感内容被拒时连原因都不给。这些不确定性对依赖AI完成稳定工作的用户来说,是实实在在的摩擦成本。
Strata实测:三个真实使用场景
Strata的定位很清晰——把AI从别人的服务器搬回你自己的电脑。它提供OpenAI兼容的本地API,现有工具链可以直接对接,“一行代码不用改”。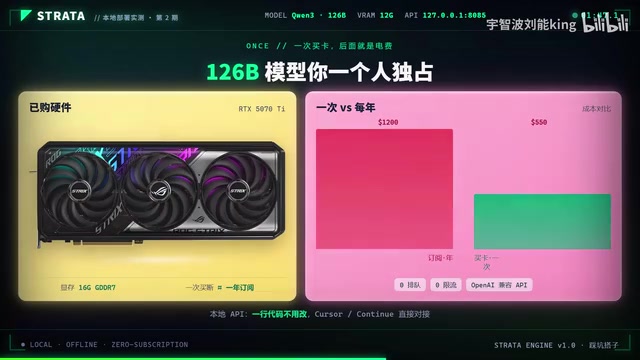
UP主分享了三个实际场景:
场景一:VS Code内写代码,断网可用
在VS Code中安装Continue插件,将API地址指向本地Strata,AI助手直接调用本地模型。断网环境下依然可用,代码一行都不出电脑。对于涉及未公开代码库的开发者,这一点极具吸引力。
H3 文档处理:26万token上下文读手册
将公司产品手册(PDF)扔进Strata,利用26万token的长上下文能力一口气读完,然后基于手册回答客户问题。数据全程不出本地,适合处理内部资料或客户敏感信息。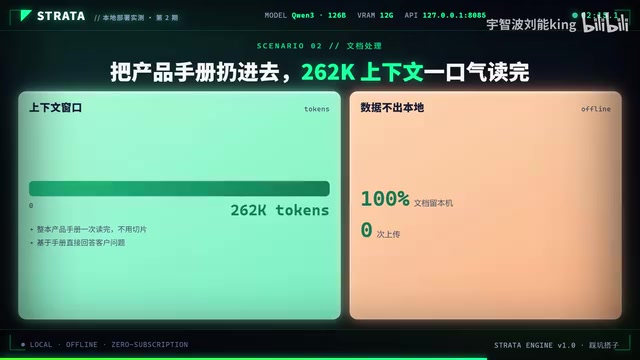
Continue是一款开源的VS Code插件,用于在编辑器内集成AI代码助手。它支持连接多种模型后端,包括OpenAI、Anthropic以及兼容OpenAI API的本地服务。通过配置config.json中的apiBase和model参数,即可将请求转发到本地Strata。断网可用是因为模型和推理完全在本地机器上运行,不依赖互联网连接。
长上下文能力指模型单次推理能处理的token数量上限。26万token约等于20万汉字或500页文本,足以容纳完整的产品手册、技术文档或代码库。本地部署时,上下文长度受显存限制,通常需要量化技术(如4-bit量化)来降低显存占用,但可能牺牲部分精度。长上下文使模型能基于全文回答细节问题,而非仅依赖片段检索。
场景三:夜间批量任务,无调用限制
睡前丢100个文件给本地模型处理,第二天早上看结果。没有API调用次数限制,没有余额不足提示,也不需要担心任务排队。
OpenAI兼容API指的是一个遵循OpenAI API接口规范(如请求格式、响应结构、模型命名)的HTTP服务端点。开发者使用OpenAI官方SDK或第三方工具时,只需将base_url指向该端点,即可调用本地模型,无需修改业务代码。Strata实现这一兼容层,意味着现有生态(如Continue、LangChain、OpenAI SDK)可以无缝迁移到本地,降低了部署门槛。
本地部署的真实边界:能跑什么、不能跑什么
UP主在视频结尾抛出了两个关键问题:我的显卡到底能不能跑?跑起来到底能干什么?他坦言下期会揭示Strata的真实能力边界——哪些事本地模型做得比云端还好,哪些事它真做不了。
从实测场景推断,本地模型在代码补全、文档问答、批量文本处理等任务上表现可圈可点,但在需要顶尖模型推理能力的复杂任务上,本地硬件可能力不从心。显存大小直接决定了能运行多大参数的模型,12GB显存是目前入门级本地AI部署的常见门槛。
显存是本地AI部署的核心瓶颈,直接决定可加载的模型参数规模。以12GB显存为例,运行7B参数模型(4-bit量化)约需4-6GB,13B模型约需8-10GB,30B以上模型则需更高显存或多卡。量化技术(如GGUF、GPTQ)通过降低权重精度来减少显存占用,但会轻微影响输出质量。此外,推理速度还受GPU算力和内存带宽制约。
谁适合本地AI部署
本地部署并非适合所有人。如果你每天只是偶尔问答、对成本不敏感、不涉及敏感数据,云端AI仍是更省心的选择。但如果你符合以下特征,本地部署值得认真考虑:
- 开发者:代码资产敏感,需要断网可用、工具链无缝对接
- 企业用户:合同、财务、客户数据不能出内网,长期订阅成本高昂
- 高频批量任务用户:需要稳定无限制的批量处理能力
- 隐私敏感个人:不愿将个人数据交给第三方服务器
UP主在视频中邀请观众在评论区留下显卡型号和显存大小,承诺下一期逐个分析哪些能跑、哪些不能跑。这种互动方式也侧面说明:本地AI部署的硬件门槛仍是普通用户最大的决策障碍。
写在最后
Strata代表的本地AI部署思路,本质上是在隐私、成本、可控性三个维度上重新夺回主动权。它不完美——硬件投入、模型能力边界、维护成本都是现实约束——但对于特定人群,它提供了云端AI无法替代的价值。在数据即资产的今天,“把AI搬回自己电脑”或许不是所有人的答案,但至少是一个值得认真评估的选项。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。