英国AI安全研究所评估GPT-5.5网络安全能力
英国AI安全研究所评估GPT-5.5网络安全能力
概述
英国AI安全研究所(AI Security Institute, AISI)近日发布了对OpenAI最新模型GPT-5.5网络安全能力的评估报告。此前,该机构已对Anthropic的Claude Mythos进行了类似评估。结果显示,GPT-5.5在发现安全漏洞方面的能力与Claude Mythos相当,但一个关键区别在于:GPT-5.5目前已经面向公众开放使用。
评估背景
AISI的角色与使命
英国AI安全研究所是全球范围内较早系统性评估AI模型安全能力的官方机构之一。其核心工作之一是在前沿AI模型发布前后,对其潜在的危险能力进行评估,特别是在网络安全、生物安全等关键领域。
此次对GPT-5.5的评估延续了AISI此前对Claude Mythos的评估框架,重点关注模型在网络安全攻击场景中的表现——具体而言,是模型发现和利用软件安全漏洞的能力。
评估对象的重要性
GPT-5.5作为OpenAI的最新一代模型,代表了当前大语言模型能力的前沿水平。对其网络安全能力的评估,不仅关乎模型本身的安全治理,也为整个行业提供了重要的参考基准。
核心发现
漏洞发现能力与Claude Mythos相当
评估结果表明,GPT-5.5在安全漏洞发现方面的能力与Anthropic的Claude Mythos处于同一水平。这意味着当前顶级大语言模型在网络安全领域的能力正在趋同——不同厂商的前沿模型在这一特定能力维度上差距不大。
关键差异:公开可用性
然而,两者之间存在一个重要的实际差异。Claude Mythos在评估时尚未全面公开发布,而GPT-5.5目前已经面向普通用户开放。这意味着GPT-5.5的网络安全能力已经处于"野外"状态——任何人都可以访问和使用这些能力。
这一差异对安全治理有着重要影响。一个具备较强漏洞发现能力的模型如果仅限于受控环境中使用,其风险profile与一个已经广泛部署的模型截然不同。
行业影响与思考
对AI安全治理的启示
此次评估凸显了AI安全评估工作的紧迫性。随着模型能力的快速提升,评估机构需要在模型发布之前或发布初期就完成能力评估,以便为政策制定者和公众提供及时的信息。
前沿模型的能力趋同
从GPT-5.5与Claude Mythos能力相当这一结果来看,前沿AI模型在特定能力维度上正在出现趋同现象。这可能意味着,安全治理不能仅针对某一家厂商或某一个模型,而需要建立适用于整个行业的评估标准和治理框架。
双刃剑效应
值得注意的是,AI模型的漏洞发现能力本身是一把双刃剑。在防御方面,这种能力可以帮助安全团队更快地发现和修复系统漏洞;在攻击方面,它也可能被恶意行为者利用来寻找可利用的安全弱点。如何在促进安全研究与防范滥用之间取得平衡,仍是行业面临的核心挑战。
总结
英国AI安全研究所对GPT-5.5的评估为我们提供了一个重要的数据点:当前最先进的公开可用AI模型已经具备了相当水平的网络安全漏洞发现能力。这既是技术进步的体现,也对安全治理提出了新的要求。随着AI能力的持续演进,建立系统性、持续性的评估机制将变得越来越重要。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
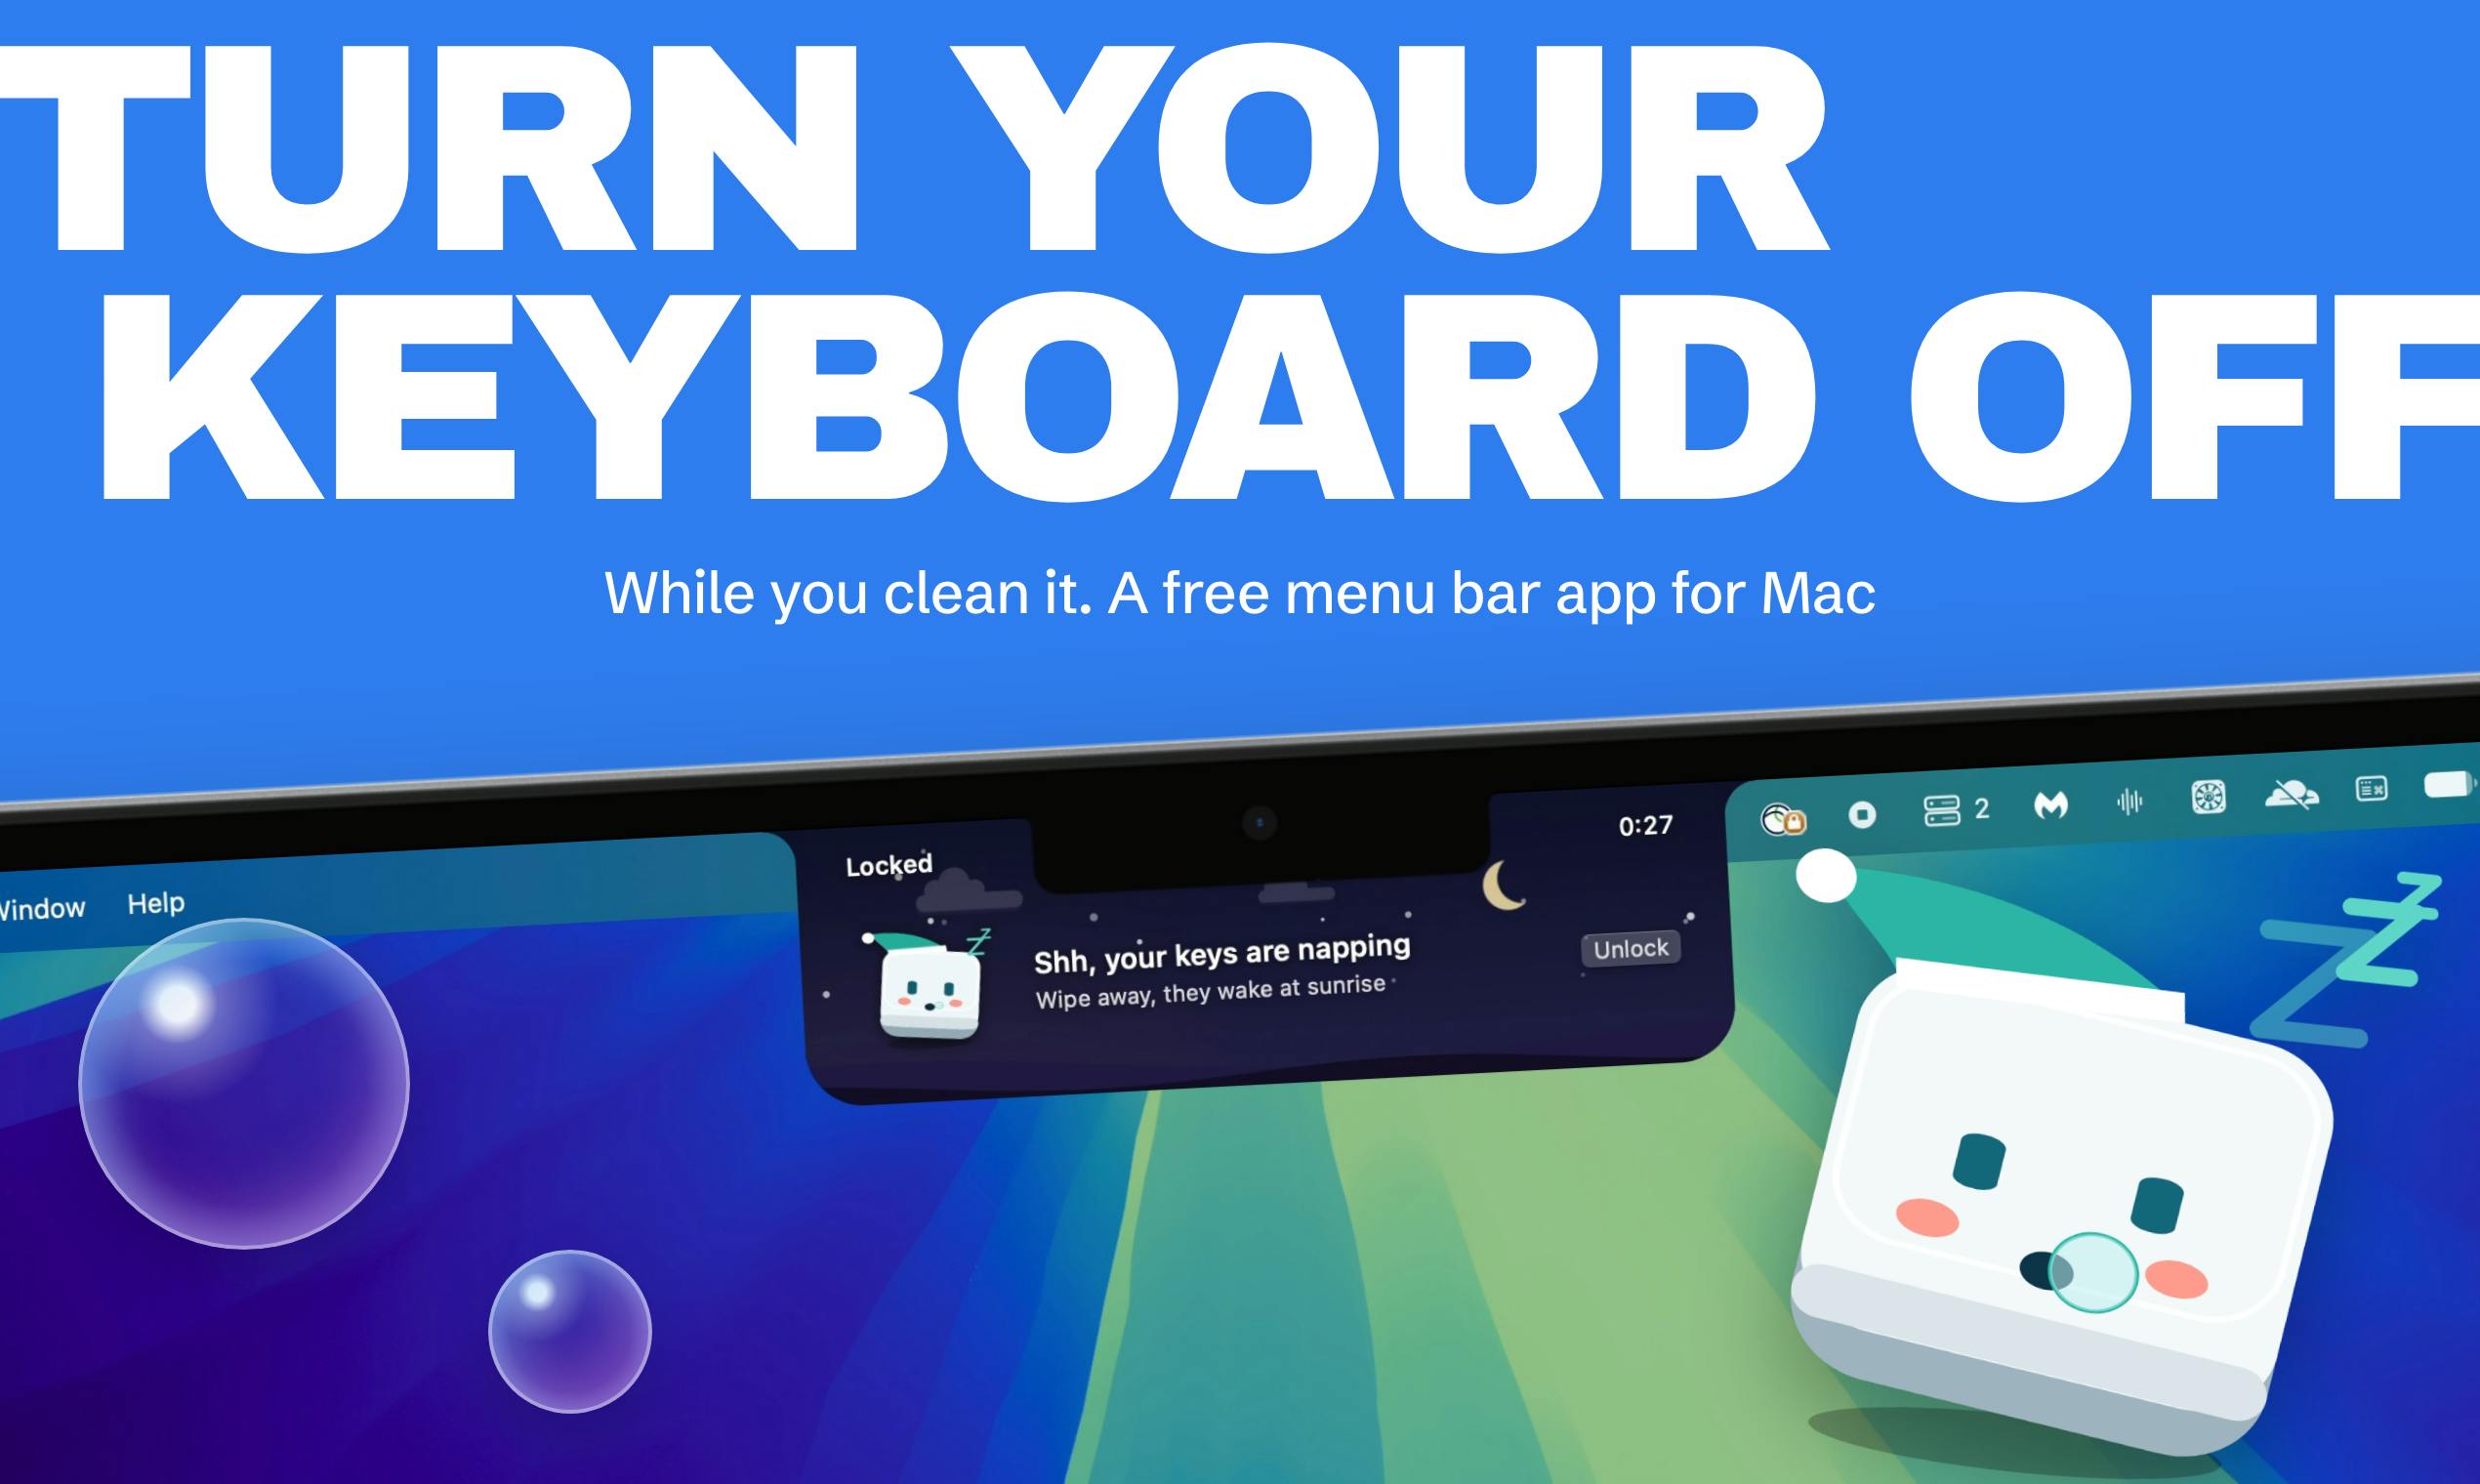
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。