英伟达发布Nemotron 3.5 Bolt E4B:4GB显存跑本地语音助手
英伟达开源基于 Gemma 4 E4B 后训练的 4GB 小模型,瞄准端侧语音与机器人。
英伟达开源 Nemotron 3.5 Bolt E4B 4GB 小语言模型,主打本地设备上的语音助手、游戏角色与机器人应用。该模型并非从零训练,而是在 Gemma 4 E4B 基础上经后训练得到的衍生版本,目标显存占用约 4GB,面向 RTX 显卡和 Jetson 边缘设备。文章指出其核心卖点是能在消费级显卡上为 ASR、TTS 等模块留出空间,并支持离线推理以保障隐私与低延迟。三大落地场景为本地语音代理、游戏 NPC 对话和机器人语音交互。但官方未披露后训练数据规模、微调方法与基准成绩,实际相较基座的提升幅度仍待部署验证。这延续了英伟达以模型加硬件组合巩固边缘 AI 生态的布局逻辑。
英伟达近日开源了一款名为 Nemotron 3.5 Bolt E4B 4GB 的小语言模型,主打在本地设备上运行语音助手、游戏角色和机器人。从命名和参数看,它并非从零训练的新架构,而是在 Gemma 4 E4B 基础上做后训练得到的衍生模型,目标显存占用约 4GB,面向 RTX 显卡和 Jetson 边缘设备。
一款"够小"的模型,瞄准本地推理
小语言模型(SLM)近两年成为端侧 AI 的争夺焦点。云端大模型能力虽强,但延迟、隐私和离线可用性始终是短板。Nemotron 3.5 Bolt E4B 的定位很明确:把推理能力压缩到消费级显卡甚至嵌入式板卡可以承受的范围。
据 MarkTechPost 报道,该模型的核心卖点是"约 4GB VRAM"。这个数字意味着它能在主流 RTX 显卡上留出足够空间给其他任务,也能跑在 Jetson 这类功耗受限的边缘平台上。对于需要在本地实时响应的语音交互场景,显存占用直接决定了能否与语音识别、语音合成模块共存。
值得留意的是"E4B"这一后缀。结合其源自 Gemma 4 E4B 的说明,可以推断该模型沿用了后者的参数规模与架构设计,英伟达的工作集中在后训练阶段——通过指令微调、对话数据对齐等方式,把通用基座调整为适合语音代理和角色扮演的形态。
小语言模型(SLM) 通常指参数量在数十亿级别以下、可在单张消费级显卡或移动/边缘设备上运行的模型。与动辄数百亿参数、依赖多卡云端推理的大语言模型(LLM)相比,SLM 牺牲部分通用知识广度与复杂推理深度,换取低延迟、低功耗、数据不出本机以及离线可用性。端侧 AI 的典型约束是显存与内存带宽:模型权重、KV 缓存和中间激活值都要塞进有限预算内,因此除参数量外,量化精度(如 FP16、INT8、INT4)和上下文长度同样决定能否落地。SLM 常见于语音助手、输入法联想、设备端翻译、工业质检与机器人指令理解等对实时性敏感、隐私要求高的场景。
后训练路线:站在 Gemma 肩膀上
从开源基座模型出发做二次训练,正在成为厂商推出垂直模型的主流路径。这样做的好处是训练成本可控,且能继承基座模型已有的语言能力;代价则是受限于原始架构的上限。
英伟达选择 Gemma 4 E4B 作为起点,说明其看中了该架构在参数量与性能之间的平衡。后训练阶段通常涉及监督微调(SFT)和偏好优化,目标是把模型行为收敛到特定任务分布上。对于语音助手和游戏角色,这意味着更短的回复、更自然的对话轮转,以及对角色设定的遵循能力。
不过,目前公开信息没有披露后训练所用的数据规模、微调方法细节或基准测试成绩。这使得外界难以判断 Nemotron 3.5 Bolt E4B 相较原始 Gemma 4 E4B 的实际提升幅度。对开发者而言,真正的考验要等到实际部署后才能见分晓。
后训练(post-training) 指在预训练基座模型完成后,为使其符合特定任务或人类偏好而进行的第二阶段训练。常见手段包括监督微调(SFT,用指令-回答对教模型遵循格式)、偏好优化(如 RLHF、DPO,让模型输出更符合人类评判)以及蒸馏、拒绝采样等。后训练不改变模型的主体架构与参数规模,因此成本远低于从零预训练,但效果受基座能力上限约束。对于语音代理类应用,后训练常重点优化回复长度、对话轮转自然度和角色人设一致性。另一个关键概念是基座模型授权:衍生模型的发布与商用往往受原始基座许可条款限制,使用前需确认是否允许再分发和商业部署。
三个落地场景:语音、角色、机器人
官方给出的应用方向集中在三类本地交互场景。
本地语音代理是其中最直接的一个。把语言模型部署在本地,语音数据不必上传云端,隐私敏感型应用(如家庭助手、车载语音)会受益。4GB 的显存预算也为同时运行 ASR 和 TTS 模型留出了余地。
游戏角色则对模型的响应速度和角色一致性提出要求。NPC 对话如果依赖云端,网络抖动会破坏沉浸感;本地小模型可以做到确定性延迟,同时通过提示词或微调维持人设。
机器人场景更强调离线可用与低功耗。Jetson 平台本身就是为边缘 AI 设计,模型能跑在 4GB 显存内,意味着机器人可以在无网络环境下完成语音指令理解。
文中提到的 ASR(自动语音识别) 与 TTS(文本转语音) 是语音交互链路的两端:ASR 把用户语音转成文本,交给语言模型理解并生成回复,TTS 再把文本合成为语音输出。三者若要在同一设备上并行运行,显存和算力预算需要统一分配,这也是模型显存占用被反复强调的原因。Jetson 是英伟达面向边缘与嵌入式 AI 的计算平台,采用与桌面 GPU 不同的低功耗 SoC 架构,常见于机器人、无人机和工业视觉设备。其显存与桌面显卡共享同一物理内存池,因此“4GB 级”模型在 Jetson 上的可用性还取决于系统与其他进程的占用。KV 缓存则是自回归生成时保存历史上下文键值对的内存开销,随上下文长度线性增长,长对话场景下常成为端侧部署的隐性瓶颈。
端侧小模型竞争加剧
英伟达此举延续了其在边缘 AI 上的布局逻辑:不只卖芯片,也提供能在自家硬件上跑好的模型。Nemotron 系列此前已有多个规格,这次推出 4GB 级别的 Bolt 版本,进一步下探到资源受限设备。
对开发者来说,选择变多了,但评估成本也相应上升。小模型之间的差异往往体现在具体任务上——同一个模型在语音指令理解上表现良好,换到多轮角色扮演可能就力不从心。建议在选型时围绕自己的实际场景做小规模对比测试,而不是只看参数和显存数字。
目前该模型已以开源形式发布,具体许可条款和权重获取方式需参考官方仓库说明。
相关推荐
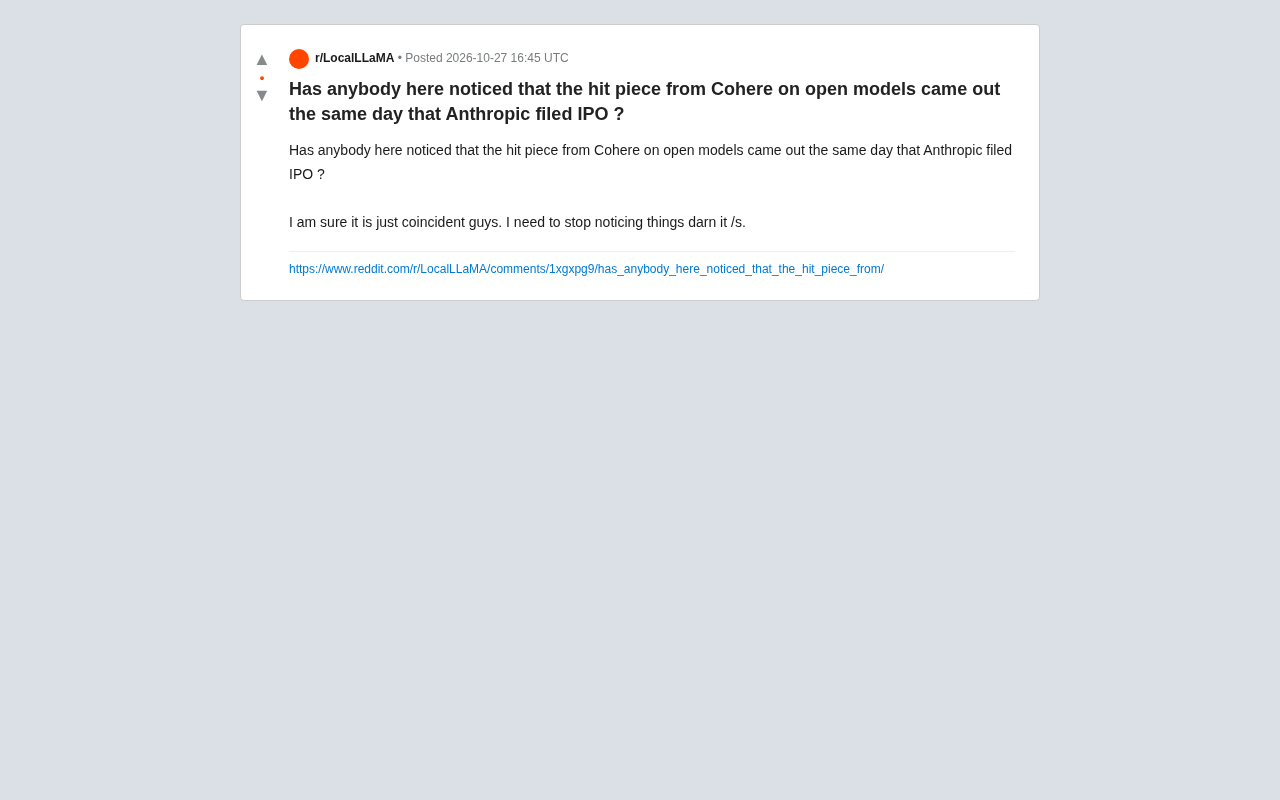
Cohere质疑开源模型与Anthropic IPO同日:巧合还是策略?
Reddit用户发现Cohere批评开源模型的文章与Anthropic提交IPO在同一天发布,引发社区对闭源厂商公共言论商业动机的讨论。本文分析这一时间巧合背后的开源与闭源之争,以及社区反应揭示的信任问题。
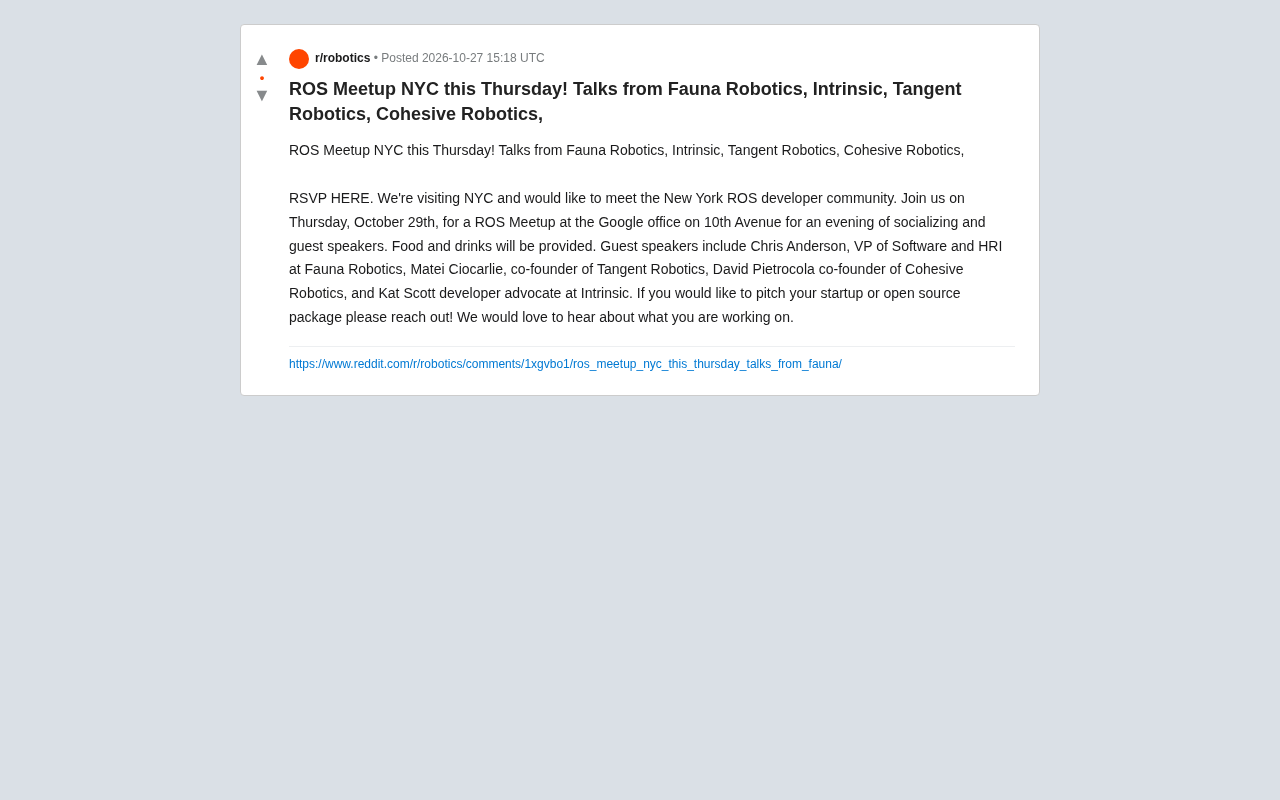
纽约ROS开发者聚会:四家机器人公司演讲
纽约ROS开发者聚会将于周四在谷歌办公室举行,Fauna Robotics、Intrinsic、Tangent Robotics、Cohesive Robotics等公司代表将发表演讲,活动免费并提供餐饮,开放报名与演讲征集。
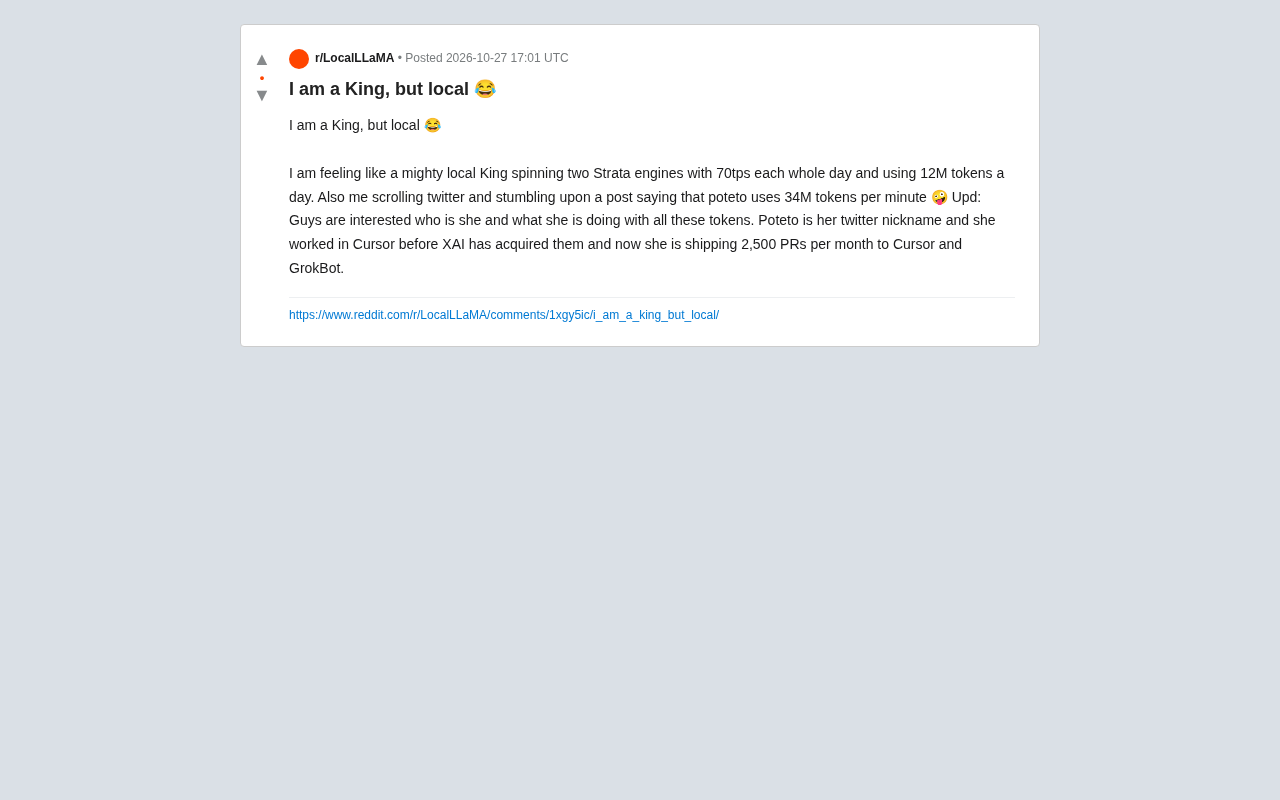
本地AI王者:日耗12M token背后的算力差距与竞争焦虑
Reddit开发者自嘲本地AI王者:日耗12M token,却被每分钟34M token的云端玩家降维打击。文章探讨本地部署与云端自动化的算力差距、token消耗量背后的行业焦虑,以及开发者如何在两种模式间找到平衡。