英伟达开源OpenShell:给AI Agent套上安全笼子
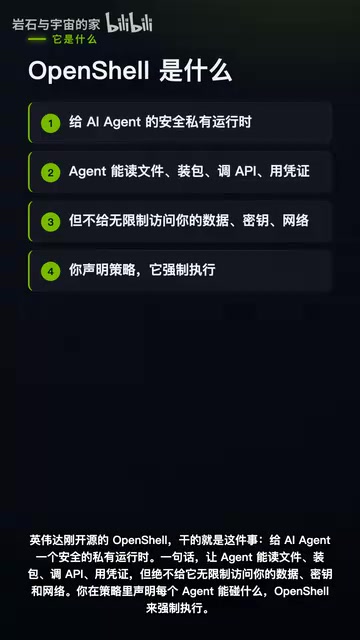
英伟达开源OpenShell,用内核级沙箱与形式化验证管住AI Agent权限。
英伟达在GitHub开源了面向自主AI Agent的运行时安全沙箱OpenShell,回应Agent默认拥有与用户相同机器权限、可能误删数据或泄露密钥的风险。其核心机制有二:一是在内核层限制文件访问与系统调用,每次网络连接先过策略检查,凭证只在请求发往获批端点时注入,Agent始终看不到真实密钥;二是策略变更前用形式化验证推导新增访问路径,高风险变更强制人工审核。项目以Rust编写,采用零信任架构与mTLS加密,隔离驱动覆盖Docker、Podman、Kubernetes与虚拟机,Apache 2.0开源并提供多语言SDK。但部署门槛较高、托管沙箱仅支持Unix、macOS虚拟机驱动不稳定,且仍处0.1.x早期版本。
英伟达在GitHub上开源了OpenShell,一个专门为自主AI Agent设计的运行时安全沙箱。消息在B站等技术社区快速传播,核心痛点很直接:当你让Agent帮忙写代码、跑任务时,它理论上也能删你的数据库、偷API密钥、把公司文件悄悄传出去。OpenShell要做的,就是把这些能力关进一个可策略控制的笼子里。
为什么Agent安全突然成了硬需求
2026年自主Agent已经大面积落地。Codex、Cursor这类编码Agent越普及,"它在我机器上到底干了什么"就越让人不安。传统的权限模型假设操作者是人,而Agent是默认运行、持续决策的程序——它不需要"作恶",一次幻觉或一次越权调用就足以造成事故。问题不在于Agent的意图,而在于它默认拥有和你相同的机器访问权。
这正是OpenShell试图回答的问题:能不能让Agent读文件、装包、调API、用凭证,同时把数据、密钥和网络的访问边界死死卡住。
两大核心机制:内核级强制与形式化验证
沙箱隔离到系统调用层
OpenShell让每个Agent跑在独立沙箱里,在内核层面限制它能访问哪些文件、能发哪些系统调用。每一次网络连接都要先过策略检查,Agent本身无法绕过。这套底座用Rust编写,走零信任路线,mTLS全链路加密,隔离驱动覆盖Docker、Podman、Kubernetes到虚拟机等多种形态。
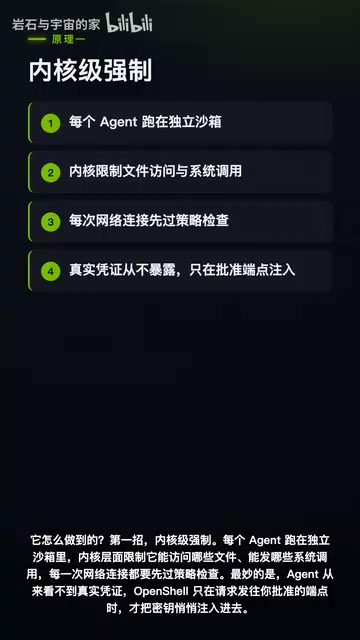
凭证处理是另一个亮点:Agent从来看不到真实密钥。只有当请求发往你批准的端点时,OpenShell才把密钥悄悄注入进去。这意味着即使Agent被诱导泄露凭证,它手里也没有可泄露的东西。
系统调用(syscall) 是用户态程序与操作系统内核交互的唯一入口,文件读写、网络收发、进程创建都要经由它下发。沙箱若只在应用层拦截,Agent 只要绕过 SDK 或换一种调用方式就能逃逸;而在内核层(如 seccomp、eBPF、LSM 等机制)对系统调用做白名单和参数校验,才具备强制力。这也是 OpenShell 强调“内核级强制”的原因:策略由内核执行而非由 Agent 自觉遵守,Agent 即使被提示注入或出现幻觉,也无法逾越已声明的系统调用边界。代价是策略需要针对不同工作负载精细调校,过严会让 Agent 无法正常安装依赖或编译代码。
策略变更先做数学证明
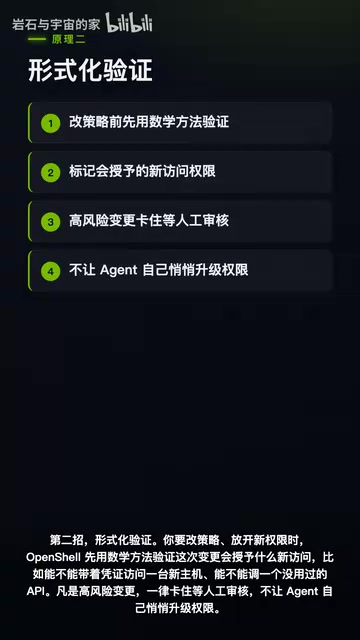
放开新权限是风险最高的动作,OpenShell用形式化验证来处理。当你修改策略时,它会先用数学方法验证这次变更会授予哪些新访问——比如能不能带着凭证访问一台新主机、能不能调用一个没用过的API。凡是高风险变更一律卡住等人工审核,Agent无法自己悄悄给自己升级权限。
形式化验证(formal verification) 是指用数学模型描述系统及其规则,再以定理证明或模型检验的方式,穷举或推导所有可能行为,从而判定某条性质是否恒成立。放在访问控制场景中,它回答的是“这次策略改动是否会引入任何此前不存在的访问路径”这类问题,而不是抽样测试几条用例。相比手工评审 ACL 或 YAML 规则,形式化方法能捕捉到多规则组合后涌现的隐性授权——例如某条新规则与既有凭证注入规则叠加,间接打通了访问新主机的能力。其局限在于需要对策略语言和运行时行为建立足够精确的抽象模型,建模偏差会直接削弱结论的可信度。
零信任(Zero Trust) 的核心主张是“永不信任、始终验证”:不因为请求来自内网、来自本机或来自某个已启动的进程就默认放行,每一次访问都要重新认证与授权。传统边界安全假设内网可信,而 Agent 恰恰运行在这条信任边界之内,因此沿用旧模型等于给它开了后门。OpenShell 采用 mTLS(双向 TLS)让通信双方互相出示证书并校验身份,配合细粒度策略,把“Agent 是否可信”转化为“这一次具体请求是否被策略允许”。这也解释了为何凭证注入必须按目标端点触发:授权粒度落到单次调用,而非一次性授予 Agent 长期通行证。
工程优点与真实门槛
英伟达亲自下场是OpenShell最大的背书。Rust安全底座、零信任、mTLS、Apache 2.0完全开源,Python、TypeScript、Go、Rust全套SDK齐活,还能直接装Agent Skills,让编码Agent自己调用。
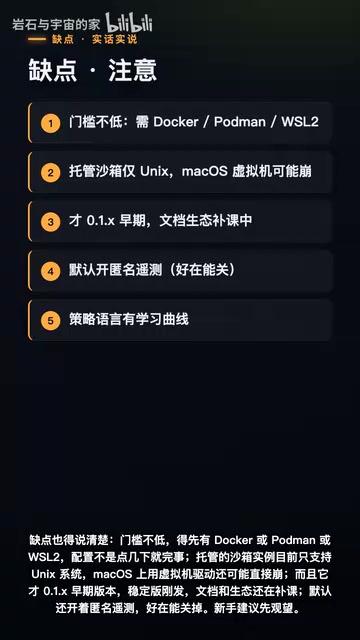
缺点同样明显。部署门槛不低,需要先有Docker、Podman或WSL环境,配置不是点一下就能完成;托管沙箱目前只支持Unix系;在macOS上用虚拟机驱动还可能直接崩。项目处于0.1.x早期版本,稳定版刚发,文档和生态还在补课,默认开启匿名遥测(可关闭)。对新手来说,先观望是合理选择。
英伟达的算盘:从卖算力到控边界
OpenShell一夜冲上热榜,背后是更宏观的卡位。Agent安全是当下最烫的议题,而英伟达此举是从算力供应商向Agent基础设施延伸的信号。未来谁掌控Agent的安全边界,谁就握住了入口。
项目在GitHub上搜索NVIDIA OpenShell即可找到,Apache 2.0开源。想自托管Agent安全的团队,值得上手评估;个人开发者如果只是想尝鲜编码Agent,可以先等文档和生态再成熟一些。
Agent 运行时(agent runtime) 指承载自主 Agent 执行循环的基础设施层,负责工具调用、状态管理、权限控制与资源隔离。它与模型本身正交:同一个模型可以跑在不同运行时上,安全性和可观测性主要由运行时决定。业界正把运行时视为继模型、算力之后的第三个竞争层面,因为它决定了 Agent 能触达哪些数据与系统,也就决定了企业敢把多关键的业务交给它。OpenShell 以 Apache 2.0 开源并适配 Kubernetes 等主流编排形态,实质是试图让这一层成为默认选项,从而在生态入口上占据位置。
相关推荐
用Claude Code写代码,先考了个网管:AI编程的配置之痛
Claude Code被吐槽配置门槛高:看八个教程一行代码没写,先被账号、网络、地区限制绕晕。本文分析AI编程工具的配置之痛、远程Mac mini方案的思路与边界,以及开发者该如何务实选择。
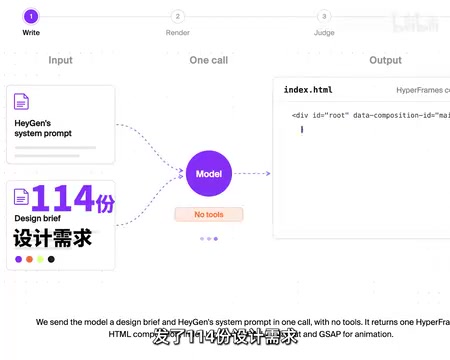
27款模型代码写视频实测:Claude Opus 5.5登顶,性价比之王竟是它
Artificial Analysis 的 Code2Video Benchmark 让27款模型用纯代码写HTML视频,Claude Opus 5.5 以1536分登顶,GPT 6.1 用约十分之一成本排名第四,揭示AI视频生成的审美与性价比之争。

Jev实战:用单次Prefill替代逐token解码的决策模型
拆解Jev推理范式:跳过逐token解码,仅用一次prefill前向传播输出选择、序数评分与布尔判断。对比编码器与解码器两条实现路线,解析多问题掩码设计、重复token陷阱,以及RLCD结合GRPO的概率校准训练方法。