英伟达Minerva:把遥测乱流变成GPU峰值产能

英伟达Minerva将跨GPU与网络遥测归一化关联,把观测数据转化为AI工厂的产能决策信号。
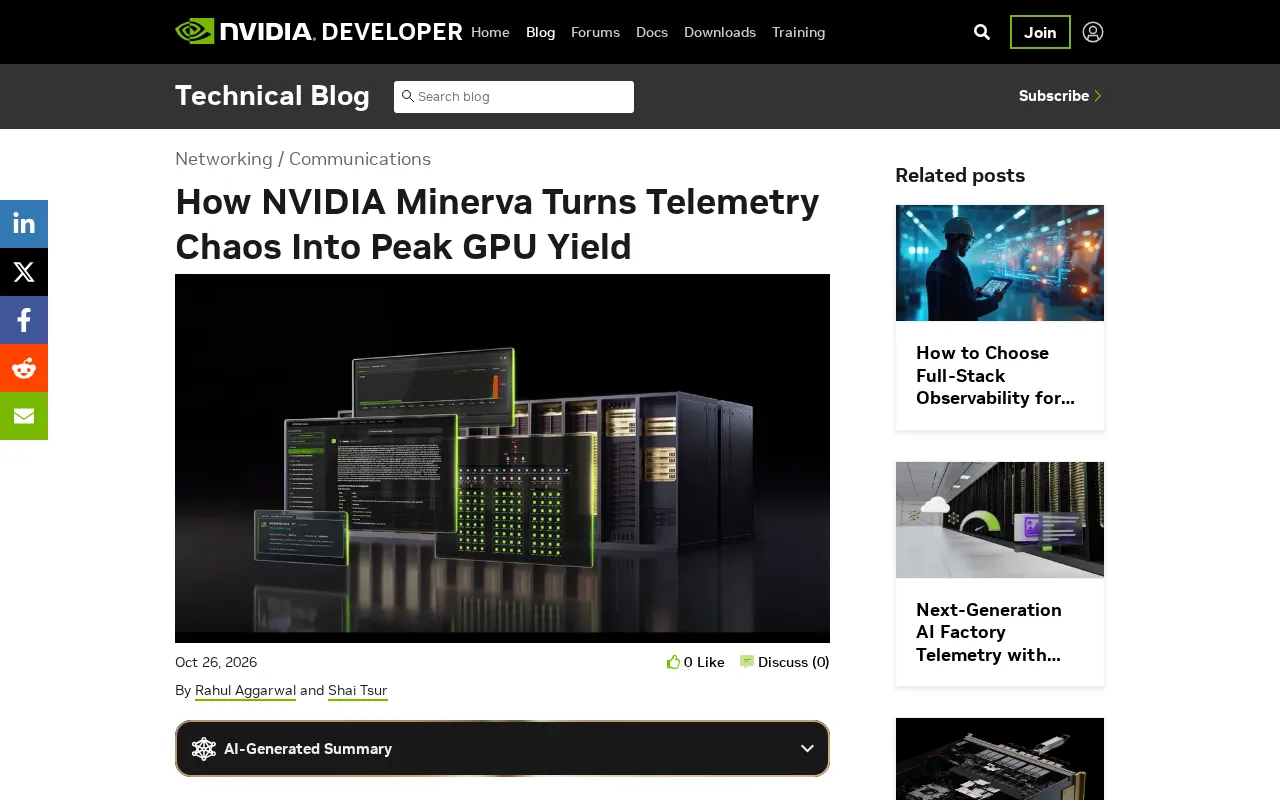
英伟达开发者博客披露的Minerva项目,针对数十万块GPU经Spectrum-X互联的AI工厂中隐性瓶颈难以定位的问题,提出了一套从遥测到产能的分析框架。文章指出,当前GPU与网络遥测数据量大、来源杂、语义不统一,形成"混沌",运维团队难以把降频、丢包、调度变化等信号对齐到同一时空坐标系。Minerva的做法是先统一采集与归一化跨GPU、跨网络的遥测,再做关联分析,最终反馈到运营动作。其评价标准从"指标是否越界"转向"有多少可用算力被浪费",推动AI工厂运维由被动排障走向主动产出优化,同时也点出遥测覆盖度与采集开销之间的平衡仍是落地难点。
AI工厂已成为人类建造过的最复杂的运营环境之一。数十万块GPU经由NVIDIA Spectrum-X以太网互联,任何一处隐性瓶颈都可能让整片集群的算力利用率悄悄下滑。英伟达开发者博客披露的Minerva项目,正是针对这一痛点的系统性回答:它把原本散落在监控面板和日志里的遥测数据,转化成可直接驱动产能决策的信号。
遥测数据为什么会变成"乱流"
在大规模GPU集群中,每块加速卡都会持续产出功耗、温度、时钟、显存占用、链路错误率等指标,交换机侧还有端口拥塞、丢包、重传等网络遥测。这些数据本身并不稀缺,稀缺的是把它们对齐到同一个时空坐标系的能力。
一旦维度对不齐,运维团队看到的就只是互不相干的曲线:某块GPU降频了,但同一时刻网络设备的计数是否异常、上层作业的调度行为是否发生变化,往往需要人工反复拼接。英伟达将这种状态描述为遥测的"混沌"——数据量大、来源杂、语义不统一,真正的产能损失被淹没在噪声里。
遥测(Telemetry) 在数据中心语境下指设备自动上报的运行状态数据,区别于被动拉取的监控指标。GPU遥测通常由NVML(NVIDIA Management Library)或DCGM(Data Center GPU Manager)暴露,涵盖功耗、温度、SM时钟、显存带宽利用率、ECC错误计数、NVLink链路状态等;网络侧则由交换机通过gNMI、sFlow、INT(带内网络遥测)等方式上报端口队列深度、PFC暂停帧、ECN标记等细粒度信息。这些数据的采样频率、时间戳精度、命名规范各不相同,有的以毫秒为粒度,有的按秒聚合,因此直接叠加会产生时间错位。所谓"对齐到同一时空坐标系",本质是解决时钟同步(如PTP)、采样对齐与语义映射三个层面的问题,这也是后续关联分析能否成立的技术基础。
Minerva的设计思路:从观测到产出
从英伟达公布的定位看,Minerva并不是又一个监控面板,而是面向"GPU产能"这一最终目标构建的分析层。它的核心工作可以概括为几步:先把跨GPU、跨网络的遥测统一采集与归一化,再在此基础上做关联分析,最后把结论反馈到运营动作上。
这种设计的关键差异在于评价标准。传统监控关心"指标是否越界",Minerva关心的是"有多少可用算力被浪费了"。两者看似相近,实际导向完全不同:前者容易在阈值附近产生大量无害告警,后者则必须把降频、空闲、重试、拥塞等不同现象折算成同一把尺子,才能比较优先级。
统一数据底座为什么重要
Spectrum-X以太网在AI集群中的角色,决定了网络遥测不能是附属品。当训练作业跨越成千上万块GPU时,链路层面的微小抖动会被同步通信放大,最终表现为整批卡的空等。把网络侧数据与计算侧数据放进同一分析框架,是Minerva能够定位"看不见的产能损失"的前提。
Spectrum-X 是英伟达面向AI集群推出的以太网平台,包含Spectrum-4交换机、BlueField-3 DPU与配套的软件栈,核心卖点是自适应路由(Adaptive Routing)与拥塞控制,用以在RoCEv2环境下逼近InfiniBand的尾延迟表现。在集合通信(如All-Reduce)中,所有GPU需同步交换梯度,任一链路的微秒级抖动都会让整组GPU进入等待,形成"木桶效应"。因此网络侧的PFC风暴、ECN标记比例、链路误码率等指标,与GPU侧的SM空闲率、降频事件在因果上强相关。只有把两类遥测放进同一分析框架,才能把"某次训练变慢"归因到具体链路或具体卡,而不是停留在"网络似乎有抖动"的模糊判断上。
对AI工厂运营意味着什么
英伟达把AI工厂定义为一种新型生产设施,其产出单位是有效算力而非传统商品。在这个语境下,Minerva的价值不只是排障效率提升,而是把运维从被动响应推向产出优化。
对运营团队而言,这意味着关注点要前移:与其等作业失败后回溯,不如在产能出现细微下滑时就介入。对平台建设者而言,这意味着遥测体系需要从一开始就按统一语义设计,而不是事后拼接多个孤岛系统。
说个细节,这类能力的落地高度依赖数据质量与采集覆盖度。遥测缺口会让关联分析失真,而过度采集又会带来额外开销,如何平衡仍是工程实践中的难点。
有效算力(Goodput) 是理解Minerva评价体系的关键概念,它指集群在单位时间内真正用于有效计算的比例,等于峰值算力乘以利用率、再扣除降频、空闲、重试与通信等待造成的损耗。与之相对的是传统监控关注的"是否越过阈值",后者只能捕捉离散异常,无法量化连续性的效率流失。业界常用MFU(Model FLOPs Utilization)或集群级有效训练时间占比来衡量这一指标。把降频、链路重传、作业排队等异构现象折算成统一的"浪费算力当量",才能在不同故障之间排出修复优先级,这也是从SRE式告警驱动转向产出驱动运营的方法论前提。
一个更清晰的产能视角
Minerva传递出的信号很明确:AI基础设施的竞争,正在从单卡性能转向系统级有效产出。数十万块GPU组成的集群里,决定实际算力的往往不是峰值参数,而是那些被遥测混沌掩盖的损耗。把观测能力转化为产能语言,是英伟达为AI工厂运营给出的方向性答案。
相关推荐
OpenAI数学突破、Anthropic IPO与推理模型教程
OpenAI公布数学、计算机与物理三项成果,声称证明ETH不成立;Anthropic提交上市申请,披露营收与客户数据;SpaceX获400亿美元GPU融资;开源模型工具调用准确率问题与约束解码方案;8视频推理模型构建教程。

推理模型14个核心概念:从思维链到GRPO全面拆解
系统拆解推理模型14个核心概念:思维链、测试时计算、验证器、RLVR与GRPO、蒸馏与reward hacking,并给出思考token的成本控制规则,帮你判断何时值得为推理付费。

OpenAI称推翻ETH引热议,Meta豪赌AI基建
OpenAI宣布AI辅助发现,预印本声称推翻指数时间假设ETH,同时推出中端模型GPT-6.1 Tera。Cloudflare披露跨客户数据泄露复盘,Meta拟融资950亿美元投入AI基建。