用AI Agent做模型创新:从消融实验到涨点的实战教学
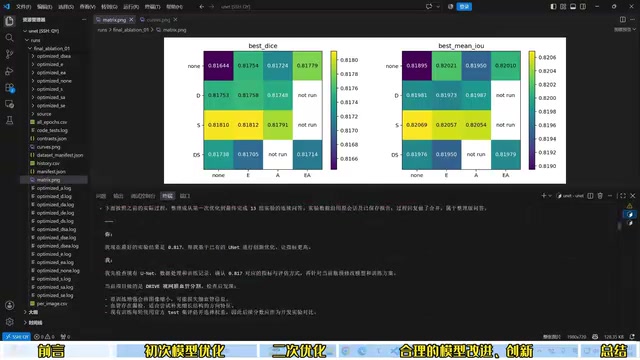
用AI Agent辅助UNet语义分割优化,通过基线锚定、单点验证、精准定位模块位置,实现mIoU约三个点的提升。
本文介绍了一套用AI Agent(Codex)辅助深度学习模型改进的系统化方法论,以UNet语义分割任务(基线mIoU 0.817)为例,分三轮迭代完成优化。第一轮Agent主要贡献来自训练策略调整(深度监督、方向卷积),创新性有限;第二轮通过预置即插即用模块文档引导Agent进行结构创新,但初次尝试因模块位置不当效果甚微,指定EMA插入编码器特定层、ASPP置于最深层后方显成效;第三轮将前两轮成果组合并进行系统性消融实验,最终方案平均mIoU提升约三个点。核心方法论提炼为四点:先锚定基线、单点验证后再组合、位置比数量更关键、用精准提示词引导Agent。整体模式为「人定方向、Agent执行」,比完全放任Agent自由发挥更稳健高效。
深度学习模型改进往往是科研和工程中最耗时、最考验经验的环节——加哪个模块、放在哪一层、如何组合,每一步都需要大量试错。B站UP主钱韵分享了一套用AI Agent(Codex)辅助模型优化的完整流程,核心理念是「一步一步来」,通过合理的提示词引导让Agent真正对指标产生正向贡献,而不是盲目缝合模块。本文梳理这套方法论的关键节点与实操细节。
Agent辅助模型优化的整体思路
这套方法以语义分割任务为例,基础模型是经典的 UNet,原始 mIoU 指标为 0.817。目标是通过 Agent 辅助,在保持工程可复现的前提下逐步提升指标。
作者选用 Codex 作为演示工具,并强调 Cloud Code 或其他 Agent 工具同样适用。安装完成后,在终端输入 codex 即可打开交互界面,随后通过对话形式驱动整个优化流程。
关键在于第一步就要给Agent明确的锚点:告诉它当前的原始指标(0.817)、使用的模型架构(UNet),以及优化目标——让结果更好。这个初始指标是后续所有改进的基线参照,缺少它Agent就无法判断改动是否真正有效。
第一轮:训练策略优化先行
第一次让Agent优化时,它给出的改动主要集中在方向卷积、深度监督以及一些训练策略上。测试结果显示:原始 0.817,加入这些改动后提升到 0.819,再叠加深度监督与方向卷积达到 0.82。
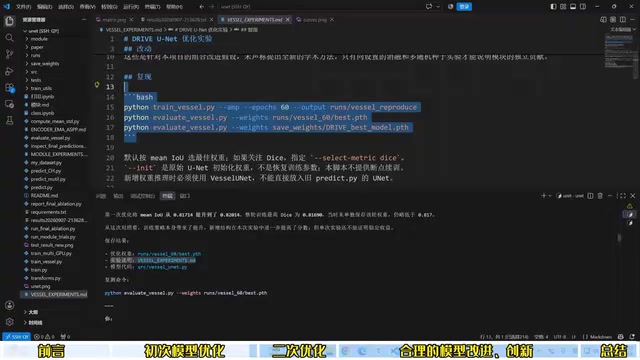
值得关注的是,作者在复盘log时点破了一个容易被忽略的事实:这一轮的主要提升来自训练策略的调整,而非模型结构层面的核心创新。换句话说,Agent很擅长「调参式」的优化,但要产生有科研价值的创新,还需要人为引导。
这也解释了为什么作者对第一轮结果并不满意——指标涨幅有限,创新性偏弱。做模型改进必须一步一步来,先看清每一次改动的贡献来源,才能判断下一步该往哪个方向走。
深度监督(Deep Supervision)是一种在网络中间层引入额外监督信号的训练技巧,最早在 GoogLeNet 等模型中被广泛采用。其核心思路是在编码器或解码器的不同尺度分支上分别计算损失,而不仅仅依赖最终输出的损失回传。这样做的好处是缓解梯度消失问题,使浅层特征也能得到有效训练。在语义分割任务中,深度监督通常以主损失加权求和辅助损失的形式实现,辅助损失权重在训练后期往往会逐步衰减。方向卷积(Directional Convolution)则是一种针对细长结构(如道路、血管)设计的卷积变体,通过在特定方向上扩展感受野,增强对各向异性目标的捕捉能力。这两类改动属于训练与结构的轻量级调整,工程实现门槛低,因此Agent在第一轮容易优先推荐,但其带来的指标增益上限也相对有限。
第二轮:引入模块库进行结构创新
为提升创新性,作者在项目文件夹中预置了一个包含大量即插即用模块的 Markdown 文档(涵盖通道注意力、空间注意力、多尺度注意力等),然后通过提示词让Agent从中挑选模块进行尝试。
Agent 查阅文档后挑出了三个模块,用于增强解码器的特征表达。但初次尝试的结果并不理想:原始 0.816,加入 EMA、LSK 后仅提升到 0.817,属于典型的「无效缝合」——模块加上去了,指标却几乎没动。
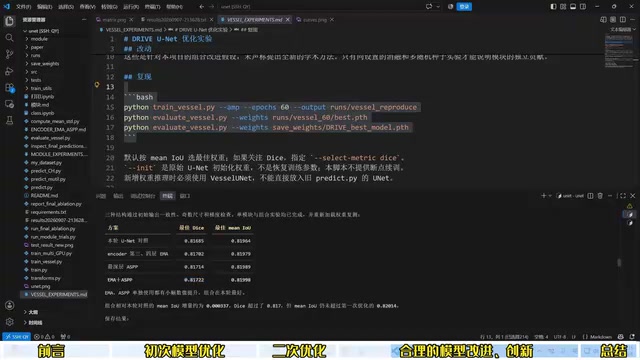
作者由此给出了一个核心经验:模块不能随便加,位置至关重要。他随后给出更精确的指令——在 encoder 的第 2-3 层、3-4 层添加 EMA,在最深层添加多尺度特征聚合(ASPP)模块。有了明确的位置指引后,EMA、ASPP 单独及组合都出现了提升。
如果自己不清楚模型架构、不知道模块该放哪里,也可以先让Agent对模型结构做一次分析,找到最优插入位置再进行缝合。这一步是「让Agent有效」和「让Agent瞎试」的分水岭。
EMA(Efficient Multi-scale Attention)是一种轻量级注意力机制,通过跨维度的多尺度特征交互来增强通道与空间的联合表达,计算开销显著低于标准的自注意力。ASPP(Atrous Spatial Pyramid Pooling,空洞空间金字塔池化)由 DeepLab 系列工作提出,其核心是使用多个不同膨胀率的空洞卷积并行提取多尺度上下文信息,并将结果拼接融合,从而在不降低分辨率的情况下扩大感受野。ASPP 通常被放置在编码器末端(最深层特征图处),因为此处语义信息最丰富、空间分辨率最低,多尺度感受野的收益最大。将这类模块随意插入浅层反而会干扰低级纹理特征的学习,这也是本轮实验中初次尝试效果不佳的主要原因。了解模块的设计初衷和适用层级,是判断「插在哪里」的理论依据。
第三轮:策略与模块的组合叠加
最后一轮,作者把前两轮的成果整合起来:将第一次得到的最优训练策略、新的网络结构,与第二轮筛选出的创新模块进行堆叠组合。
涉及的四个方向为:方向卷积、深度监督、EMA、ASPP,理论上有 16 种组合。作者采用固定超参、逐组测试的方式验证。实际做到第 13 组时选择停止,因为剩余 5 组的边际意义已经不大——这也是一种务实的实验节省思路。
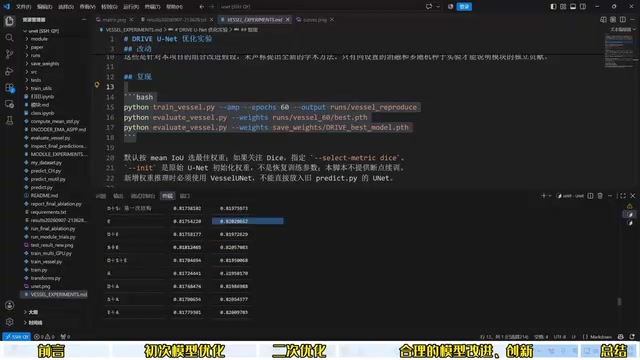
最终的消融实验结果显示:深度监督、方向卷积、EMA、模块添加各自都能带来提升,但需要注意某些组合叠加反而会降点(并非越多越好)。对比原始权重,最终方案的平均 mIoU 涨了约三个点。其中深度监督的思路借鉴自 Ultralytics 的相关设计,而 EMA 注意力机制对比原始 0.817 也贡献了明显增益。
消融实验(Ablation Study)是深度学习论文中验证各组件贡献的标准方法:每次只增减一个变量,保持其余条件不变,从而将指标变化归因于该变量。本文所描述的「逐组测试」本质上就是一套系统化的消融流程。对于 N 个独立模块,完整消融需要 2^N 种组合,随 N 增大呈指数增长;实际工程中常采用贪心策略——先单独验证每个模块,保留有效者后再做两两或三元组合,将搜索空间从指数级压缩到线性量级。作者在第 13 组停止测试的决策体现了这种务实权衡:当已有组合覆盖了主要模块的单独及高阶交互效应,剩余组合的边际信息价值确实有限,继续测试的算力成本难以被潜在的微小增益覆盖。
可复用的方法论沉淀
抛开具体任务,这套流程沉淀出几条通用经验:
- 基线优先:先给Agent明确的原始指标和模型信息,让每次改动都有参照。
- 单点验证,再做组合:先单独测每个模块的贡献,最后再组合,避免混淆效果来源。
- 位置比数量重要:注意力等模块的插入位置直接决定成败,不清楚就先让Agent分析架构。
- 善用提示词模板:合理的 prompt 能让Agent改得更精准,同时节省 token 消耗。
作者提到,配套的 prompt 模板、即插即用模块文档以及安装文档都会一并提供。对于科研党和需要「涨点」的工程师来说,这种「人定方向、Agent执行」的协作模式,比完全依赖Agent自由发挥要稳健得多。
需要提醒的是,视频中的指标提升幅度(约三个点)基于特定数据集与 UNet 任务,实际效果会因任务而异,方法论的价值大于具体数字。
相关推荐
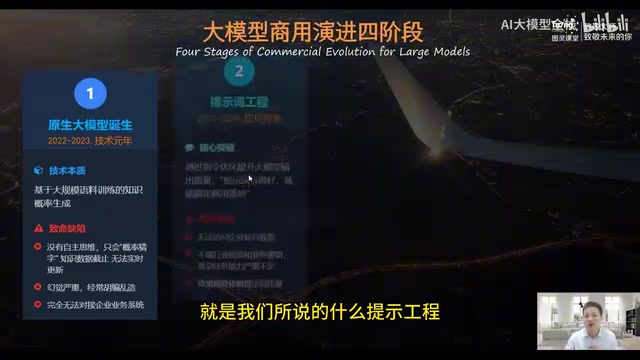
AI Agent实战入门:从大模型演进看智能体的价值与落地
从原生大模型、提示工程、RAG到AI Agent智能体,系统梳理大模型商业落地的四个阶段,解析Agent的翻译官、工具达人、记忆管家、任务管家四大核心能力,并给出企业级Agent入门的三个实战项目路线。
AI Agent智能体系统学习路径拆解:从原理到实战的完整框架
AI Agent智能体系统学习路径拆解:从Agent原理、Prompt工程、RAG知识库到多Agent协作与工具调用,再到个人知识库助手、智能客服等实战项目,帮零基础学习者打通从入门到落地的完整链条。
AI Agent智能体入门:大脑、记忆与工具三要素详解
从零理解AI Agent智能体:详解大脑、记忆、工具三大核心组件,梳理大模型从原生模型、提示工程、RAG到Agent的四阶段演进,帮你搞懂Agent到底解决了什么问题以及为何值得学习。