CLAP技术实现机械故障声音识别:原理、挑战与工业应用展望
让机器"听懂"故障声音:从经验诊断到AI识别
经验丰富的技师往往能通过设备运行时的异常声音判断潜在机械故障——轴承磨损、齿轮松动、皮带打滑,每一种故障都有独特的"声音指纹"。然而,这种依赖人工经验的诊断方式难以规模化,也无法实现24小时不间断监测。
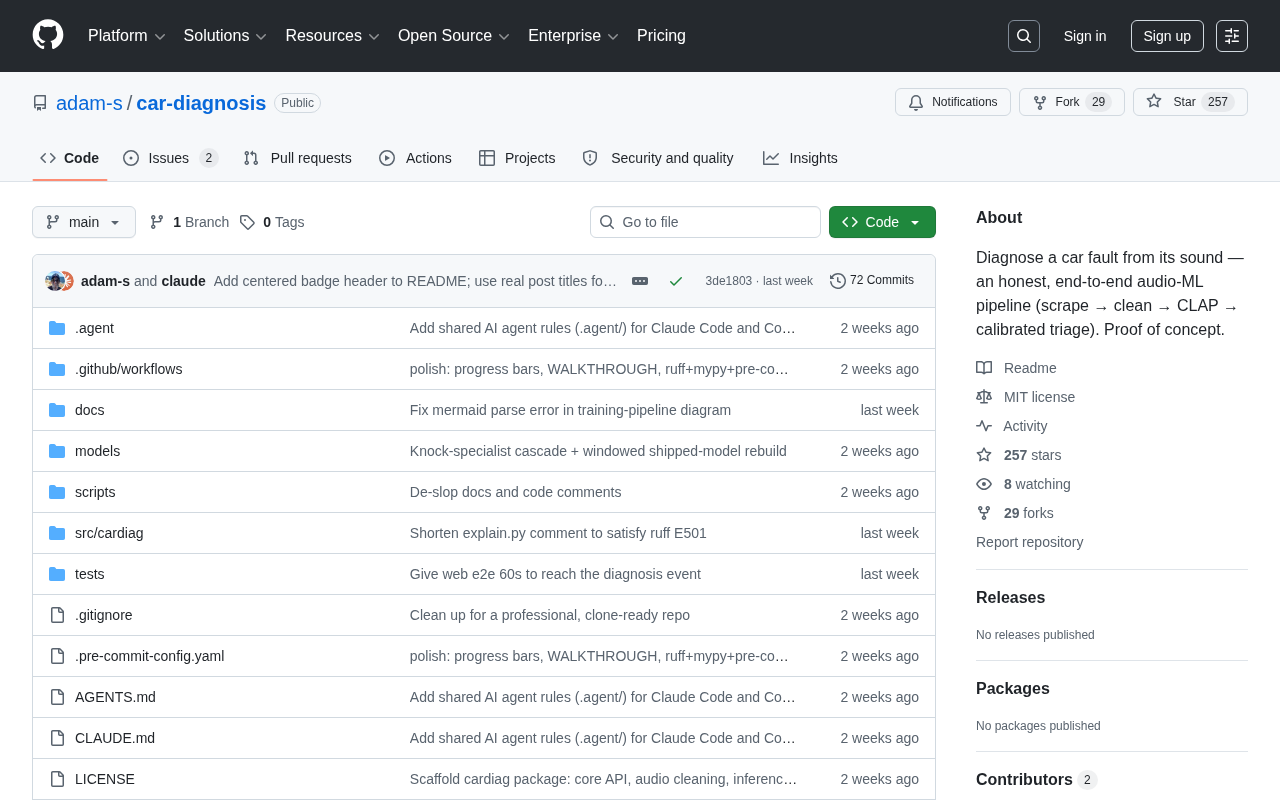
近期,一个在 Hacker News 上引发技术社区关注的开源项目,尝试使用 CLAP(Contrastive Language-Audio Pretraining,对比语言-音频预训练) 技术对机械故障进行分类。这一思路将自然语言处理与音频分析深度融合,为工业预测性维护提供了一条极具潜力的新路径。
工业预测性维护背景:预测性维护(Predictive Maintenance, PdM)是工业4.0的核心应用场景之一。传统维护模式分为故障后修复(Reactive Maintenance)和计划性定期维护(Preventive Maintenance),前者代价高昂,后者存在过度维护的浪费。预测性维护通过实时监测设备状态,在故障发生前预警,可将非计划停机时间减少高达50%,维护成本降低10-25%(据麦肯锡研究数据)。目前工业界主流的预测性维护技术依托振动分析、油液分析、红外热像等手段,声学分析因其非接触、低成本的特点正逐渐受到重视,但信号处理和AI建模的复杂性一直是普及障碍。
CLAP技术原理:从CLIP到音频领域的迁移
从视觉对比学习到音频理解
CLAP 的核心思想源自 OpenAI 的 CLIP(Contrastive Language-Image Pretraining)模型。CLIP 于2021年发布,通过从互联网收集的4亿个图像-文本配对数据进行训练,其革命性在于打破了传统视觉模型依赖固定类别标签的限制——只要能用文字描述的视觉概念,模型就能识别。CLIP 通过对比学习,将图像与文本映射到同一语义空间,实现了强大的零样本图像分类能力。
CLAP 将这一范式迁移至音频领域:通过在海量"音频-文本"配对数据上进行预训练,模型学会将声音信号与对应的文字描述编码到共享的嵌入空间。换言之,它能理解"一段刺耳的金属摩擦声"与"轴承缺油磨损"这类文本之间的语义关联。
CLAP 于2022年前后由多个研究团队独立提出,其中微软研究院与 University of Illinois 的工作影响较大。训练数据通常来自 AudioSet、FreeSound、Clotho 等公开音频数据集,涵盖数十万至数百万条音频-描述文本对。音频编码器通常采用基于 CNN 或 Transformer 的架构(如 PANN、HTS-AT),文本编码器则多沿用 BERT 或 RoBERTa 系列。
对比学习的核心机制
对比学习(Contrastive Learning)的技术根源可追溯到自监督学习领域,SimCLR、MoCo 等方法的核心都是通过最大化同类样本相似度、最小化异类样本相似度来学习表征。其关键逻辑是"拉近正样本、推远负样本":训练过程中,匹配的音频-文本对距离被不断拉近,不匹配的组合则被推远。CLIP 将这一机制升维,跨越了视觉和语言两个不同模态;CLAP 则将同样的跨模态对齐思路应用于音频与语言之间。大规模训练结束后,模型便在声音与语义之间建立起稳固的桥梁。
这种设计赋予了模型关键的零样本(Zero-shot)分类能力——即便从未见过某类故障的标注数据,只要能用文字描述其声学特征,模型就有可能完成识别。
CLAP用于机械故障诊断的核心优势
突破传统监督学习的三大瓶颈
传统机械故障声音分类依赖监督学习:需收集大量已标注故障音频,训练专用分类模型。这种方案存在明显痛点:
- 数据稀缺:罕见故障样本极难获取,模型训练严重不足;
- 泛化能力差:换一台设备或工况变化后,模型往往需要重新训练;
- 标注成本高:为每类故障标注音频需要专业知识与大量人力投入。
基于 CLAP 的方案借助预训练模型的语义理解能力,通过灵活的**文本提示(Text Prompt)**定义故障类别,大幅降低对标注数据的依赖。
自然语言驱动的灵活扩展
在实际应用中,工程师可直接用自然语言描述需识别的故障类型,例如"齿轮箱异响"、"电机轴承故障"、"设备正常运行声"。模型计算输入音频与各文本描述的相似度,输出最匹配的类别。
这种交互方式不仅大幅降低使用门槛,还让故障类别的扩展极为简便——无需重新训练,只需增加或修改文本描述即可。
从技术演示到工业落地:三大核心挑战
挑战一:工业声学的领域偏移问题
CLAP 预训练数据通常涵盖环境声、音乐、语音等日常音频,而机械故障声音包含高频振动(通常在1kHz-20kHz范围)、周期性冲击脉冲及各类机械共振模式,在频谱特征上与日常环境声差异悬殊。这种**领域偏移(Domain Gap)**是影响实际效果的核心障碍。
应对领域偏移的主要技术路径包括:领域自适应(Domain Adaptation)、少样本微调(Few-shot Fine-tuning)和检索增强(Retrieval-Augmented)方法。对于 CLAP 这类大型预训练模型,参数高效微调技术如 LoRA(Low-Rank Adaptation) 和 Adapter 层注入,可在仅更新少量参数的前提下实现显著的领域适配,有效平衡通用能力保留与专业性能提升之间的张力。要在工业场景取得理想表现,很可能需要在特定领域数据上进行微调(Fine-tuning),或构建专门的机械声学-文本配对数据集。
挑战二:复杂工业环境的噪声干扰
真实工业现场往往多台设备同时运行,背景噪声极为复杂。如何在强噪声环境下准确提取目标设备的声学特征,需要结合信号预处理、声源分离等工程手段协同解决。
挑战三:工程化部署的系统要求
作为一个概念验证项目,技术演示距离真正的工业部署仍有相当距离。将 AI 模型从云端研究环境部署到工厂生产线,面临的工程挑战往往比算法本身更为复杂:
- 实时性:机械故障声学分析通常要求百毫秒级的推理延迟;
- 模型轻量化:边缘设备资源有限,CLAP 原始模型参数量通常在数百MB至GB级别,需通过模型量化(INT8/INT4)、知识蒸馏(Knowledge Distillation)或结构剪枝(Pruning)大幅压缩;
- 误报率控制:工业场景对误报率的容忍度极低——频繁误报会导致工人对系统失去信任,形成"狼来了"效应;
- 标准化接入:工业物联网(IIoT)平台的标准化接口、OPC-UA 协议集成,以及符合 IEC 61508 等功能安全标准,都是量产部署前必须系统考量的要素。
技术展望:工业声学AI的三个演进方向
这一项目的深远价值在于揭示了多模态预训练模型向垂直工业领域迁移的可行路径。随着基础模型(Foundation Models)能力的持续进化,将其引入预测性维护、设备健康监测等场景正成为值得重点关注的技术趋势。
未来可期的演进方向包括:
- 专业工业声学预训练模型:针对机械设备声音构建专用的 CLAP 变体,覆盖更广的故障声学图谱;
- 多模态融合诊断系统:将声音、振动、温度、电流等多维度信号融合,提升诊断可靠性;
- 人机协作智能运维:工程师以自然语言提问,AI 实时给出故障判断与维修建议。
结语
用 AI 让机器"听懂"故障声音,这个想法本身就充满想象力。CLAP 技术将自然语言的灵活性与音频分析的专业性有机结合,以零样本分类和易扩展的文本提示机制,为机械故障诊断打开了一扇新窗。
尽管从技术演示到工业落地仍有不小距离,但这类将前沿 AI 能力与传统工业需求融合的开源探索,正是推动行业进步的重要驱动力。期待更多类似创新,将大模型的智能真正带入工业生产的第一线。
核心要点
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。