用Codex打通AI科研全流程:从找代码到写论文的自动化实践

用Codex打通科研全链路:从找源码、跑实验到写论文配图,人指挥、AI执行。
本文介绍了一套以OpenAI Codex为核心工具的科研效率方法论,将论文写作中最耗时的五个环节——检索源码、配置环境、跑实验、撰写论文、绘制配图——全部通过对话方式交给AI完成。核心逻辑是"先找可复现的基线代码再做创新",而非从零开始;实验全程在对话框内驱动,无需手写代码;跑完实验后必须生成结构化报告,为后续写作提供可靠上下文;写作阶段通过喂范文让AI模仿特定领域的写作风格;最终配图也由AI完成。该方法的本质不是AI自动做科研,而是人凭借对科研流程的理解来指挥AI执行,决策权始终在人手中,适合希望降低技术门槛、提升迭代效率的科研新手参考。
对科研新手来说,做一篇论文往往卡在几个反复消耗时间的环节:找可复现的源码、配置运行环境、跑实验做对比、撰写论文、绘制配图。这些工作既需要编程能力,又需要大量重复劳动。B站一位科研工具分享UP主提出了一套思路——把这五件最耗时的事全部交给 Codex 来完成,人只负责"指挥",不写一行代码。
本文梳理这套流程的核心逻辑,帮助想要提升科研效率的研究生理解如何用AI工具打通从选题到成稿的全链路。
第一步:让Codex帮你检索可复现的源码
很多人以为做论文的第一步是读文献,但这位UP主给出了不同的观点:先找到一个能跑通的基础模型代码,再去考虑改进和优化。理由很实际——如果连一个可执行的基线(baseline)都没有,后续的创新、对比实验都无从谈起。
关键在于,检索源码这件事本身也可以交给 Codex。你不需要自己在 GitHub 上大海捞针,而是借助 Codex 的检索能力,让它帮你找到一个合适的扩散模型(视频中反复提到的"被散模型"应为扩散模型 diffusion model)作为起点。这样一来,即便是跨专业、不熟悉代码生态的新手,也能快速定位到可用的项目。
扩散模型(Diffusion Model) 是近年来深度学习领域最热门的生成模型之一,其核心思想是模拟物理中的扩散过程:先向数据逐步添加噪声(前向过程),再训练神经网络学会逐步去除噪声、还原原始数据(反向过程)。DDPM、Stable Diffusion、DALL·E 2等知名模型均基于这一框架。由于其在图像、视频、音频生成任务上表现出色,相关论文数量在2022年后爆炸式增长,成为计算机视觉方向毕业论文的热门选题。正因如此,GitHub上已有大量开源实现,基线代码的可获得性较高,适合作为"从已有代码出发再做改进"这一策略的起点。
第二步:环境配置与跑实验全程对话完成
对科研小白而言,最大的门槛往往不是想法,而是"我配不了环境、写不出代码、不知道模型能改什么"。这套方法的核心主张是:这些全部交给 Codex,你连 PyCharm、VS Code 都不用打开,所有操作都在对话框里完成。
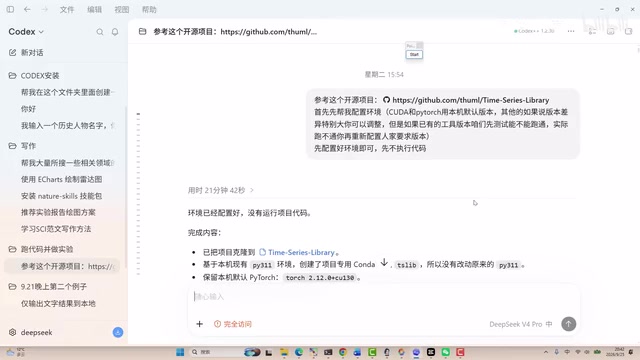
环境配置完成后,真正漫长的部分是跑实验。UP主强调,这不是一两轮对话就能搞定的事,而是要经过很多轮反复交互。在这个阶段,重点是教会大家如何用 Codex 做几件事:
- 做创新点:在基线模型上提出改进方向
- 加模块 / 换模块:修改网络结构进行探索
- 做对比实验:验证改进是否真正有效
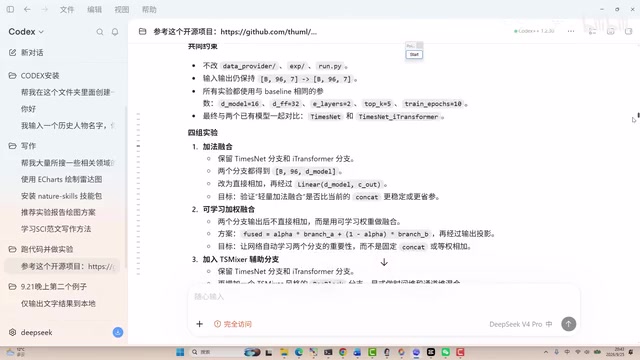
整个过程会产生大量代码文件。如果靠人工从零编写,时间成本极高;而通过持续和 Codex 对话——"我想优化什么、改进什么"——让它不断生成和调试代码,就能把这部分工作大幅压缩。
为什么一定要生成实验报告
跑完实验后,UP主特别强调要让 Codex 输出一份完整的实验报告,内容包括做了哪些改动、优化了什么、得到了哪些结果。
这一步看似多余,实则是承上启下的关键。做实验的最终目的是为了写论文,而写论文时需要有"东西可写"。既然后续要让 Codex 帮忙撰写论文,就必须先形成结构化的报告结果,让模型清楚地"知道"实验取得了哪些成就。这本质上是给AI提供高质量的上下文,避免它凭空编造实验数据。

OpenAI Codex 是OpenAI推出的代码生成模型,基于GPT系列架构,针对代码数据进行了专项训练,能够理解自然语言指令并生成对应的Python、Shell等多种语言代码。它是GitHub Copilot的底层技术基础。在科研场景中,Codex可以完成的典型任务包括:根据描述生成依赖安装脚本(如pip install或conda命令)、修改模型配置文件、在现有网络结构中插入新模块、编写训练循环和评估代码等。需要注意的是,Codex本身不能直接"执行"代码,它生成的代码仍需在本地或云端环境(如Google Colab、AutoDL等GPU平台)中运行;"全程在对话框完成"指的是代码的生成与调试通过对话驱动,而非真正绕过了运行环境。
这里涉及到大语言模型使用中的一个核心概念——上下文窗口(Context Window)与提示工程(Prompt Engineering)。大模型在每次对话中只能"看到"有限长度的上下文,如果实验数据、改进细节没有被显式整理进提示词,模型在写作时就缺乏事实依据,容易产生"幻觉"(Hallucination),即编造并不存在的实验数据或结论。结构化实验报告的本质,是将散落在多轮对话中的关键信息压缩成一份高密度的事实摘要,在后续写作时作为"可信来源"注入提示词,从而约束模型输出、降低内容失真的风险。这也是AI辅助写作中"先整理事实、再生成文字"这一最佳实践的具体体现。
第三步:借助范文思想指导论文写作
写作环节的方法论是:不同行业、不同业务逻辑的写法各有差异,但可以通过"喂范文"来统一标准。
具体做法是找几篇优质范文,把范文的结构和思想教给 Codex,再让它一步步完成摘要、引言等各个部分。这种做法的巧妙之处在于,与其空泛地要求AI"写一篇论文",不如给它明确的模仿对象和写作框架,输出质量会明显更可控。
第四步:用技能包完成实验图与结构图
论文的最后一块拼图是配图。UP主提到会用到一些"技能包"来辅助绘图,主要覆盖两类图:
- 实验结果图:把跑出来的数据结果可视化
- 网络结构图:展示模型的整体架构

这些图人工也能画,但时间成本很高。让 Codex 独立完成绘图,能把研究者从繁琐的画图工作中解放出来。尤其是网络结构图,往往需要反复调整对齐、配色,交给AI处理效率更高。
全流程的核心:人的业务理解 + AI的执行力
把这套方法串起来看,它的本质并不是"AI替你做科研",而是用人对科研流程的理解去驱动AI的执行能力。UP主反复强调的是自己"如何完成一篇论文"的经验——每一步该做什么、按什么顺序做——然后把每个环节的具体操作交给 Codex。
从找源码、配环境、跑实验、做对比、写作到配图,Codex 扮演的是一个不知疲倦的执行者,而人始终是决策者和指挥者。
需要客观看待的是,这套流程是一位UP主基于个人经验的分享,实际效果高度依赖于任务的复杂度、模型能力以及使用者的指挥水平。视频中提到"跑实验非常漫长""要跑很多轮",也说明它并非一键出结果的魔法,而是一个需要持续人工介入和判断的迭代过程。对于希望用AI提升科研效率的研究生来说,理解这套"人主导、AI执行"的分工逻辑,可能比工具本身更有价值。
相关推荐

MCP 实战:在 OpenAI Agents SDK 中接入外部工具
本文基于 YouTube 教程,详解如何在 OpenAI Agents SDK 中使用 MCP(模型上下文协议)接入外部工具:从构建 MCP 服务器、注册工具,到 stdio、streamable HTTP、Hosted MCP 三种连接方式,以及工具过滤的实战技巧。

深入MCP协议:AI Agent工具调用背后的性能陷阱
深入解析MCP(模型上下文协议)如何支撑AI Agent工具调用:JSON-RPC封装的性能开销、SSE多路复用的安全隔离,以及工程团队在生产环境中绕过协议直连数据库的真实权衡。

用 YAML 构建协作式 AI 智能体团队:Docker Agent 实践
Docker Agent 让你用 YAML 声明式配置构建协作式 AI 智能体团队,无需手写智能体代码。支持多智能体自动委派、MCP 工具集成,兼容 OpenAI、Anthropic、Gemini 等多种模型,配置可版本化、可共享。