用Git工作树让多个AI Agent并行开发互不干扰
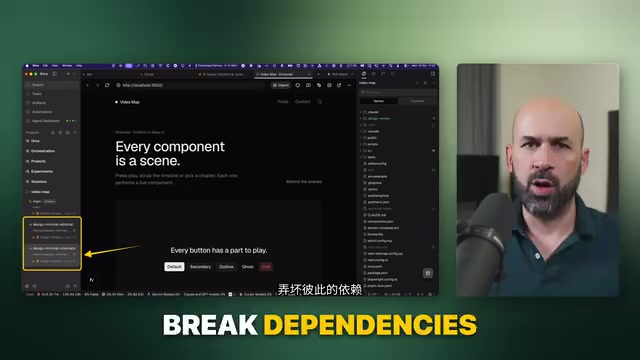
用Git工作树为每个AI Agent提供隔离环境,实现真正并行开发。
文章探讨了多个AI智能体并行工作时面临的环境隔离难题,指出串行等待严重拖慢开发效率。基于B站技术视频的解法,核心是利用Git工作树为每个Agent创建独立的工作目录,共享同一仓库历史但物理路径分离,从而避免代码、依赖和端口冲突。文章对比了克隆仓库的低效性,强调端口必须唯一规划,并批评了复用数据库的脆弱方案,主张通过脚本固化初始化与清理流程,实现全自动、可复现的Agent运行环境。最后指出,并行效率的上限由工程基础设施决定,团队可从两三个工作树起步逐步改造。
多个AI智能体串行工作——提示、等结果、再提示、再等结果——正在悄悄吃掉开发时间。真正的并行不是多开几个Agent窗口,而是让每个Agent拥有一个干净、隔离、可复现的运行环境,否则它们会互相踩踏代码、环境变量和依赖。来自B站的技术视频(UP主Orca,中英字幕)给出了一套基于Git工作树(work tree)的解法,核心思路值得每一位重度使用AI编程的开发者了解。
为什么并行Agent难在隔离
启动多个AI智能体本身并不困难,难的是给每一个提供独立的"宇宙"。视频中举了一个很具体的例子:一个项目包含服务端和数据库,服务端监听某个端口,数据库在另一个端口,两者互相通信。如果你在同一台机器上并行跑三份这样的环境,端口冲突、依赖版本、环境配置文件都会成为冲突源。
据UP主Orca的表述,如果没有隔离,Agent之间会破坏彼此的代码、环境变量和依赖关系。换句话说,并行开发失败的根因往往不是模型能力,而是工程环境没有做好分区。
Git工作树:比克隆仓库更适合并行
最直觉的做法是把仓库克隆两份到本地。但视频指出,克隆出来的两个副本彼此是断开的,只能通过远程仓库同步——这对需要频繁合并分支的并行开发来说效率很低。
Git工作树提供了另一种机制:在主目录之外另设一个位置,由Git统一管理,但物理路径不同。视频中的做法是把两到四个工作树各自视为一个"不同的世界",每个世界独立完成依赖安装、数据库配置等初始化步骤。关键差异在于,这些工作树仍然共享同一个Git仓库的版本历史,合并与清理都更自然。
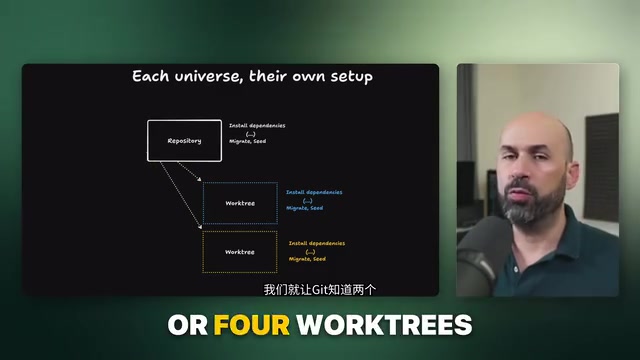
端口必须唯一
同一台机器上运行多个应用实例时,端口绝不能重复。系统无法把两个程序分配到同一个端口,因此让每个实例使用不同端口,是应用自身需要负责的事情,需要在初始化工作树时就把端口规划好。
Git 工作树(worktree)是 Git 2.5 引入的特性,允许同一个仓库同时检出多个工作目录。每个工作树对应一个独立的分支或提交,拥有自己的文件系统路径,但共享底层的对象数据库和引用(refs)。这意味着在任一工作树中的提交、分支创建和合并操作,都会即时反映到其他工作树,无需通过远程仓库中转。与克隆相比,工作树节省磁盘空间和网络开销,且合并分支时直接在本地仓库内完成,避免了“克隆副本间只能靠 push/pull 同步”的延迟。使用 git worktree add <path> <branch> 创建,git worktree remove 清理。需要注意的是,同一分支不能同时检出到两个工作树,这正好迫使每个 Agent 工作在独立分支上,天然契合并行开发。
端口是操作系统分配给网络进程的逻辑编号,同一协议(TCP/UDP)下同一端口在同一时刻只能被一个进程监听,否则会触发“Address already in use”错误。在容器化或本地多实例场景中,常见做法是通过环境变量(如 PORT、DB_PORT)让应用读取配置,而不是硬编码端口号。初始化工作树时,可以为每个实例分配一个端口区间(例如 3000-3003 对应四个工作树),并在 .env 文件或启动脚本中注入。数据库连接字符串中的端口也需同步调整。若使用 Docker,还可通过端口映射将容器内固定端口映射到宿主机不同端口,进一步隔离。端口规划应在创建 worktree 的脚本中自动完成,避免人工分配导致冲突。
脆弱的复用方案与更稳的路径
视频里也提到一种更简单但脆弱的自动化方式:复用同一个数据库软件,为每个工作树创建独立数据库,任务结束后销毁。这种做法上手快,适合早期验证,但UP主明确将其归类为"brittle automation",不建议作为长期方案。
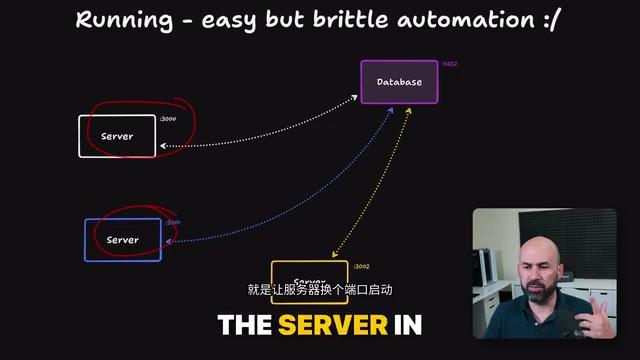
更稳妥的路径是把整套初始化与清理流程固化下来。任务完成后的收尾同样重要:合并差异、删除工作树产生的文件、数据库和服务,清除所有启动过的痕迹。把这些步骤写成脚本,交给Agent生成bash文件,就能做到可分享、可复现。
启动即就绪
视频最后提到一个实用细节:运行工作树时可以直接打开多个标签页,让相关进程自动跑起来。这样开发者进入环境时就已经处于可工作状态,减少了手动准备的环节。
“脆弱的自动化”(brittle automation)指那些在理想路径下能运行、但一旦环境稍变就容易失效的脚本或流程。例如,复用同一个数据库软件并为每个工作树创建独立数据库,看似节省资源,却隐含多个风险:数据库实例成为单点故障,一个 Agent 的误操作可能影响其他库;清理脚本若未正确执行,残留数据库会累积并占用资源;不同工作树对数据库版本或扩展的需求可能冲突。相比之下,更稳健的做法是为每个工作树提供完全独立的运行时(如通过 Docker Compose 启动专属的数据库容器),并用幂等脚本管理生命周期——初始化时创建,任务结束后销毁。脚本应包含错误处理和状态检查,确保可重复执行。将这类脚本纳入版本控制,还能让团队成员和 Agent 共享同一套环境定义,提升可复现性。
对AI编程工作流的启示
这套方法的价值不限于某一款工具。它揭示了一个容易被忽略的事实:AI Agent的并行效率上限,往往由工程基础设施决定。工作树解决的是文件系统与版本控制层面的隔离,端口与数据库方案解决的是运行时隔离,脚本化则解决的是可复现性。三者叠加,才构成视频所说的"理想条件下全自动、可复现"的Agent运行环境。
对于正在尝试多Agent协作的团队,可以先从两到三个工作树起步,用脚本固化初始化流程,再逐步替换掉脆弱的数据库复用方案。相比继续串行地等待每一个Agent返回结果,这套改造的投入产出比相当可观。
相关推荐

FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。

前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。