用果蝇连接组玩国际象棋:多巴胺强化学习的另类实验
开发者将果蝇真实神经连接组导入PyTorch,用强化学习训练其下国际象棋,探索稀疏生物拓扑能否承载任意学习任务。
Reddit用户AdilSiddiqui将Google发布的果蝇全脑连接组(约16.4万神经元)映射进PyTorch,要求信号只能沿真实生物突触流动,以此构建出一个拓扑固定的稀疏神经网络,再用强化学习训练它下国际象棋。奖励机制被称为"虚拟多巴胺"——仅在模型完成合法走子或吃子时触发突触权重更新。这一实验的核心问题是:在无法新增任何连接的刚性生物拓扑上,学习算法能否自行开辟出可用的功能通路?项目已开源至GitHub,支持本地GPU训练,并发起了以ELO为标准的社区打榜挑战。它的价值不在于性能超越主流方法,而在于为"连接组学+强化学习"的交叉方向提供了一个开放、可复现的实验平台。
一个大胆的假设:让生物大脑接线图学下棋
当大多数机器学习项目还在堆叠更宽更深的全连接网络时,一位开发者(Reddit 用户 AdilSiddiqui)选择了一条截然不同的路径:把果蝇的真实神经连接组(connectome)当作神经网络的骨架,用强化学习去训练它下国际象棋。
这个项目的核心问题并不复杂,却相当反直觉——强化学习能否在一个僵硬的、由生物结构决定的矩阵上,自行开辟出可用的运算通路? 换句话说,如果神经元之间的连接不是随机初始化、可以任意学习的权重,而是被真实生物突触严格限制的固定拓扑,学习还能发生吗?
把 16.4 万个神经元搬进 PyTorch
作者使用了 Google 发布的果蝇连接组数据,其中包含约 164,000 个神经元,并将这张生物接线图映射进 PyTorch。这里最关键的设计约束是:电流(信号)只能沿着真实存在的生物突触流动。
这与传统稠密神经网络(dense neural net)有本质区别。标准网络中每一层的神经元与下一层几乎全连接,权重矩阵是稠密的;而在这个项目里,连接矩阵是稀疏的、且由生物结构预先决定——你无法凭空创造一条不存在的突触连接。学习能做的,只是调整那些已经存在的连接的强度。
从工程角度看,这相当于在一个受严格结构先验约束的稀疏图上做优化。这种约束既是限制,也可能是一种有趣的归纳偏置(inductive bias):真实生物大脑的连接结构本身就是亿万年进化筛选的结果。
**连接组(connectome)**是对某一生物体神经系统中所有神经元及其突触连接的完整图谱。Google与Janelia研究院联合发布的果蝇(Drosophila melanogaster)全脑连接组是目前最完整的动物全脑接线图之一,包含约14.6万个神经元和5000余万个突触(不同版本数据略有差异)。绘制这张图谱耗费了研究人员数年时间,主要依赖电子显微镜对脑组织切片进行逐层扫描,再经人工与AI协作标注。之所以选择果蝇而非哺乳动物,是因为果蝇的神经系统规模相对适中,而其行为(飞行、觅食、学习等)又足够复杂,使其成为连接组学研究的"黄金模式生物"。将这张稀疏图导入PyTorch的技术挑战在于:164,000个节点之间的连接关系需要以稀疏矩阵形式存储和计算,普通的稠密矩阵乘法会产生无法承受的内存与算力开销。
用“虚拟多巴胺”做奖励信号
项目的强化学习机制被作者形象地称为“虚拟多巴胺”(virtual dopamine)。具体做法是:只有当模型执行一个合法的国际象棋走子、或者吃掉对方棋子时,才施加突触权重调整。
这里的类比很直白——多巴胺在生物神经系统中扮演着奖励与强化的角色,作者把突触权重的调整等同于多巴胺信号的释放。合法走子和吃子作为正向奖励事件,驱动连接强度的更新。
这种设计把强化学习的奖励塑造(reward shaping)与神经科学的奖励机制做了一个概念上的对应。虽然这更多是一种类比而非严格的生物学建模,但它为“如何在固定拓扑上引导学习”提供了一个清晰的操作路径:不改结构,只在被奖励的时刻调整已有连接的权重。
一个开放的 RL 环境:欢迎来打榜
作者已经把完整项目开源到 GitHub(fly-connectome-chess),并且提供了一套可在本地 GPU 上运行的训练流程:
- 克隆仓库后,可以在 Web UI 中点击 “Train” 按钮直接开始训练;
- 项目定位为“独特的强化学习环境”,适合想在自己显卡上折腾的人尝试;
- 作者还发起了一个类似打榜的挑战:如果你训练出的 ELO 分数超过他,就提交一个包含
weights.pt的 PR。
这种“提交权重文件 PR”的众包式训练玩法,让项目带有一点社区竞赛的色彩,也降低了他人参与和复现的门槛。
这个实验为什么值得关注
抛开胜率和 ELO 高低,这个项目真正有意思的地方在于它提出的思路:用生物连接组替代人为设计的网络架构。
主流深度学习的架构设计(Transformer、CNN、MLP 等)本质上是人类工程经验的产物。而连接组代表的是另一种可能性——直接借用生物演化出来的连接结构作为计算基底,再用学习算法在其上寻找可行的功能通路。这类探索在学术界通常归属于神经形态计算(neuromorphic computing)与连接组学的交叉地带。
当然,需要保持清醒:把果蝇连接组用来下棋,本身并不意味着它比稠密网络更高效或更强。果蝇的神经系统从未进化出下棋的能力,强行让它承担这个任务,更多是一次概念验证式的探索,用来检验“稀疏生物拓扑 + 强化学习”这条路是否走得通。它的价值在于提出问题、提供一个可复现的实验平台,而非给出性能上的结论。
**神经形态计算(neuromorphic computing)**是一种以模仿生物神经系统结构和信号机制为目标的计算范式,代表性硬件包括Intel的Loihi芯片和IBM的TrueNorth芯片。与GPU上的深度学习不同,神经形态系统通常采用脉冲神经网络(Spiking Neural Network,SNN),用离散的"脉冲"事件而非连续浮点数传递信息,在低功耗、事件驱动场景下具有效率优势。本项目并未采用脉冲机制,仍在标准的反向传播/权重更新框架内运行,因此与硬件层面的神经形态计算有所区别——它更接近"借用生物拓扑结构的软件实验",而非真正的神经形态实现。但这类工作所提出的核心问题——固定的稀疏生物拓扑能否承载任意学习任务——对神经形态计算的架构设计具有直接参考价值。
结语
这是一个典型的“先问一个奇怪的问题,再动手做出来”的独立开发者项目。它把连接组学、强化学习和游戏 AI 三者拼在一起,虽然规模不大、也没有宣称性能突破,但提供了一个开放、可玩、可复现的实验环境。对于对神经形态计算、稀疏网络或非标准 RL 环境感兴趣的人来说,这样的项目本身就是一份值得动手的邀请。
背景补充
在真实的神经科学中,多巴胺能系统(尤其是腹侧被盖区到伏隔核的通路)编码的并非"快乐"本身,而是奖励预测误差(reward prediction error)——即实际获得的奖励与预期奖励之间的差值,这一机制正是时序差分(TD)强化学习算法的生物学对应物。当预期之外的奖励出现时,多巴胺浓度升高并增强相关突触连接(即Hebbian可塑性中的"一起激发、一起连线"原则);反之,奖励缺失则导致多巴胺水平下降并削弱连接。本项目的"虚拟多巴胺"做了大幅简化:仅以合法走子和吃子作为离散的正向事件触发权重更新,没有负向惩罚,也没有对奖励预测误差的显式建模。这使得它更接近一种朴素的"事件驱动权重增强",而非完整的TD学习实现,但这种简化也让生物类比更直观、实现更轻量。
相关推荐
用AI Agent自动扫描LinkedIn信息流:可行性与技术难点解析
如何用AI Agent每天自动扫描LinkedIn信息流并生成定制摘要?本文解析身份认证、反爬限制、浏览器控制三大技术难点,并给出基于浏览器自动化与LLM结合的务实实现方案及合规风险提醒。
政治方法论前沿:如何更精准地测量社会
政治方法论学者 Naoki Egami 致力于改进社会科学研究工具,提升研究结论的稳健性与可推广性。本文解析精准测量在实证社会科学中的关键意义。
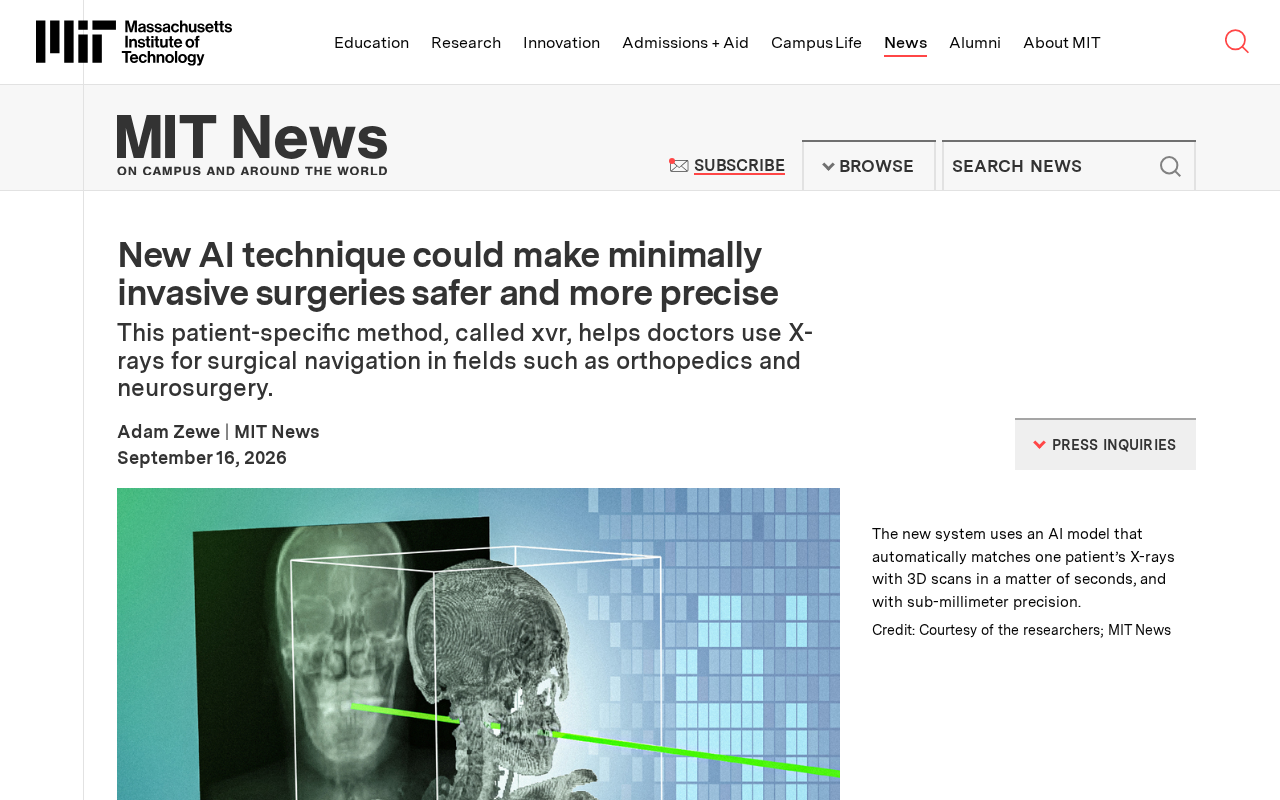
xvr技术:AI让微创手术导航更精准安全
新型AI技术xvr通过病人特异性方法优化X射线手术导航,有望让骨科、神经外科等微创手术更安全、更精准。本文解析其原理与应用前景。