用户期待Opus 5.5改进什么?聚焦写作质量与任务专注
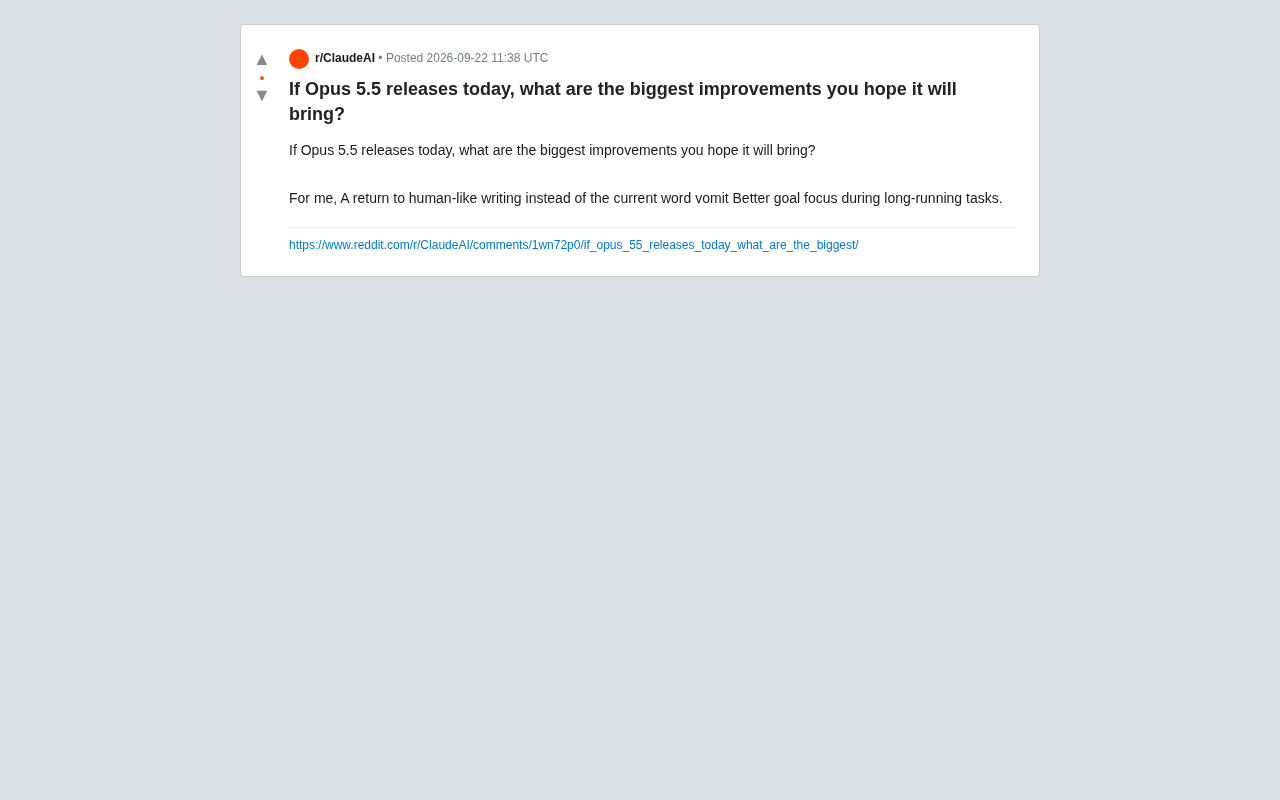
Reddit用户期待Claude Opus 5.5回归人味写作并提升长任务目标专注度,折射出大模型竞争重心的转移。
一条Reddit讨论帖揭示了用户对Claude下一代模型的两大核心期待:其一是告别冗长堆砌的「词语呕吐」式输出,回归克制、精准、有节奏感的人类化写作;其二是在长程多步骤任务中克服「目标漂移」,保持行动的连贯性与目的性。这两个诉求均来自真实使用场景,而非抽象的技术指标讨论。它们共同指向一个更深层的行业信号:当基础能力趋于饱和,模型竞争正从「能做什么」转向「做得是否得体、可控」。对于以「对齐」和「可控」为核心标签的Anthropic而言,能否在这两个维度上有所突破,将直接影响其在专业用户群体中的口碑与竞争地位。
一个来自社区的期待清单
Anthropic 的 Claude 系列模型每一次迭代都能引发用户社区的热烈讨论。近期在 Reddit 上,一条关于「如果 Opus 5.5 今天发布,你最希望它带来哪些改进」的帖子引起了关注。发帖者提出了两个核心诉求:回归更接近人类的写作风格,以及在长时间运行任务中保持更好的目标专注度。
这两个诉求看似简单,却精准戳中了当前大语言模型在实际使用中的两个痛点。它们不是关于参数规模或跑分成绩的抽象讨论,而是来自真实使用场景的反馈。
写作质量:从「词语堆砌」回归人味
发帖者用了一个相当直白的词——「word vomit」(词语呕吐)来形容当前模型的输出。这个略带调侃的表达,反映出一部分用户对模型写作风格的不满:文字冗长、辞藻堆砌,看似丰富却缺乏真正的人类表达质感。
这是一个值得深入的现象。随着模型在指令遵循和内容完整度上不断优化,输出往往变得更「安全」也更「啰嗦」——为了覆盖所有可能的角度,模型倾向于生成结构工整但缺乏灵气的文本。对于写作、创意类任务的用户来说,这种「万能但平庸」的风格反而是一种退步。
用户期待的「human-like writing」,本质上是希望模型能够克制、精准,懂得留白,而不是把每个要点都展开成一段。这对模型的训练目标提出了更高要求:如何在保证信息准确的同时,保留表达的节奏感和个性。
长任务中的目标专注度
第二个诉求关于「long-running tasks」中的目标专注。这直指当前 AI Agent 和长上下文应用的核心挑战之一。
当模型执行一个需要多步骤、长时间的复杂任务时,很容易出现「目标漂移」——随着对话或推理链条的延长,模型逐渐偏离最初的核心目标,或者在细节上过度纠缠而忽略了整体方向。这在编程辅助、复杂研究、多轮 Agent 任务中尤为明显。
用户希望 Opus 5.5 能在这方面有所突破,即在长程任务中始终「记得」自己要做什么,保持行动的连贯性和目的性。这不仅是上下文窗口大小的问题,更关乎模型对任务优先级的理解和维持能力。
「目标漂移」现象在技术层面有其根源。大语言模型本质上是逐token预测的系统,随着上下文窗口的填充,早期的指令和目标在注意力机制中所占的权重会相对稀释,模型更容易被近端的上下文所主导。这与人类工作记忆的局限有相似之处,但机制不同——人类可以通过元认知主动拉回注意力,而模型缺乏这种自我监控能力。研究者们正在探索多种解决路径,包括周期性的目标重申(goal re-anchoring)、层级化任务规划(hierarchical planning)、以及在 Agent 框架中引入显式的「任务状态追踪」模块。目前主流的 Agent 框架如 LangGraph 和 AutoGen 都在架构层面尝试缓解这一问题,但模型本身对长程目标的原生理解能力仍是瓶颈。
这些期待背后的行业信号
虽然这只是一条社区讨论帖,但它折射出用户对大模型的评价标准正在发生变化。当基础能力(如知识覆盖、代码生成)逐渐趋于饱和,用户开始更关注使用体验的细腻度——写作的自然度、长任务的可靠性、输出的克制与精准。
换句话说,模型竞争的下半场,可能不再单纯比拼「能做什么」,而是比拼「做得是否得体、是否可控」。写作风格的人味和任务执行的专注度,恰恰是这类难以用跑分量化、却直接影响日常使用感受的维度。
对于 Anthropic 而言,Claude 系列一直以「对齐」和「可控」著称,如果未来的版本能在这两个用户呼声最高的方向上有所回应,无疑会进一步巩固其在专业用户群体中的口碑。
这种评价标准的转变在 AI 产品领域有更广泛的背景。业界将模型能力划分为「涌现能力」(emergent capabilities,如复杂推理、代码生成)和「对齐能力」(alignment,如遵循人类偏好、输出风格适配)两个维度。早期大模型竞争主要聚焦于前者——通过参数量和训练数据的扩张来解锁新能力。但随着主流模型在核心任务上的表现趋于收敛,对齐能力的差异化越来越成为产品竞争力的关键。写作风格的自然度、输出的克制度,这些特质正是 RLHF(基于人类反馈的强化学习)和 Constitutional AI 等对齐技术重点优化的方向。Anthropic 在这一赛道上的积累,使其理论上具备回应上述用户诉求的技术基础。
结语
这条 Reddit 帖子虽短,却是一份颇具代表性的用户心声:人们不再满足于模型「什么都会」,而是希望它「会得恰到好处」。写作的人味、长任务的专注,这些看似朴素的期待,或许正是下一代模型真正需要攻克的方向。
相关推荐
寄生弹定理:AI自修流水线为何永远修不好自己
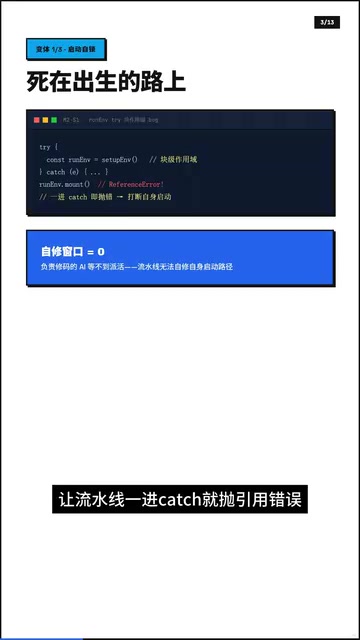
AI流水线自己修自己却永远起不来?本文拆解「寄生弹定理」的三个真实死区变体——启动路径自锁、ESM缓存冻结、验证延迟排队,并给出载体分离、语义幂等、诚实披露三条破局原则和当天可用的实操动作。
Cherry Studio + MCP 实战:搭建本地知识库与自动化AI智能体
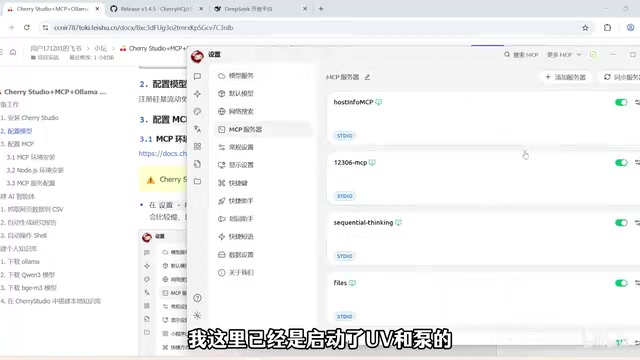
本文详解如何用开源客户端 Cherry Studio 结合 MCP 协议和 Ollama,搭建自动化 AI 智能体与本地知识库,涵盖 DeepSeek 模型配置、UV/Bun 环境、Function Call 限制及网页抓取、Shell 控制等实战场景。
五角大楼承认AI过度依赖酿祸:误袭伊朗学校事件警示
五角大楼承认AI过度依赖酿祸:误袭伊朗学校事件警示
五角大楼承认对AI系统的过度依赖是误袭伊朗某学校事件的重要原因,本文剖析军事AI在目标识别、人在回路机制与问责难题上的深层风险及其对AI部署的普遍启示。