用户如何看待生成式AI?1.7万条应用商店评论揭示信任裂痕
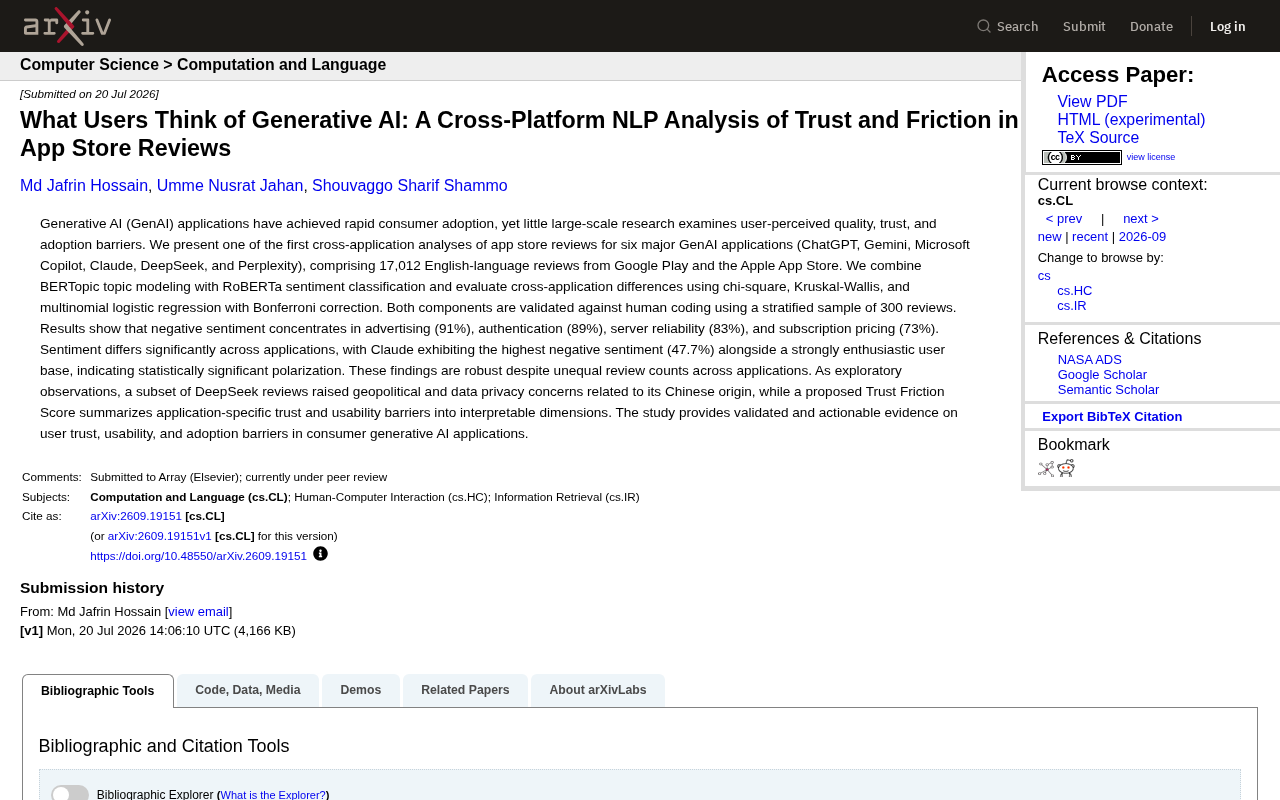
17,012条评论揭示:GenAI用户的不满集中在广告、认证和服务稳定性,而非模型能力本身。
这项针对六款主流生成式AI应用(ChatGPT、Gemini、Copilot、Claude、DeepSeek、Perplexity)的大规模评论分析,综合运用BERTopic主题建模与RoBERTa情感分类,系统刻画了消费用户的真实体验图景。研究最核心的发现是:用户负面情绪高度集中于广告(91%负面)、身份认证(89%)、服务器可靠性(83%)和订阅定价(73%)这四大摩擦点,而非模型的智能水平。Claude呈现统计显著的两极分化——最高负面比例(47.7%)与狂热忠实用户并存。DeepSeek则因中国背景引发地缘政治与数据隐私的探索性担忧。研究还提出"信任摩擦分数"框架,将零散的用户抱怨转化为可量化比较的维度,为产品优化提供可操作的优先级依据。
生成式AI应用在消费市场的普及速度令人瞩目,但用户真正满意吗?一项跨平台的大规模研究给出了迄今为止最系统的答案。研究者分析了来自Google Play和苹果App Store的17,012条英文评论,覆盖ChatGPT、Gemini、Microsoft Copilot、Claude、DeepSeek和Perplexity六款主流GenAI应用,用自然语言处理方法勾勒出用户信任与摩擦的真实图景。
研究方法:NLP + 人工校验的双重保障
这项研究并非简单的情绪统计,而是构建了一套可复现的分析流程。研究团队将BERTopic主题建模与RoBERTa情感分类相结合,前者负责从海量评论中自动提取讨论主题,后者对每条评论的情感极性进行判定。
为了避免机器判断的偏差,研究者采用分层抽样选取300条评论进行人工编码验证,确保主题识别和情感分类的结果与人类判断一致。这种"机器规模 + 人工校验"的组合,让结论比单纯依赖算法的分析更可信。
在统计层面,团队使用了卡方检验、Kruskal-Wallis检验以及带Bonferroni校正的多项逻辑回归,来检验不同应用之间的差异是否具有统计学意义。这意味着文中提到的应用间差异并非偶然,而是经得起严格统计推敲的。
BERTopic是一种基于Transformer嵌入的主题建模方法,与传统的LDA(隐含狄利克雷分配)相比,它能更好地捕捉语义相近但措辞不同的讨论,并可自动确定主题数量,无需人工预设。RoBERTa(Robustly Optimized BERT Pretraining Approach)则是Facebook AI在BERT基础上优化训练的语言模型,在情感分类等下游任务中表现出色,尤其擅长处理口语化、非正式的用户评论文本。两者结合意味着:BERTopic解决"用户在聊什么",RoBERTa解决"用户对此持什么态度",形成主题与情感的双维分析。Bonferroni校正则是多重比较中的常见方法——当同时对多个假设进行检验时,随机出现显著结果的概率会虚高,Bonferroni校正通过将显著性阈值按检验次数等比例收紧,来控制整体犯错概率,使跨应用比较的结论更为保守可靠。
负面情绪集中在哪里?
研究最直接的发现是:用户的不满高度集中在几个特定领域,而非模型能力本身。
- 广告(91%负面):这是负面情绪最集中的话题,用户对应用内广告的容忍度极低。
- 身份认证(89%负面):登录、账号验证等环节的糟糕体验,成为高频吐槽点。
- 服务器可靠性(83%负面):卡顿、宕机、响应失败等稳定性问题严重影响体验。
- 订阅定价(73%负面):付费墙和订阅模式引发大量抱怨。
值得深思的是,这些痛点几乎都与产品的工程实现和商业化策略相关,而不是AI的"智能程度"。换句话说,用户对GenAI的能力普遍认可,真正的摩擦发生在体验与信任的边缘环节。这对产品团队是一个明确信号:模型再强,若登录流程繁琐、服务器频繁掉线、广告过多,用户依然会流失。
Claude的两极分化:最高负面与最狂热粉丝并存
跨应用比较揭示了一个有趣的现象。不同应用之间的情感差异具有显著统计学意义,其中Claude表现出最高的负面情绪比例(47.7%),但同时又拥有一批极其热情的忠实用户。
这种"又爱又恨"的两极分化,在统计上被明确识别为polarization(极化)。它说明Claude可能在某些方面做得极为出色,赢得核心用户的强烈拥护,但在另一些方面(如可用性、限制、定价)又让相当一部分用户感到失望。这种分化本身就是产品定位和用户群体特征的反映,比单纯的平均分更有洞察价值。
研究还强调,尽管各应用的评论数量并不均衡,这些结论依然稳健,不是由样本量差异造成的假象。
DeepSeek的地缘政治与隐私隐忧
作为探索性观察,研究者注意到DeepSeek的部分评论提出了与其中国背景相关的地缘政治和数据隐私担忧。
这是一个颇具现实意味的发现。它表明用户对GenAI应用的信任评估,已经超越了功能层面,延伸到数据主权、隐私政策乃至应用来源国的层面。对于跨国运营的AI产品而言,"信任"不再只是技术问题,还牵涉到用户对背后主体的认知与顾虑。不过研究者谨慎地将其标注为探索性观察,提醒读者这部分结论的样本基础相对有限。
用户对AI应用数据归属与隐私的关注,折射出更广泛的"数据主权"议题。不同国家对数据存储、跨境传输和政府访问权限有各异的法律规定——欧盟的GDPR、美国的云法案(CLOUD Act)与中国的《数据安全法》《个人信息保护法》在域外管辖权上存在潜在冲突。普通用户未必熟悉这些法规细节,但对"数据会被谁看到"的直觉性担忧,已足以在评论中形成可识别的话语模式。这一现象并非DeepSeek独有——TikTok在多个国家面临的监管压力、Telegram在欧洲的合规争议,都是类似逻辑的体现。对AI产品而言,透明的隐私政策和可验证的数据处理承诺,正在从加分项变为基本准入门槛。
Trust Friction Score:把信任量化
研究提出了一个名为"信任摩擦分数"(Trust Friction Score)的概念,试图将各应用的信任与可用性障碍归纳为可解释的维度。
这一指标的意义在于,它把散落在成千上万条评论中的定性抱怨,转化为结构化、可比较的量化框架。产品团队可以据此定位自己在哪些维度上存在信任缺口,从而有针对性地改进。相比笼统的"用户满意度",这种分维度的摩擦刻画更具可操作性。
信任摩擦(Trust Friction)这一概念来自用户体验与行为经济学的交叉领域,指用户在使用产品过程中因不确定性、障碍或负面预期而产生的心理阻力。在AI产品语境下,信任摩擦不仅包括技术层面的失败(如服务中断、错误回答),还涵盖商业设计带来的疑虑(如数据使用方式不透明、付费墙设置不合理)以及身份与安全环节的摩擦(如繁琐的账号验证)。将其量化为可比较的分数,借鉴了产品体验领域"摩擦审计"的思路——即系统识别用户旅程中每一个可能导致流失或信任下降的节点,并赋予权重。对于AI应用而言,这一框架的价值在于将抽象的"用户信任"拆解为可归因、可追踪的具体维度,使产品改进有明确的优先级依据。
对行业的启示
这项研究是首批针对消费级GenAI应用做跨产品评论分析的工作之一,填补了一个明显的研究空白:此前少有大规模研究考察用户感知的质量、信任与采用障碍。
它给出的核心启示清晰而实用——决定用户去留的往往不是模型的绝对能力,而是围绕模型的体验工程与商业化设计。广告泛滥、认证繁琐、服务不稳、定价激进,这四大摩擦点几乎是所有GenAI产品需要共同面对的功课。而信任,正在成为AI产品竞争中一个越来越难以回避的核心变量。
相关推荐
AAAI-27第一阶段评审结果临近:投稿者需关注什么
AAAI-27第一阶段(Phase 1)评审结果预计9月24日公布,本文解读AAAI分阶段评审机制、投稿者应对策略以及学术社区在结果等待期的协作价值。
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。