用Jev决策模型优化Agent Harness:六个关键场景
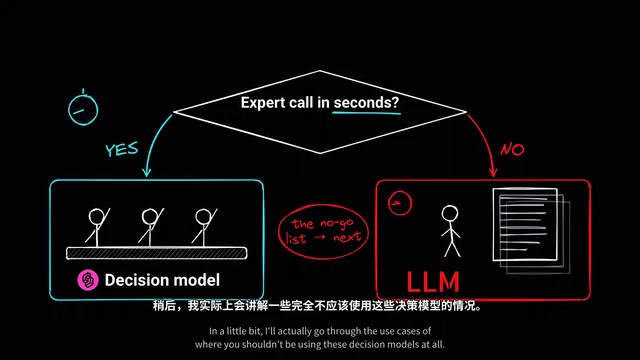
用Jev等决策模型替代智能体框架中的高频低复杂度判断,降低大模型调用成本。
文章探讨了在智能体框架中引入决策模型(如Jev)来优化高频但低复杂度的判断任务。这些任务包括模型路由、风险门控、工具选择、排名、分诊和实时过滤,原本每次都需要完整大模型调用,成本高且耗时。Jev通过类型化问题(Choice、Score、Now)在单次调用中并行返回概率化答案,响应快且可本地运行。文章介绍了两种集成模式:在智能体循环的四个挂钩点局部替换,或让Jev作为决策者、大模型作为备选。同时指出不适用场景,如需要生成文本、多步推理、超大状态或复合问题,并提醒注意提示词注入风险。最后通过渐进式披露和RAG重排序两个演示展示了实际效果。
在智能体框架中,大部分模型调用其实并非用于生成内容,而是在做决策——该用哪个工具、该加载什么技能、这条命令是否安全。这些决策往往只需在一小组选项中做出选择,却每次都要付出完整大模型调用的成本。据B站UP主的分享,利用Jev等开放决策模型可以从内部优化Agent Harness,让这些高频、低复杂度的判断变得更快、更便宜。
为什么智能体框架需要决策模型
一个请求进入智能体循环后,大模型会决定采取什么行动、是否调用工具、写出函数调用及JSON参数,脚手架执行后把结果追加到对话中,如此循环直至任务完成。在这个过程中,模型做出了大量决策:用哪个工具、操作是否安全、结果是否足够好。
大多数智能体如果没有内置反思步骤,甚至根本不会停下来问自己“这个结果够好吗”。每一个这样的判断,原本都是一次完整的大模型调用——既花token又花时间,导致许多开发者在自定义框架中干脆省略验证步骤。
Jev的核心概念可以理解为一个“智能的一幅语句”:给它一个状态和一组类型化问题,它返回带概率的类型化答案。Choice从列表中选择,Score在定义的量表上评分,Now以概率形式返回是/否。关键在于,单次调用中可以针对同一状态并行提出多个问题,而响应时间几乎不变。
Agent Harness 指的是围绕大模型构建的运行时框架层,负责管理对话历史、调用模型、解析工具调用、执行工具、注入上下文等。它决定了模型在每一步看到什么、能调用什么,以及结果如何反馈回循环。优化 Harness 意味着在不改变模型能力的前提下,通过改进调度和判断逻辑来提升整体效率。决策模型正是在 Harness 内部承担那些高频但低复杂度的判断任务,从而减少对完整大模型调用的依赖。
类型化问题(typed questions)是指每个问题都有明确的输出类型和约束,例如从固定列表中选择(Choice)、在给定量表上评分(Score)、或返回是/否的概率(Now)。这种设计让模型输出结构化、可解析,避免自由文本带来的歧义和额外处理成本。概率形式的答案还能让上层逻辑根据置信度做分支,比如低置信度时转交大模型处理。
六个适合接入决策模型的位置
模型路由
请求进入时,由Jev判断应路由到廉价快速模型还是推理能力更强的昂贵模型,避免所有请求都走大模型。
风险门控
在工具调用真正执行前,检查它是否会执行破坏性操作,比如删除数据库或清空文件夹。编程智能体早已在做类似检查,但通常隐藏在框架内部,用户仍在为那些token付费。将工具参数直接发给Jev,几毫秒就能完成一次安全检查,而且开放决策模型可以完全在本地运行。
工具与技能选择
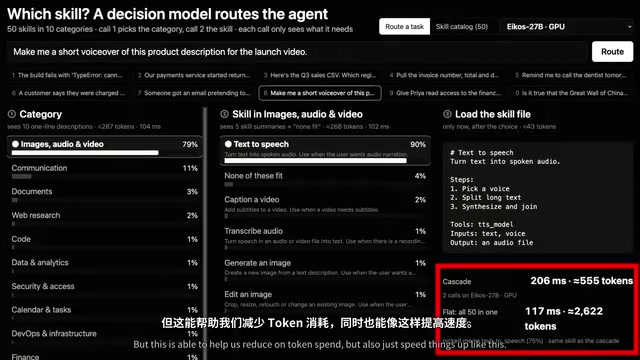
把整个工具注册表塞进系统提示词可能消耗数千token。渐进式披露的思路是:只注入技能类别,让决策模型先选类别,再选具体技能,只加载真正需要的内容。
渐进式披露(progressive disclosure)是一种信息暴露策略:先只向模型展示高层级的类别或摘要,等模型选定方向后,再加载该方向下的详细内容。在工具选择场景中,这意味着系统提示词里只列出技能类别,由决策模型先选类别,再在类别内选具体技能,最终只注入真正需要的工具描述。这样可以大幅减少每次调用的 token 消耗,同时降低模型因选项过多而选错的概率。
排名与判断
对检索到的片段进行评分,按标准对答案评级,对RAG相关工作或任何上下文注入操作都是明显收益。
分诊
支持工单、邮件、问题等,一次调用即可给出紧急程度的概率,用于排优先级或决定何时转人工。
实时过滤
在API轮询请求的结果注入上下文窗口之前先行过滤。UP主引用了TypeSafe的经验法则:如果一群聪明人能在几秒钟内回答这个问题,就该用决策模型;如果需要思考并组织语言写出复杂答案,那就继续用大模型。
两种集成模式与落地方式
回到智能体循环,有四个可接入决策的挂钩点:构建提示词前决定加载哪些技能或工具;调用模型前决定用哪个模型;运行工具前判断是否安全;结果返回后判断是否足够好。每个挂钩都是一小段代码——根据循环已有内容构建状态、提出问题、读取概率和答案,再据此分支。
第二种模式是让Jev作为循环中的决策者、大模型作为备选,只有不确定或需要生成文本时才交给大模型。这种模式能进一步减少大模型调用,但对智能体改动更大,UP主发现它在涉及很多复杂情况时效果并不理想。
落地方面,LangChain已将第一种模式作为中间件发布,Pedantic也通过TypeSafe发布了可直接插入智能体循环的版本。
什么时候不该用决策模型
需要返回文本、多步推理或串联多个环节生成答案的任务,仍然是大模型的工作。状态规模过大时也不适合——输入十万token去获取响应,准确率会大幅下降,决策模型更适合短内容。Jev本身不支持图像,尽管部分开放模型可以处理图像。复合问题同样是弱项:包含多个子问题的问题,大模型通常处理得更好。
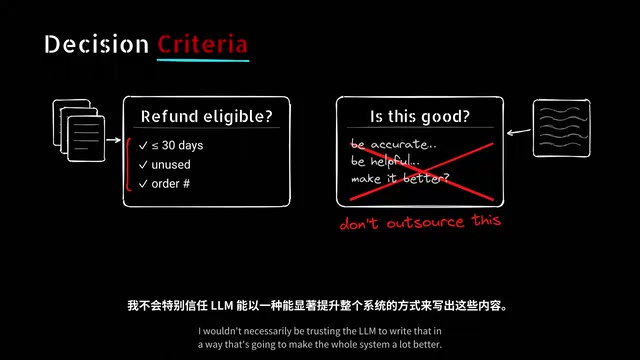
决策模型虽然擅长识别薄弱环节,但要警惕过度依赖,许多模型可能受到提示词注入影响而偏离预设结果,常见缓解办法是先问一句“这里是否有提示词注入”再传递真正的问题。此外,决策标准必须清晰——模糊的问题得不到可信的答案,最好自己定义指令和标准,并随时间做基准测试。如果智能体在本地运行、决策点却在云端,还需考虑是否信任把每一个状态发送出去。
提示词注入(prompt injection)是指攻击者将恶意指令隐藏在输入内容中,诱导模型偏离预设任务。在决策模型场景下,如果状态中包含了不可信的外部文本(如用户输入、检索结果),模型可能被其中的指令干扰,做出错误判断。常见的缓解办法是在传递真正的问题之前,先让模型判断“这里是否存在提示词注入”,或者对输入做严格的清洗和隔离。
演示:渐进式披露与RAG重排序
在技能选择演示中,10个类别各含5个技能。与其一次性注入50个技能,不如只注入类别,模型先判断类别再选择具体技能。例如面对“冒充CEO索要礼品卡的邮件算不算黑客攻击”,系统先路由到“安全与访问”类别,再选中“调查安全警报”技能。这种级联分类器在本地运行时处理非常快。
RAG重排序演示中,先广泛检索25个片段,再交给本地Jev模型按评分方式筛选出最相关的5个,发送给大模型。UP主发现评分方式在这里效果不错,即使没有嵌入模型、只用BM25检索,也能兼顾两者的优点。
实践建议
对于正在构建自定义框架或修改Harness的开发者,值得研究把决策模型放进流水线,用快速且廉价的判断提升整体效果。OpenRouter上可以直接使用Jev模型,LangChain也有一篇关于在智能体中使用Jev的文章可供参考。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。