用M|BOX和Python为AI Agent打造毫秒级身份解析
用M|BOX Python SDK为OpenAI Agent构建确定性CRM身份解析工具,兼顾容错、评分与防幻觉。
文章基于一段YouTube教程,完整复现了如何用M|BOX Python SDK为OpenAI Agent构建确定性的客户身份解析工具。核心思路是把身份匹配封装成普通Python函数resolveCustomer,由M|BOX在first name、last name、company、city四个字段上建立索引并执行字段级评分,LLM只负责对话与追问。教程展示了万条记录低于0.2秒建索引、单次查询仅数毫秒的性能,以及空字符串排除未知字段、返回多候选、docstring自动转JSON schema等适配Agent工作流的设计。三个实战场景分别验证了拼写差异下仍能匹配、记录冲突时Agent主动追问、查无此人时返回零候选拒绝幻觉。最终结论是职责分离:确定性工具负责匹配,对话模型负责引导。
大语言模型擅长理解用户意图,却从未见过你内部的CRM系统。当来电者说"我是Orion公司的Elizabeth Turner"时,标准LLM只能猜测她是谁。本文基于一段YouTube教程,完整复现如何用M|BOX Python SDK为OpenAI Agent构建确定性的客户身份解析工具——容忍真实世界的拼写错误与缩写,同时追踪搜索性能,并让Agent在记录冲突时主动追问、在查无此人时拒绝幻觉。
为什么LLM需要外挂身份解析
LLM的核心能力是语言理解,而不是精确数据检索。把CRM查询交给模型"凭记忆"回答,结果必然是幻觉或猜测。教程给出的方案是:把身份解析逻辑封装成一个确定性的Python工具,交给Agent调用。模型负责对话与追问,M|BOX负责匹配与评分,职责边界清晰。
这个架构要解决两个隐藏挑战。第一,数据集中存在两个完全不同的Robert Hayes,一个在Vultra International,另一个在Lumio Solutions,仅凭姓名无法区分。第二,Elizabeth Turner在数据库里拼作Z,而来电者常拼成S。教程因此要求搜索覆盖first name、last name、company、city四个字段。
确定性实体解析(Deterministic Entity Resolution) 指在给定输入和固定规则下,系统对身份记录进行匹配时始终产生相同、可复现的结果,不依赖概率采样或近似最近邻的随机性。与之相对,LLM 的生成过程本身带有温度采样,向量检索也可能因索引结构返回近似而非精确的邻居。在 CRM 身份解析场景中,确定性意味着:同一组姓名、公司、城市输入,无论调用多少次、在哪个会话中,都应得到相同的候选列表与评分;低于阈值时系统明确返回“无匹配”,而不是“最相似的一条”。这种特性让 Agent 的后续决策(是否追问、是否透露邮箱)建立在可审计、可测试的基础上,也使得字段级评分可以被直接写入提示词作为硬性条件。
建立索引:万条记录低于0.2秒
教程加载了10,000条客户记录,字段包括customer ID、姓名、公司、城市和联系方式。使用tableindexer.createindex在这四个字段上创建索引,并用time.perfcounter记录耗时。结果是M|BOX在不到五分之一秒内完成全部10,000条记录的索引,教程称之为"sub-millisecond indexing",意味着把确定性实体解析接入Agent管道几乎不增加启动开销。
调用index.describe可以看到M|BOX如何为每列生成schema:first name、last name、city这类单词属性成为term字段,company这类多词名称成为phrase字段,而customer ID和email被归类为不可搜索——它们不能被直接查询,但会随每次匹配结果一并返回。
term 字段与 phrase 字段 是 M|BOX 索引 schema 中对文本列做的两种基础归类。term 字段针对单个词项(如 first name、last name、city),匹配时按词元进行比较,适合容忍拼写差异和缩写;phrase 字段针对多词名称(如 company),匹配时考虑词序和整体短语结构,避免把“International”和“Solutions”这类通用词错误地跨公司拼接。customer ID 和 email 被归为不可搜索字段,是因为它们作为标识符不具备模糊匹配的语义价值,但会作为返回载荷随候选记录一并带回,供 Agent 展示或后续操作使用。理解这种字段类型划分,有助于在设计索引时决定哪些列参与评分、哪些列只做透传。
编写resolveCustomer工具函数
教程定义了一个普通Python函数resolveCustomer,接受first name、last name、company、city四个参数,内部调用index.match拉取前三个候选及其字段级评分,并记录毫秒级搜索耗时。函数返回每个候选的customer ID、姓名、公司、城市、邮箱、总分与字段分项。
这个函数有几个为Agent工作流量身定制的设计。类型提示和docstring是功能性代码,Agent SDK会直接解析它们来构建工具定义。传入空字符串表示该字段未知,M|BOX会将其排除在总分计算之外,因此没提供城市的来电者不会被扣分。返回最多三个候选而非一个,让Agent在两条记录打平时有判断依据。字段级评分则替代了不透明的向量相似度,让模型清楚知道哪些属性匹配、哪些存在拼写错误。
先用带拼写错误的数据直接测试:搜索Catherine Vos at Kestrel Manufacturing,姓氏和公司名都故意拼错,城市留空。几毫秒内就匹配到Kestrel,Catherine Vos总分76,分项清晰:first name满分100,company即使缺字母仍有90,last name因为三字母单词缺一个字母只拿到39,city因留空计0但不扣分。
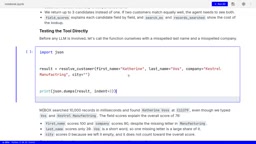
字段级评分(Field-level Scoring) 指匹配结果不仅给出一个总分,还按 first name、last name、company、city 等字段分别输出相似度分数。与整体向量相似度相比,字段级评分把“为什么匹配”拆解为可读的分项:例如姓氏因三字母单词缺一个字母只得 39 分,公司名缺字母仍有 90 分,城市未提供则计 0 但不扣总分。这种粒度让 Agent 能够判断冲突究竟来自拼写噪声还是真实歧义,也让人工调试时可以定位是哪个字段拖低了分数。在提示词中,字段分项还可以作为条件判断的依据,例如要求“姓氏分数低于 50 时必须追问”。
把工具交给Agent:用提示词设置安全护栏
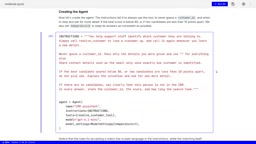
教程用SDK的function tool包装resolveCustomer,SDK自动从docstring生成完整的JSON schema,每个参数都成为string属性,描述直接来自docstring的args块。这正是模型知道"未提及的信息传空字符串"的原因。
Agent的系统指令要求:始终调用resolveCustomer、绝不猜测customer ID、当最高分低于80或两个候选分差小于10分时必须暂停并追问更多细节。模型temperature设为0以保证确定性推理。教程强调,匹配规则用自然语言写在提示词里,身份解析逻辑在M|BOX中确定性运行,模型决定问什么、怎么对话,却从不决定一条记录是否匹配。
三个实战场景验证
拼写差异场景:询问Orion Systems的Elizabeth Turner(S拼法)在Frankfurt的信息。Agent以Elizabeth、Turner、Orion、Frankfurt调用工具,成功匹配到数据库中以Z拼写的Elizabeth Turner,customer ID c17505,得分92。M|BOX搜索约3毫秒,而整个Agent运行耗时数秒——几乎全部时间花在等待模型生成token上。
记录冲突场景:询问Robert Hayes的邮箱但不提供公司或城市。两条Robert Hayes记录都以100分返回,Agent遵守护栏指令,隐瞒邮箱,说明有一位在Vultra International、一位在Lumio Solutions,并请求澄清。随后用户补充"他在Lumio工作",并传入result.to_input_list()保持对话上下文,搜索缩小为单一候选customer ID C18851,得分97——因为Lumio只是Lumio Solutions的一部分——Agent才放出邮箱。教程指出,若在此猜测,就可能把一位客户的隐私泄露给另一位。
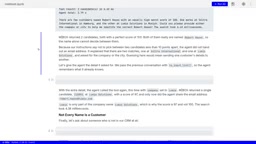
查无此人场景:询问Brightwave Corporation的Laura Chen。工具返回零候选,Agent没有幻觉,而是明确报告Laura Chen不在CRM中。Brightwave确实是CRM里的真实公司,但没有叫Laura Chen的人,记录分数都不够格。教程特别对比了向量最近邻搜索——后者永远会返回点什么,而M|BOX在数据不够接近时绝不强行匹配,这种确定性诚实直接传导给Agent。
架构启示
这套方案的价值不在于某个API调用,而在于职责划分:M|BOX处理确定性匹配,模型负责对话引导。字段级评分提供了可解释性,让Agent不仅拿到记录,还拿到"为什么匹配"的推理依据;而分差阈值这类数学规则可以直接写进提示词,成为Agent的硬性护栏。对于任何需要把内部数据接入Agent的场景,这种"确定性工具+对话模型"的组合都值得借鉴。
相关推荐
腾讯喵影Agent实测:一张画布搞定AI视频全流程
B站UP主实测腾讯喵影Agent:输入一个想法,Agent自动生成故事卡、角色卡、分镜卡并批量生成视频,画布内完成剪辑导出,全流程不切换软件。
WorkBuddy零基础入门:桌面Agent如何把AI变成执行者
WorkBuddy零基础教程:解析这款桌面AI Agent如何操作本地文件完成办公任务,对比Codex的适用场景与学习成本,并梳理三个常见认知误区与积分省钱技巧。
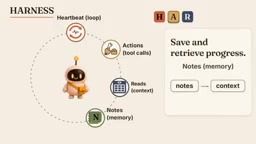
Harness工程:同一模型得分翻三倍的秘密
Harness工程是AI代理开发的核心:同一模型因外围代码不同得分从13.3%升至38.3%。本文拆解harness的七个组件——循环、动作、上下文、记忆、权限、验证与可观测性,并给出以退款代理为例的实战方法与改进路径。