用n8n打造AI第二大脑:Agent+记忆+向量库实战

用 n8n 搭建自托管 AI 第二大脑,集成 Telegram、Notion、Qdrant 与 Gmail。
本文介绍了一套基于 n8n 的自托管 AI 第二大脑方案,由三个协同工作流组成:主工作流接收 Telegram 消息并路由给 AI Agent,知识摄入工作流负责结构化抽取并写入 Notion 与 Qdrant,邮件工作流定时轮询 Gmail 并处理附件。文章详细讲解了自托管部署、ngrok 回调配置、三种消息格式归一、Agent 记忆与工具配置、Notion 字段映射、向量库索引以及邮件通道的实操细节,并总结了工作流分工与可替换性的设计价值。
用n8n打造AI第二大脑:Agent+记忆+向量库实战
第二大脑和个人助手的区别在哪里?前者更像一个持续吸收、可检索的外部记忆体,而后者偏向即时对话。YouTube 频道 NeuralNine 的这期 n8n 教程,演示了一套可自托管、可替换组件的第二大脑搭建方案:Telegram 作为输入入口,Notion 作为结构化存储,Qdrant 作为向量库,AI Agent 负责路由与工具调用。
需要说明的是,n8n 是该视频的赞助方,教程使用本地自托管版本,所有工作流都可按需替换成 Slack、WhatsApp 等渠道。
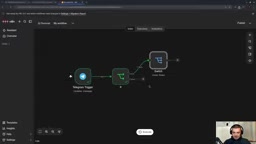
整体架构:三个工作流协同
这套方案拆成三个互相调用的工作流,而不是一个巨型流程。
主工作流接收 Telegram 消息,先校验发送者 ID 是否为本人,再按内容类型分流为语音、纯文本、图片加文本三条分支,统一成同一数据格式后交给 AI Agent。Agent 挂载了 OpenAI 聊天模型、Simple Memory 记忆、Qdrant 向量库检索、Gmail 搜索、Google Calendar 查询,以及调用第二个工作流的工具。最终总是通过 Telegram 文本消息回复。
知识摄入工作流由其他工作流调用触发,负责结构化抽取、写入 Notion、向量化索引。
邮件工作流按计划定时运行,抓取带特定标签的 Gmail 邮件,处理附件并上传 Google Drive,再调用摄入工作流,最后移除标签避免重复处理。
Qdrant 是一个开源的向量数据库,专门用于存储和检索高维向量(即 embedding)。在本方案中,每一条知识内容(如笔记、链接、邮件)都会先通过 OpenAI 的 embedding 模型转换成一个 1536 维的向量,然后存入 Qdrant。当 Agent 需要回答“我存了哪些链接”这类问题时,会先把问题也转成向量,再在 Qdrant 中做相似度搜索,找出最相关的若干条历史记录作为上下文。与传统的全文检索不同,向量检索能理解语义近似,即使用户的提问和原文用词不同,也能召回相关内容。Qdrant 支持自托管(Docker 部署),数据完全本地可控,适合第二大脑这种隐私敏感的场景。
自托管部署与回调地址配置
安装只需在 n8n.io 文档页复制一行 curl 命令,脚本会自动检测 Docker 与 Docker Compose 并启动服务,默认运行在 localhost:5678。
关键在于 Google 服务需要回调 URL,localhost 不可用。教程推荐用 ngrok 建立公网隧道(Cloudflare Tunnel 亦可),把公网地址写入 ~/.n8n 配置文件的 webhook URL 项。
这里有个容易踩的坑:修改 .env 后执行 docker compose restart 并不会重新加载配置,必须 docker compose down 再 docker compose up -d。教程演示时正因为这个细节,Telegram 触发一度失效。
同时在 docker-compose.yml 里额外挂载一个 Qdrant 服务和对应数据卷,作为向量存储,其余保持默认。
输入分流:让三种消息格式归一
Telegram 传来的是文本、图片还是语音,结构完全不同。教程用 Switch 节点做路由:
- 存在
file_id字段判为语音,走 Telegram 取文件节点; - 文本字段非空判为纯文本;
- 用表达式返回
photo或空字符串作为图片分支的判断依据。
语音分支有个细节:Telegram 返回的文件后缀是 oga,而 OpenAI 转录接口拒绝该格式,需要用一段 JavaScript 把 oga 替换成 ogg,再用 OpenAI 转录节点转成文字。图片分支则取最后一张照片的 file_id,并处理 caption 可能为空的情况——为空时给模型一个默认提示词。
三条分支最终通过 Merge 节点合并,再用代码节点把图片的二进制数据附加到同一 item 上,形成统一的 text 加可选 image 结构。
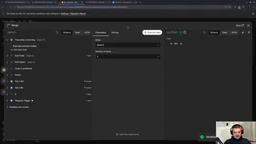
Agent 的记忆与工具配置
Agent 的 prompt 直接取合并后的 text 字段,系统提示词里注入当前日期表达式,并说明角色:收到内容就捕获,收到补充说明就追加,必要时去查日历。
记忆用 Simple Memory,session ID 绑定 Telegram 的 chat ID,相同会话的后续消息能带入上下文,上下文窗口长度设为 20。这样「帮我存一下 youtube.com」之后追问「我存了哪些链接」才有意义。
据视频演示,添加 Qdrant 检索工具后,Agent 能回答出全部已保存的链接;而没有向量库时,它只能看到当前对话里的最后一条。这是第二大脑和普通聊天机器人的分水岭。
Simple Memory 是 n8n 中一个轻量的对话记忆节点,它并不依赖外部数据库,而是将历史消息保存在工作流的内存中(或通过 n8n 的持久化机制临时存储),并以 session ID 作为分组键。每个 session ID 对应一段独立的对话上下文,节点会维护一个固定长度的消息窗口(本例中为 20 条),超出部分自动丢弃。这样设计的好处是无需额外配置数据库,适合个人自托管场景;局限在于记忆不会跨工作流或跨设备同步,且重启 n8n 后可能丢失。对于需要长期记忆的知识,仍然依赖 Qdrant 向量库来持久化存储和检索,Simple Memory 只负责维持当前会话的连贯性。
结构化摄入:从杂乱文本到 Notion 字段
摄入工作流的第一步是结构化输出抽取。Notion 数据库预先定义了字段:type(可选值 note、idea、insight、quote、link、email)、tags、source、url、author、files。抽取节点的属性描述必须与这些字段类型严格对应,比如 type 的描述直接写成「exactly one of these words」加枚举列表。
随后用 Notion 节点创建 database page,各属性通过 $json.output.* 表达式映射。这里遇到过一个真实报错:url 和 author 为空时请求返回 bad request,解决办法是让这两个可选字段在缺失时返回空字符串而不是 null。
页面创建后,同一份内容还要写进 Qdrant。集合配置的向量维度设为 1536,对应所选 embedding 模型的输出维度。正文按 2000 字符切块(Notion 文本块的长度限制),逐块用 append block 追加到页面。
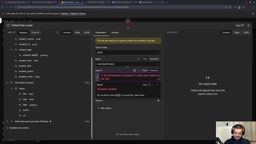
最后返回 saved、title、type、notion_url 四个字段给调用方,主工作流的 Agent 便能把 Notion 链接回传给用户。
结构化输出抽取指的是让大语言模型按照预先定义的 JSON Schema 或字段描述,从自由文本中提取出结构化的信息。在本方案中,Notion 数据库的每个字段(type、tags、source 等)都有明确的类型和可选值,抽取节点的属性描述必须与这些定义严格对应,例如 type 字段的描述写成“exactly one of these words”并列出枚举值。这样模型输出的结果才能直接被 Notion 节点映射,避免类型不匹配或缺失值导致的 API 报错。这种做法的核心是把“非结构化输入”转化为“结构化数据”,是构建可检索知识库的关键一步。需要注意的是,字段描述越精确,模型抽取的准确率越高,但也要为可选字段预留空字符串的兜底逻辑。
邮件通道:定时轮询与附件处理
邮件工作流用 Schedule Trigger 每 15 分钟跑一次,配好 Gmail 的标签过滤。教程的做法是在 Gmail 里创建过滤器:发往「你的邮箱+brain@gmail.com」的邮件自动打上标签,再让 n8n 按标签抓取。
Gmail 节点有个坑:默认开启 simplify 时不会下载附件,必须关掉并显式开启 download attachments 选项,否则后续判断附件是否存在的逻辑永远为假。
流程在一个 Loop 节点里循环:有附件则提取文件列表上传 Google Drive,用 aggregate 节点汇总分享链接;无附件则给一个空数组。两条分支合并后拼接出 content 和 files 字段,调用摄入工作流,最后用 Gmail 节点移除标签,回到循环开头,直到没有带标签的邮件为止。
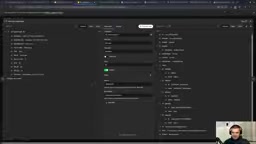
Google 侧需要一次性完成三件事:在 Google Cloud 项目里启用 Gmail、Calendar、Drive 三个 API;配置 OAuth 同意屏幕并把测试账号加入 test users(否则未发布应用无法授权);创建 Web 应用类型的 OAuth 客户端,授权重定向 URI 填 {ngrok地址}/rest/oauth2-credential/callback。同一套 client ID 和 secret 在 Gmail、Drive、Calendar 三个节点里复用,但每个服务都要单独走一次授权流程。
Gmail 的标签过滤配合 n8n 的 Schedule Trigger 实现了一种“拉取式”的邮件摄入机制。具体做法是在 Gmail 中创建过滤器:当邮件发送到“你的邮箱+brain@gmail.com”这种带加号的别名地址时,自动打上指定标签。n8n 每 15 分钟按标签搜索一次,只处理带标签的邮件,处理完后移除标签,从而避免重复摄入。这种设计把“触发”交给邮件系统,n8n 只负责轮询,降低了实时性要求,也避免了 webhook 的复杂配置。加号别名是 Gmail 的原生特性,同一收件箱可以衍生出无限多个别名,方便按来源分类。对于其他邮件服务商,可能需要改用 IMAP 轮询或规则转发来实现类似效果。
这套方案值得借鉴的地方
教程明确说这不是一个打磨好的成品,而是演示如何自己搭建。真正有价值的是它的分工方式:主工作流只做路由与对话,摄入逻辑独立成可复用子工作流,邮件通道独立调度。三者通过 workflow ID 互相调用,任何一环都能单独替换——把 Notion 换成别的数据库、把 Qdrant 换成其他向量库、把 Telegram 换成 Slack,改动都局限在单点。
另外一个实用经验是学习路径:作者建议先手动搭一遍再考虑用 n8n 内置的 AI 助手生成工作流,否则出了问题不知道哪里错了。
视频还演示了用图片保存名言的场景:发送一张带引文的图片并说「保存这句」,Agent 会识别图片内容、抽取为 quote 类型写入 Notion。系统提示词注入当前日期后,日历查询也能正确解析「11 月 12 日有什么安排」这类相对时间表达。
对于想把个人知识管理自动化的开发者,这套结构提供了一个足够清晰的起点,剩下的就是按自己的使用习惯去增删工具。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。